Une entreprise en série B recrute sa première GTM engineer. Elle est douée. En quatorze mois, elle livre l'assignation des leads, une cascade d'enrichissement, une alerte Slack pour les comptes à forte intention et une tâche nocturne qui rapproche l'usage produit du CRM. Puis elle accepte une meilleure offre. Trois semaines plus tard, les leads entrants ne sont plus assignés. L'équipe met quatre jours à comprendre pourquoi : le workflow qui écrivait Lead.OwnerId tournait sous son compte personnel dans un outil d'automatisation, authentifié avec sa clé d'API, et la clé a été révoquée quand l'informatique a désactivé son accès. Personne d'autre ne savait que ce workflow existait, et encore moins lesquels des quatre-vingts autres en dépendaient.
Non loin de là, une entreprise comparable a pris l'autre chemin et acheté une plateforme de revenus intégrant l'assignation, les séquences et le scoring. Le déploiement s'est bien passé. Onze mois plus tard, la plateforme applique une règle de rapprochement lead-compte qui contredit celle du CRM, les objets personnalisés n'ont jamais été synchronisés, et une responsable RevOps passe ses vendredis à exporter des CSV pour répondre à des questions auxquelles la plateforme devait répondre. Aucune des deux n'a fait un mauvais recrutement ni acheté un mauvais outil. Toutes deux ont pris une décision d'architecture sans s'en rendre compte.
La demande pour ce travail ne fait pas débat. L'analyse de Bloomberry de 2026 portant sur ces mêmes 1 000 offres a conclu que, par leurs responsabilités, les postes de GTM engineering et de RevOps sont en grande partie le même métier, avec davantage d'accent sur l'automatisation et l'intégration. Ce qui reste à trancher, c'est le modèle opérationnel. La plupart des entreprises le posent comme une question de recrutement, ce qui masque les deux décisions qui déterminent si la fonction marche. La première : quelles couches du stack de revenus posséder et lesquelles louer. La seconde : qui détient l'état de chaque processus automatisé (les identifiants, les règles d'écriture dans les champs, la logique de relance et les journaux) quand la personne qui l'a construit n'est plus là.
Traitée comme un problème de systèmes, la question rend les trois options comparables. Recruter, c'est embaucher en interne et posséder chaque couche. Acheter, c'est prendre une plateforme sous licence et accepter son modèle de données. Intégrer, c'est faire venir une équipe de forward-deployed engineering qui diagnostique d'abord, construit au sein de votre stack existant et remet des systèmes que votre équipe peut exploiter. Chacune échoue de façon prévisible, et chaque défaillance désigne les objets qui cassent.
Là où ça casse
Chacun de ces modes de défaillance relève de l'architecture, c'est pourquoi un meilleur recrutement ou un meilleur outil les résout rarement.
Recruter : le stack à mainteneur unique
Une recrue interne avance vite parce qu'aucun processus ne la freine. Cette vitesse s'accumule sous forme d'état non documenté : des workflows créés sous un identifiant personnel, des clés d'API émises à un individu plutôt qu'à un compte de service, des colonnes d'enrichissement qui écrivent dans des champs du CRM dont personne d'autre ne sait qu'ils sont gérés, et des tâches planifiées qui n'existent que dans l'interface d'un outil. Le facteur bus de tout le moteur de revenus vaut un. Le Bureau des statistiques du travail des États-Unis a indiqué en septembre 2026 que l'ancienneté médiane chez l'employeur actuel était de 3,0 ans pour les 25-34 ans, la tranche d'âge de la plupart des premiers GTM engineers. Si le système ne survit pas à une démission, ce n'est pas un système.
Recruter : embaucher dans un stack que personne n'a diagnostiqué
Les données de Bloomberry montrent des offres demandant en moyenne 4,11 années d'expérience, SQL et Python figurant chacun dans 38 % des annonces. Les entreprises recrutent des ingénieurs. Puis elles les placent devant un CRM avec trois versions de chaque compte et aucun transfert horodaté, et les deux premiers trimestres passent à fusionner des doublons et à refaire des règles de validation. Sans diagnostic avant le recrutement, le poste est défini autour des symptômes, et l'ingénieur passe un an à découvrir ce qu'un audit en lecture seule aurait cartographié en quelques semaines. Nous avons développé cet argument dans le playbook du diagnostic avant la construction.
Acheter : la plateforme configurée pour la démo, pas pour votre modèle de données
Les plateformes arrivent avec un schéma imposé. La défaillance apparaît aux jointures : la logique de rapprochement des comptes du fournisseur contredit celle de votre CRM, des objets personnalisés comme Subscription__c ou une table d'usage produit ne font pas partie de la synchronisation, des mappages de champs bidirectionnels s'écrasent mutuellement, et les règles d'assignation de la plateforme vivent hors du CRM, là où votre administrateur ne peut pas les auditer. L'enquête Marketing Technology 2023 de Gartner a montré que les équipes marketing n'utilisaient qu'un tiers des capacités de leur stack, contre 58 % en 2020.
Acheter : supposer que le fournisseur porte l'apprentissage
L'argument le plus solide en faveur de l'achat vient de l'IA. L'étude 2025 du MIT NANDA, fondée sur 150 entretiens avec des dirigeants, une enquête auprès de 350 salariés et 300 déploiements publics, a montré que les outils achetés à des fournisseurs spécialisés réussissaient environ 67 % du temps, alors que les développements internes ne réussissaient qu'environ un tiers aussi souvent. La même recherche situe l'échec dans un déficit d'apprentissage : les outils génériques qui ne s'adaptent pas aux workflows de l'organisation stagnent. Acheter aide quand le fournisseur adapte l'outil à votre processus. Cela nuit quand votre processus doit se plier à l'outil, et le travail de configuration qui comble cet écart reste à faire par quelqu'un.
Intégrer : des missions sans limite ni transmission
Une équipe intégrée peut combler l'écart entre recruter et acheter, mais elle a son propre mode de défaillance. Sans diagnostic à périmètre fixe, le travail intégré devient du conseil sans fin, comme nous l'avons expliqué dans ce que le modèle forward-deployed de Palantir réussit et rate pour les équipes revenus. Sans contrat de transmission, elle recrée le problème du mainteneur unique au niveau d'un prestataire : la logique tourne dans les comptes du prestataire et les runbooks vivent dans sa tête.
Architecture de référence
La décision devient plus simple quand on cesse de choisir un modèle pour toute la fonction et qu'on en choisit un par couche. Chaque bloc ci-dessous indique les composants, des outils types (des exemples, pas des recommandations), le contrat de données transmis à la couche suivante et le modèle qui convient en général.
Composants : Formulaires web, événements produit, fournisseurs d'enrichissement et d'intention, activité d'agenda et d'e-mail, facturation.
Outils types : Créateurs de formulaires, un pipeline d'analyse produit, des fournisseurs d'enrichissement, le système de facturation.
Contrat avec la couche suivante : Chaque événement porte une source, un horodatage et un identifiant brut (e-mail, domaine ou ID de compte).
Meilleure option : Acheter. Les sources sont des produits standard, et construire son propre enrichissement est rarement rentable.
Composants : Clés de rapprochement, règles de fusion, champs obligatoires et validation à chaque point d'entrée, y compris les imports et les réécritures d'enrichissement.
Outils types : Règles natives de doublons du CRM, outils de dédoublonnage dédiés, un modèle d'identité dans l'entrepôt de données.
Contrat avec la couche suivante : Un seul ID canonique de compte et de contact, avec une règle documentée expliquant comment il a été résolu.
Meilleure option : La posséder, qu'elle soit construite en interne ou intégrée puis transmise. Votre logique de rapprochement encode votre activité, elle ne se loue donc pas.
Composants : Assignation, SLA, traitement des signaux, relances, chemins d'erreur, journalisation.
Outils types : Outils de workflows comme n8n ou Make, iPaaS, flows du CRM ou services sur mesure.
Contrat avec la couche suivante : Chaque action est idempotente, journalisée avec l'ID de l'enregistrement et exécutée sous un compte de service.
Meilleure option : Recruter ou intégrer. Cette couche détient l'état qui disparaît quand les personnes partent : elle doit donc tourner avec des identifiants de l'entreprise et une logique sous contrôle de version.
Composants : Objets du CRM, étapes du cycle de vie, champs de propriété, piste d'audit.
Outils types : Salesforce, HubSpot.
Contrat avec la couche suivante : Les passages d'étape sont contrôlés par des champs obligatoires, et chaque changement de responsable est enregistré comme un événement horodaté.
Meilleure option : Acheter la plateforme, posséder la configuration.
Composants : Séquences, alertes, rédaction et synthèse par IA, résultats de prévision et de reporting.
Outils types : Plateformes d'engagement, intelligence conversationnelle, outils d'IA spécialisés.
Contrat avec la couche suivante : Les actions sont réversibles ou soumises à une validation humaine, et chacune peut être rattachée à la donnée qui l'a déclenchée.
Meilleure option : Acheter des outils spécialisés ou intégrer des systèmes testés. Les données du MIT favorisent ici les outils spécialisés plutôt que les développements internes, à condition que quelqu'un les adapte à votre workflow.
Séquence de construction
Cet ordre fonctionne quel que soit le modèle choisi, et chaque étape produit quelque chose de vérifiable.
Diagnostiquez le stack en lecture seule
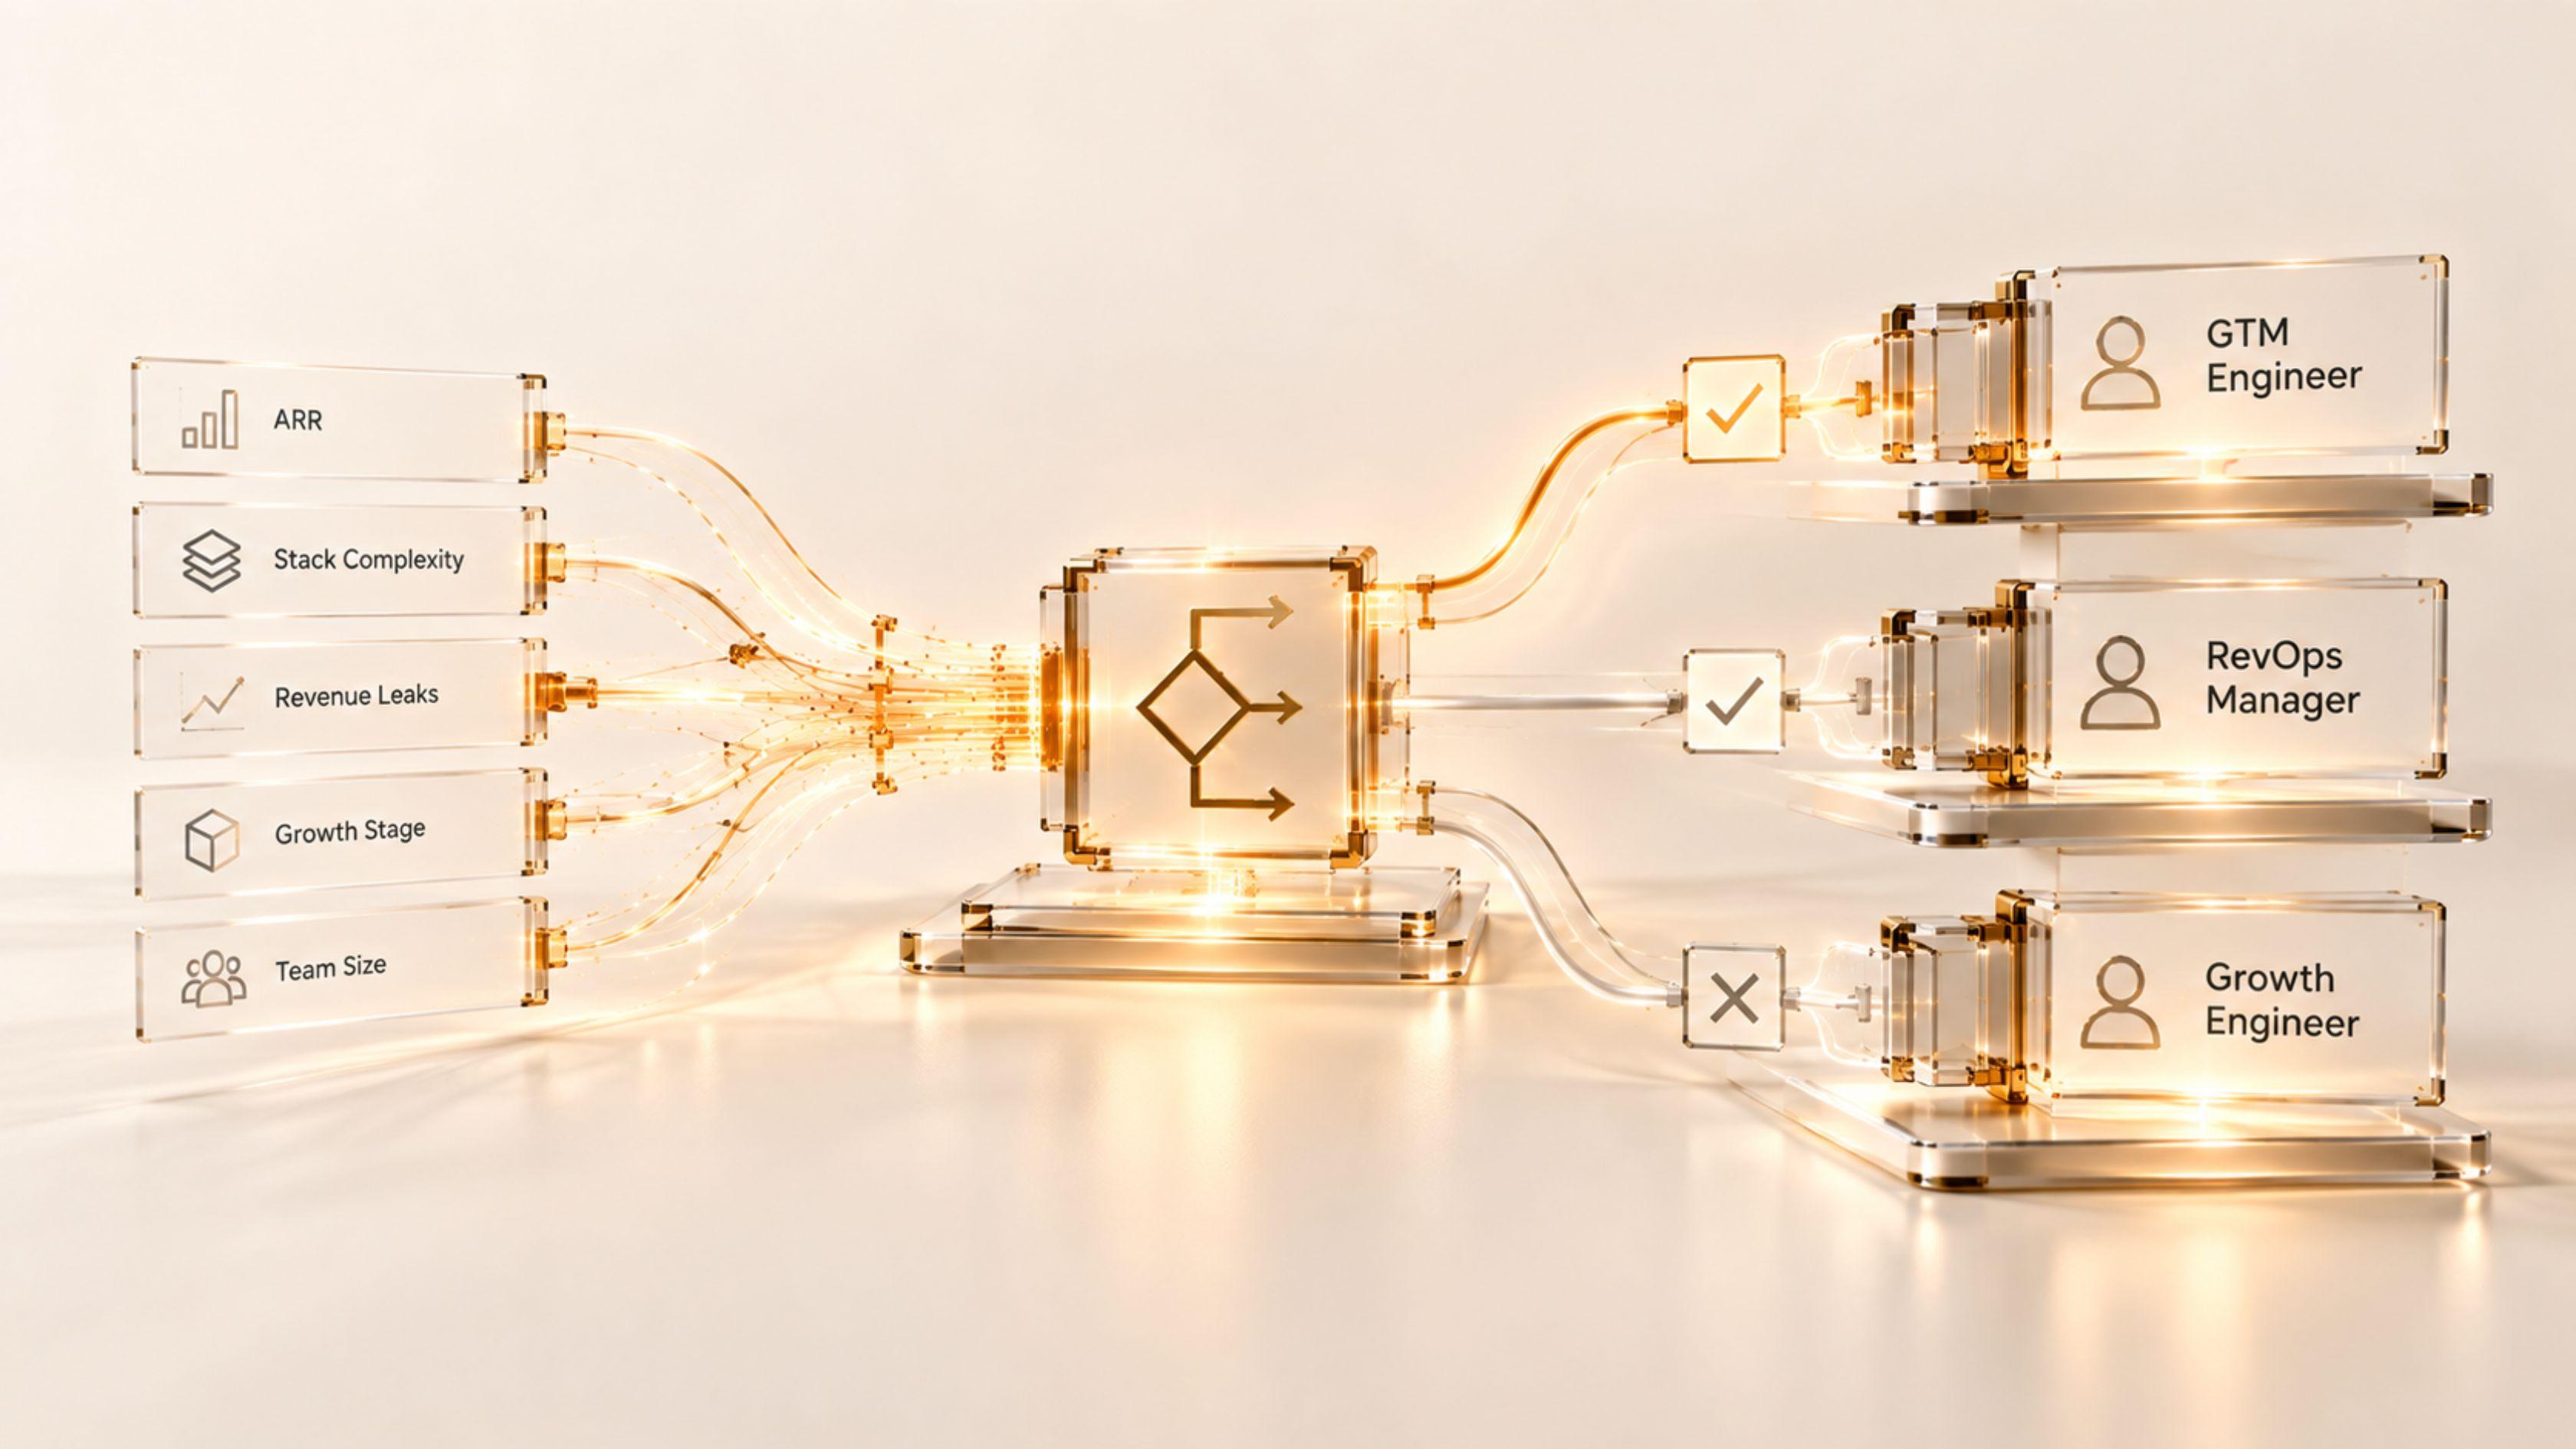
Exportez les comptes, contacts, leads, opportunités et inventaires d'automatisations. Mesurez le taux de doublons, les trous dans les transferts et la part des questions sur les revenus qui exigent un tableur pour y répondre. Cela vous situe sur le modèle de maturité RevOps et vous indique quelle couche manque, ce qui vous dit à son tour de quel type de capacité vous avez besoin. Pour le volet organisationnel, l'arbre de décision entre GTM engineer, responsable RevOps et growth engineer fait correspondre le recrutement à l'étape.
Inventoriez tout ce qui détient de l'état
Listez chaque workflow, intégration, tâche planifiée et clé d'API, et notez qui en est responsable et quels champs il écrit. Tout ce qui est lié à un compte personnel va sur une liste de migration.
Attribuez un modèle par couche
Appuyez-vous sur l'architecture de référence : achetez les sources et le système de référence, gardez l'identité et l'orchestration, et tranchez l'activation selon qu'un outil spécialisé s'adapte ou non à votre workflow sans trop le tordre.
Modélisez le coût et le délai jusqu'au premier système en production
Comparez les trois voies sur les deux mêmes chiffres : le coût de la première année et le nombre de semaines calendaires avant qu'un système tourne en production sur vos données. Le modèle ci-dessous montre la forme du calcul.
Rédigez le contrat de transmission avant tout travail
Des comptes de service plutôt que personnels, une logique sous contrôle de version, un runbook par système, des alertes envoyées sur un canal d'équipe et un responsable interne nommé. Cela vaut autant pour une recrue interne que pour un prestataire.
Testez sur votre propre historique avant la mise en service
Faites tourner chaque système sur une vingtaine de vos propres cas passés, étiquetés par votre équipe, avant qu'il ne touche des enregistrements réels. Fixez le seuil de réussite à l'avance. Le nôtre est de 85 % de concordance avec ce qu'aurait fait un opérateur senior, sinon le système n'est pas livré.
La comparaison des coûts relève de la simple arithmétique dès lors que les données d'entrée sont honnêtes. Le salaire et le coût par recrutement ci-dessous proviennent des sources citées dans cet article. Toutes les autres valeurs sont des emplacements pour vos propres chiffres, pas des benchmarks.
# Illustrative example: replace every assumption with your own inputs
build_year1   = base_salary * (1 + burden_rate) + cost_per_hire + tooling
              # base_salary  = 150,000   (RevGuild 2026 median base)
              # cost_per_hire = 4,700    (SHRM benchmarking, 2022)
              # burden_rate, tooling = your finance team's numbers
build_weeks   = weeks_to_fill + weeks_to_ramp + weeks_to_first_system
buy_year1     = license + implementation + internal_admin_time
buy_weeks     = weeks_to_implement + weeks_to_adapt_to_your_schema
embed_year1   = diagnostic + system_builds + internal_owner_time
embed_weeks   = diagnostic_weeks + weeks_to_first_system
# compare cost per system in production, not cost per head
La dernière ligne change les décisions. Un recrutement peut sembler moins cher par an et coûter pourtant plus par système en fonctionnement une fois ajoutés les mois avant la livraison du premier, et une plateforme paraît la moins chère jusqu'à ce qu'on chiffre le temps nécessaire pour l'adapter à votre schéma.
Construire ou acheter : les compromis
Aucune des trois options ne gagne partout. Le tableau montre où chacune convient et comment chacune échoue habituellement.
| Modèle | Meilleure adéquation | Coût de possession | Délai jusqu'au premier système en production | Risque de défaillance |
|---|---|---|---|---|
| Recruter : embaucher en interne | Entreprises avec un stack diagnostiqué, une feuille de route claire de plusieurs systèmes et un manager capable de relire du travail technique | Un salaire complet avant toute livraison, plus le coût de recrutement et les outils. Le coût par système baisse à mesure que la feuille de route s'étoffe | Le plus lent : délai de recrutement, puis montée en compétence, puis construction | État à mainteneur unique, et postes définis autour des symptômes faute de diagnostic préalable |
| Acheter : une plateforme sous licence | Couches standard comme les sources, le système de référence et les outils d'activation spécialisés adaptés à votre processus | Licences prévisibles, mais le temps interne d'administration et d'intégration croît avec chaque objet personnalisé | Rapide pour le cas d'usage du fournisseur, plus lent pour le vôtre | Un décalage de schéma aux jointures, et une logique qui vit hors de votre CRM |
| Intégrer : équipe forward-deployed | Entreprises qui ont besoin de systèmes en fonctionnement dans un stack existant avant de pouvoir justifier ou encadrer un recrutement à temps plein | Borné par un diagnostic et un nombre de systèmes plutôt que par l'effectif. Exige un responsable interne | Rapide : le diagnostic identifie le premier système, qui est ensuite testé sur votre historique | Périmètre ouvert sans diagnostic fixe, et état détenu par le prestataire sans contrat de transmission |
En pratique, les dispositifs les plus solides sont hybrides. Un schéma courant consiste à intégrer pour diagnostiquer et livrer les premiers systèmes, à acheter pour les couches standard, puis à recruter un ingénieur ou un opérateur interne dès qu'il existe un parc de systèmes en fonctionnement qui mérite d'être possédé.
En production
Le modèle choisi compte moins que la capacité de la fonction à tenir jusqu'au dix-huitième mois.
Surveillez qui détient l'état, pas seulement les résultats. Une fois par mois, passez en revue l'inventaire des automatisations : comptez les workflows qui tournent sous des identifiants personnels (l'objectif est zéro), les tâches sans alerte en cas d'échec et les champs écrits par plus d'une intégration.
Chaque système a besoin d'un repli manuel documenté et d'un interrupteur d'arrêt qu'un opérateur, et pas seulement un ingénieur, peut actionner. Si le workflow d'assignation s'arrête, les leads doivent tomber dans une file par défaut surveillée plutôt que nulle part. Les actions difficiles à annuler, comme les messages aux clients, les prix et les changements de responsable sur des affaires ouvertes, restent soumises à une validation humaine, quel que soit le modèle qui les a construites.
Présentez le choix comme une allocation de capital, pas comme une question d'effectif. Montrez pour chaque modèle le coût de la première année, le nombre de semaines jusqu'au premier système en production et le coût par système en production, à côté de la valeur en dollars de la fuite que ce système referme. Les conseils financent plus volontiers des fuites refermées que des intitulés de poste.
Sa place dans le système
La décision entre recruter, acheter ou intégrer est en réalité une décision sur qui met en place et fait tourner des systèmes précis. Pour la plupart des entreprises entre $3M et $30M d'ARR, les premiers candidats se trouvent là où ont lieu les transferts : Speed-to-Lead et le Handoff Orchestrator vivent dans la couche d'orchestration, celle qui a le plus besoin d'un état détenu et d'identifiants de l'entreprise. Le Pipeline Hygiene Sentinel protège les couches d'identité et de système de référence dont dépendent tous les autres systèmes, ce qui explique qu'il soit rentable avec n'importe quel modèle. Les systèmes de la couche d'activation comme le Signal-Based Outbound Engine ne fonctionnent qu'une fois les couches inférieures solides. La carte complète se trouve sur la page des systèmes.
C'est aussi là que le modèle d'intégration mérite sa place dans la comparaison. Ce n'est pas une alternative au recrutement. Bien mené, c'est l'étape qui fait réussir le recrutement : un diagnostic borné, quelques systèmes testés sur vos données et en fonctionnement dans vos comptes, et une transmission qui transforme le premier trimestre du prochain ingénieur en exploitation plutôt qu'en archéologie.
Sources : Bloomberry, « I analyzed 1,000 GTM Engineering jobs » (Henley Wing Chiu, mis à jour en janvier 2026). RevGuild, GTM Engineer Salary Market Report 2026 (données de Glozo Talent Intelligence, n=71 postes avec salaire publié, juillet 2026). MIT NANDA, The GenAI Divide: State of AI in Business 2025 (août 2025, selon Fortune). Bureau des statistiques du travail des États-Unis, Employee Tenure in January 2026 (septembre 2026). SHRM, « The Real Costs of Recruitment » (avril 2022). Gartner, enquête Marketing Technology 2023.