Scénario illustratif. Le directeur commercial d'une entreprise SaaS en série B publie une offre de responsable RevOps après un mauvais trimestre. Les leads restent sans réponse pendant deux jours, les prévisions continuent de manquer leur cible de 30 points et le conseil d'administration exige une explication. Six mois plus tard, la nouvelle recrue a nettoyé soixante règles de validation Salesforce, reconstruit trois tableaux de bord et hérité de quarante tâches Zapier non documentées laissées par un prestataire des opérations commerciales. Pourtant, le délai de réponse aux leads n'a pas bougé : personne n'a diagnostiqué que la vraie panne était un webhook manquant entre la plateforme d'automatisation marketing et Salesforce, et non une lacune dans les rapports. L'entreprise avait besoin d'un ingénieur capable de construire un système et d'en assumer la responsabilité. Elle a recruté un opérateur capable de le maintenir. L'intitulé ne correspondait pas au problème, et personne n'avait écrit ce qu'était réellement ce problème avant de publier l'offre.
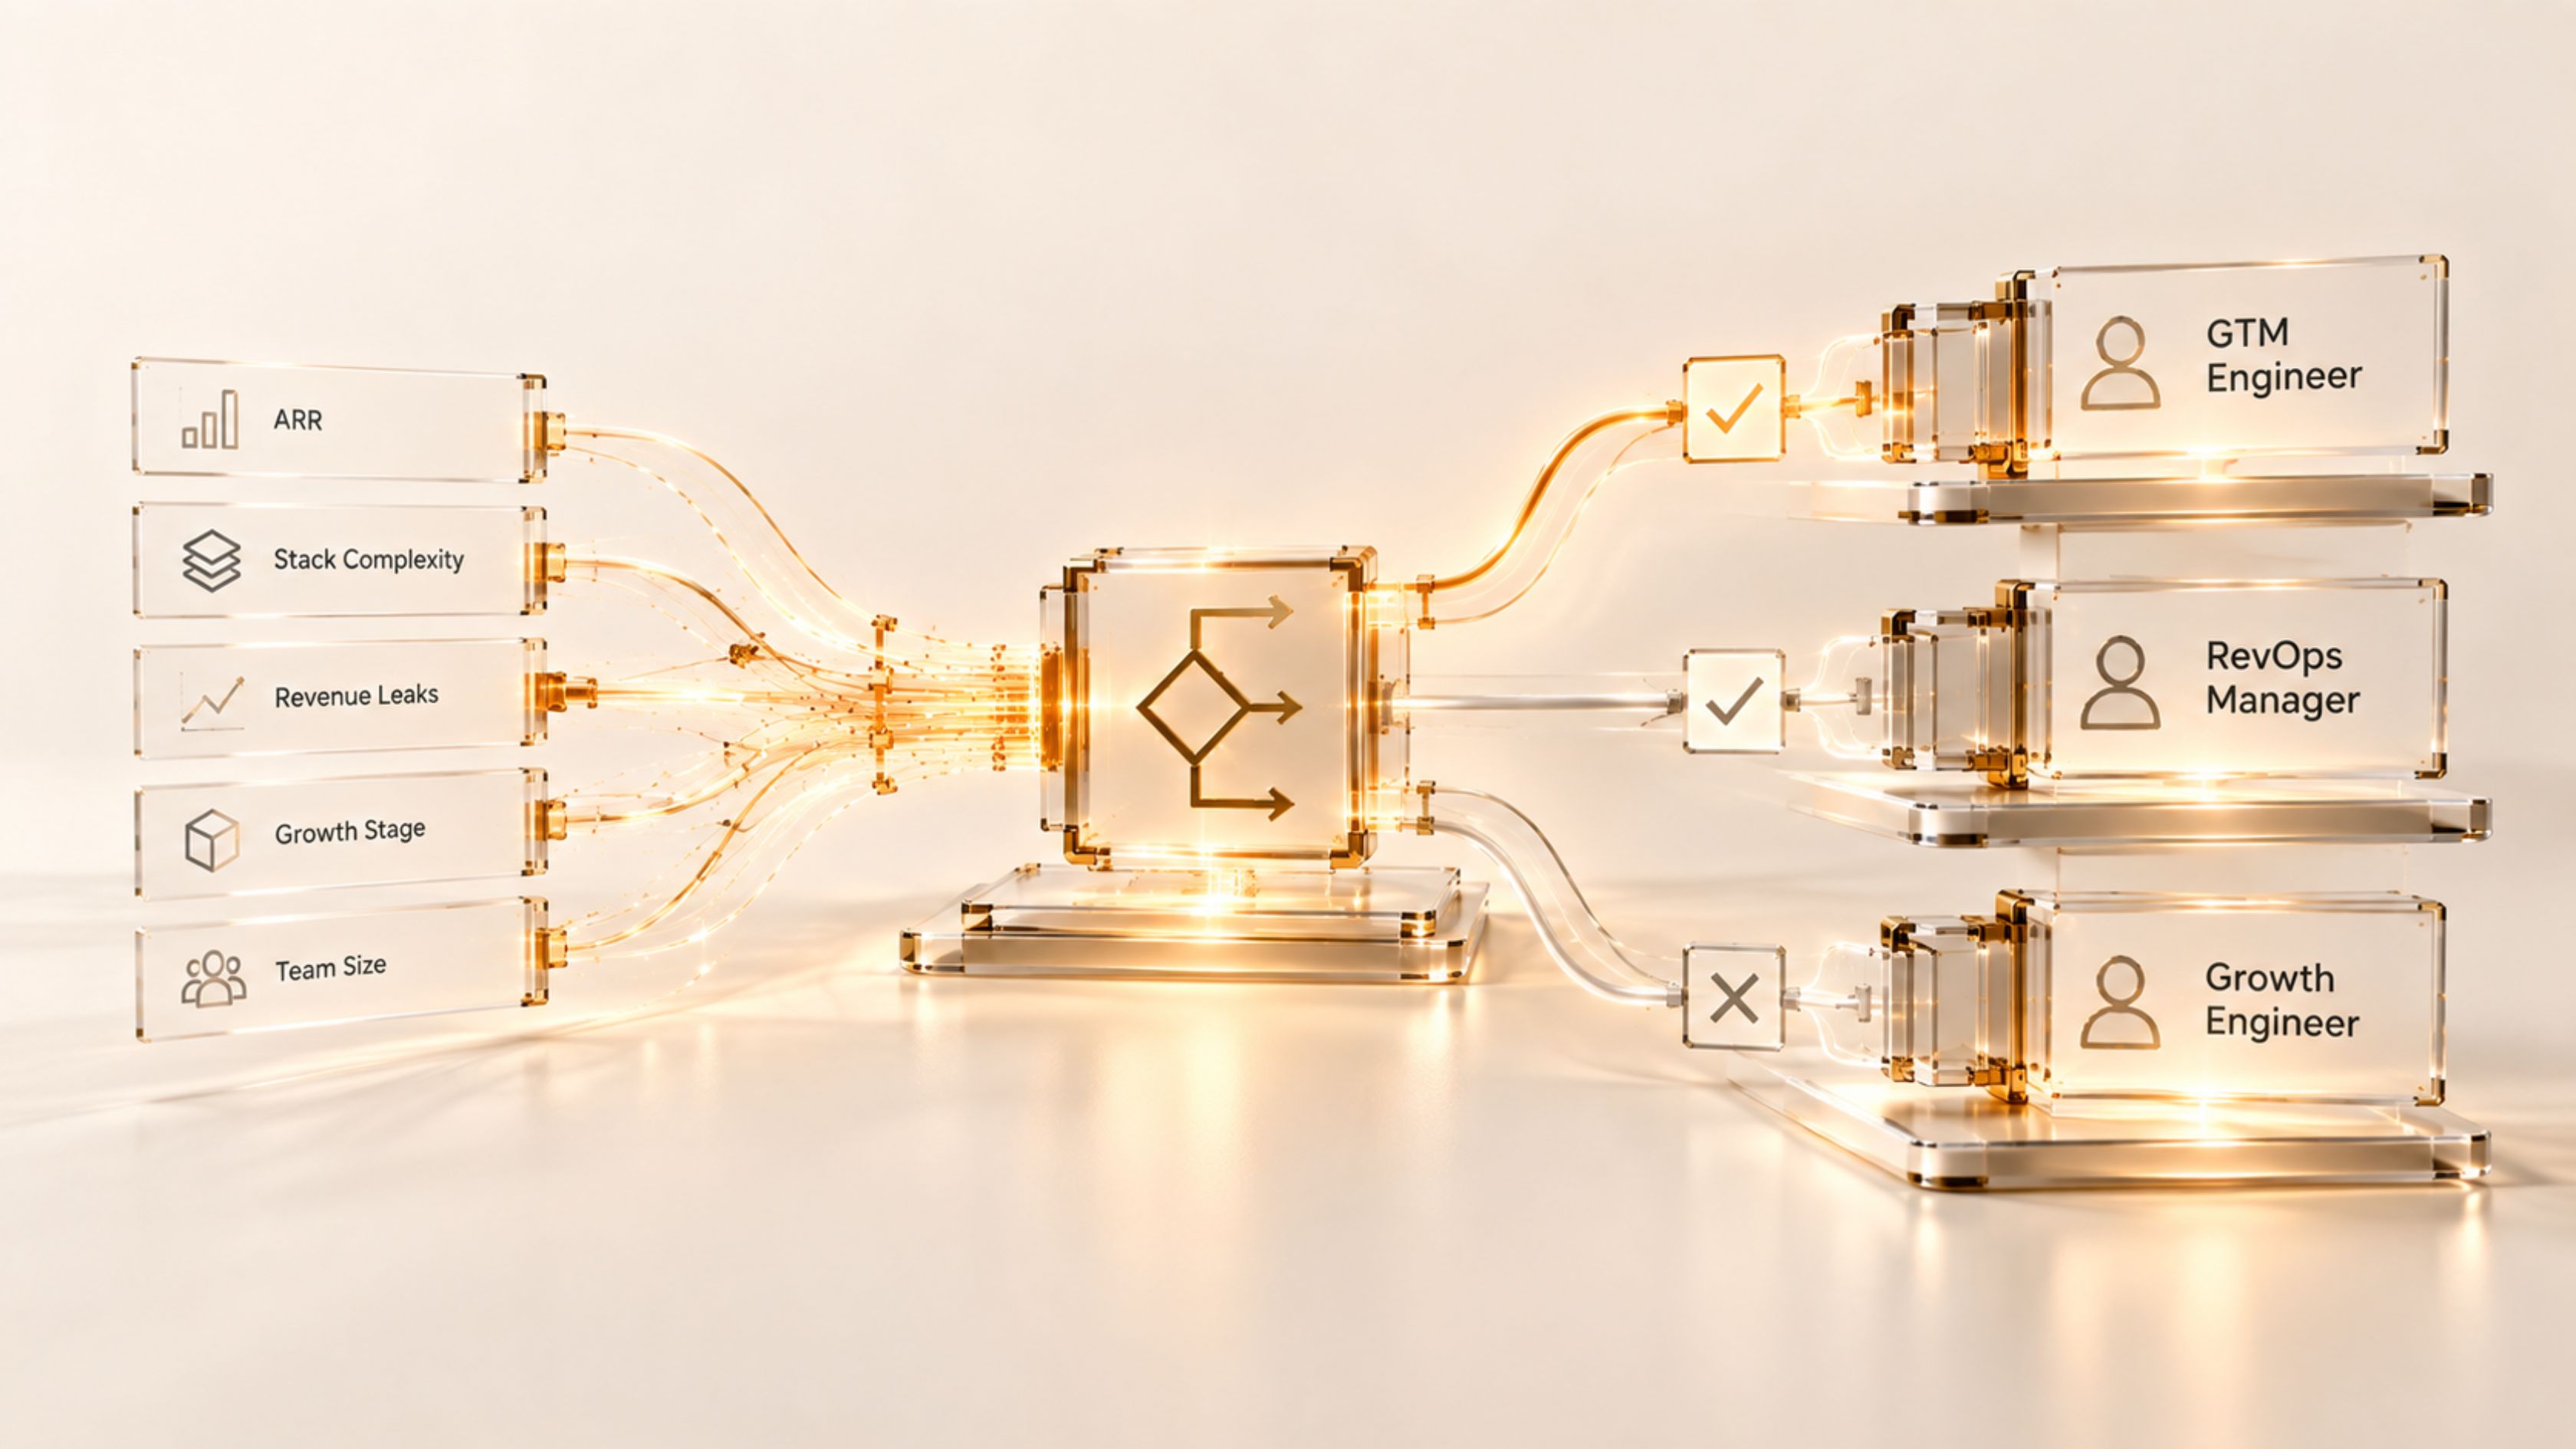
Ce n'est ni un problème de personnes ni un problème d'outils : c'est un problème d'architecture des systèmes déguisé en fiche de poste. GTM Engineer, responsable RevOps et Growth Engineer ne sont pas des intitulés interchangeables pour une même fonction ; ils correspondent à des couches différentes de l'infrastructure de revenus, à des modes de défaillance distincts et à des courbes de coût de possession différentes. Recruter le mauvais profil ne gaspille pas seulement une ligne budgétaire : la panne reste en place pendant qu'une personne compétente perd un an à la contourner. Avant de rédiger l'offre, il faut un arbre de décision, pas une préférence pour un intitulé.
Là où ça casse
Recruter un responsable RevOps pour résoudre un problème d'ingénierie
Les responsables RevOps excellent dans la conception des processus, la gouvernance des champs et la logique des rapports au sein des outils que vous possédez déjà : Salesforce, HubSpot, Outreach et éditeurs natifs de workflows. En revanche, la plupart des fiches de poste ne les préparent pas à écrire et maintenir des intégrations API sur mesure, à construire des déclencheurs événementiels entre des systèmes qui ne communiquent pas nativement, ou à déboguer le contenu d'un webhook défaillant à 23 heures. Lorsque la panne réelle est un événement lead.routed manquant entre votre outil de formulaires et votre CRM, le responsable RevOps construit un contournement dans le CRM : un rapport, une file manuelle ou une alerte Slack sur laquelle quelqu'un doit cliquer, parce que ce sont les outils dont il dispose. Le symptôme s'améliore légèrement. La cause racine, un système de réponse rapide aux leads qui n'a pas été construit, reste entière.
Recruter un GTM Engineer avant d'avoir une infrastructure qui justifie de l'ingénierie
La défaillance inverse est tout aussi courante. Une entreprise en amorçage, avec 400 fiches CRM et deux commerciaux, recrute un GTM Engineer pour construire une logique d'orchestration sur mesure entre des systèmes qui contiennent à peine des données. Il n'y a pas assez de signaux pour construire un Signal-Based Outbound Engine, pas de cadence de transfert assez complexe pour justifier un orchestrateur, ni d'historique d'opportunités pour entraîner un modèle de prévision. L'ingénieur passe les deux premiers trimestres à nettoyer les données saisies et à administrer le CRM, un travail qu'un généraliste RevOps aurait effectué plus vite, pour moins cher et sans le coût d'opportunité d'un salaire d'ingénieur sous-utilisé.
Recruter un Growth Engineer et lui confier des tâches critiques pour les revenus
Les Growth Engineers sont généralement orientés produit et expérimentation : ils savent livrer des pages d'atterrissage, exécuter des boucles d'activation et instrumenter des événements d'analyse produit. Lorsqu'une entreprise leur confie la logique de transfert commercial ou la détection des signaux de désabonnement, le résultat prend souvent la forme d'un script ponctuel plutôt que d'un système supervisé : aucun responsable de la tâche de synchronisation lorsqu'elle casse, aucune alerte lorsque le déclencheur s'arrête silencieusement, aucun repli lorsque l'API source change de schéma. Les Growth Engineers sont souvent de bons concepteurs, mais l'infrastructure critique pour les revenus exige un responsable qui rende des comptes aux directions commerciales et de la réussite client, pas à une liste de tâches de croissance.
Traiter la décision comme définitive plutôt que progressive
L'antipattern le plus coûteux n'est pas de choisir le mauvais intitulé : c'est de supposer que le premier recrutement sera le dernier. Une entreprise qui a besoin d'un responsable RevOps à $3M ARR pour établir la gouvernance des champs, puis d'un GTM Engineer à $8M ARR pour construire la logique de Handoff Orchestrator, ne commet pas deux erreurs distinctes en les recrutant dans cet ordre. Elle se trompe seulement si elle recrute le second profil avant que les fondations du premier (champs propres, étapes définies et système de référence documenté) soient en place pour permettre à l'ingénieur de construire.
Architecture de référence : associer le rôle à la couche défaillante
Aucune décision de recrutement à ce stade. Il s'agit d'un audit en lecture seule de l'infrastructure actuelle : hygiène des champs CRM, inventaire des intégrations, latence d'assignation et de transfert, historique de précision des prévisions. Le résultat est un registre des fuites : une liste hiérarchisée des pertes de revenus dues à des processus défaillants, à des défauts d'ingénierie ou à un manque de personnel. Sans cette couche, chaque recrutement qui suit relève de la supposition.
Prend en charge la taxonomie des champs, les définitions des étapes, l'automatisation native du CRM (règles de validation, règles d'assignation et éditeurs de workflows intégrés) et la logique des rapports. Travaille dans le cadre de la configuration prise en charge par l'éditeur : Salesforce Flow, HubSpot Workflows et paramètres natifs de Gong ou d'Outreach. Contrat de données : consomme des données suffisamment propres provenant des sources existantes ; ne construit pas de nouvelles intégrations entre systèmes.
Prend en charge l'orchestration entre systèmes : intégrations au niveau des API, déclencheurs événementiels et tâches de synchronisation entre CRM, automatisation marketing, télémétrie produit et plateformes de réussite client. Construit et supervise les systèmes que la seule configuration RevOps ne peut pas produire : assignation de leads déclenchée par un webhook en quelques secondes, ou logique de transfert vérifiant plusieurs champs sur deux objets avant de créer une tâche. Contrat de données : publie des événements définis et s'y abonne (lead.created, opp.stage_changed, usage.threshold_crossed), avec un schéma documenté sur lequel les autres systèmes peuvent s'appuyer.
Prend en charge l'instrumentation et l'expérimentation proches du produit : suivi des événements d'activation, incitations dans le produit et logique de conversion en libre-service. Recoupe GTM Engineering au point de transfert entre les signaux d'usage produit et les systèmes commerciaux ou de réussite client, mais ne devrait pas posséder les tâches de synchronisation critiques pour les revenus elles-mêmes : seulement les signaux qui les alimentent.
Séquence de construction : comment recruter, pas seulement choisir un intitulé
Construire ou acheter : les compromis
| Approche | Meilleure adéquation | Coût de possession | Risque de défaillance |
|---|---|---|---|
| CRM natif / recrutement RevOps | Gouvernance des champs, définitions des étapes et rapports dans un outil principal | Fourchette salariale plus basse ; évolue mal au-delà de 3-4 systèmes intégrés | Contournements plutôt que corrections lorsque la panne traverse plusieurs systèmes |
| iPaaS / outil de workflows (Zapier, Make, Workato) géré par un généraliste ou un Growth Engineer | Automatisations simples à faible volume entre deux ou trois outils | Démarrage peu coûteux ; la tarification à la tâche et les chaînes fragiles deviennent chères et instables à grande échelle | Défaillances silencieuses : un zap se désactive et personne ne le remarque avant que les données d'opportunités soient périmées |
| Code sur mesure / ingénierie GTM intégrée chez le client | Orchestration événementielle sur toute l'infrastructure de revenus, testée sur vos propres données | Coût initial plus élevé ; maintenance à long terme réduite une fois livré à 85% et stable | Exige une responsabilité réelle et une discipline de supervision en production : le risque passe de « est-ce que ça a cassé ? » à « quelqu'un l'a-t-il remarqué ? » |
Les entreprises sous-estiment la ligne intermédiaire. Une chaîne de workflows qui semblait être un raccourci en série A devient le système non documenté qu'un nouveau GTM Engineer doit décortiquer en série B, généralement sans personne pour se souvenir de la raison d'être d'un zap donné. Évaluer le coût réel implique d'intégrer ce futur démantèlement, pas seulement l'abonnement mensuel à l'outil.
L'exploiter en production
Quel que soit le rôle responsable d'un système, la supervision en production doit exister indépendamment de l'attention de cette personne. Un système d'assignation des leads a besoin d'une alerte lorsque le volume tombe à zéro ou que le délai de réponse dépasse un seuil, pas d'un tableau de bord consulté quand quelqu'un y pense. Si la seule supervision consiste à dire « le responsable RevOps le voit dans le rapport hebdomadaire », le système n'a pas de supervision : il repose sur un espoir.
Définissez ce qui se passe lorsque la tâche de synchronisation qui alimente un système tombe en panne. Le lead reste-t-il sans assignation, ou rejoint-il une file avec un responsable par défaut ? Une prévision périmée est-elle signalée comme telle, ou présentée au conseil comme actuelle ? Un état de repli sûr doit être conçu dès la construction. L'ajouter après la première interruption silencieuse, c'est laisser s'éroder la confiance dans le système.
Le conseil n'a pas besoin de savoir quelle API appelle la logique de transfert. Il lui faut une phrase : « les leads sont automatiquement assignés au bon commercial en cinq minutes, et nous recevons une alerte si cela cesse de fonctionner ». Si le responsable du système ne peut pas le résumer ainsi, celui-ci est probablement plus fragile, ou plus improvisé, que ne le suggère l'organigramme. C'est aussi le test permettant de savoir si le bon rôle en est responsable : un responsable RevOps peut généralement expliquer clairement un processus de reporting ; expliquer clairement une chaîne de déclencheurs entre systèmes indique que la couche d'ingénierie est réellement construite, et non improvisée.
Sa place dans le système
Cet arbre de décision se situe en amont de chaque système de la page des systèmes VANDFORT. Speed-to-Lead et Handoff Orchestrator relèvent précisément de la couche 2 : ce sont des problèmes d'orchestration entre systèmes, pas de configuration native du CRM. C'est pourquoi les entreprises qui tentent de les construire avec un seul généraliste RevOps restent souvent bloquées au stade des contournements décrit plus haut. Forecast Assistant et Pipeline Hygiene Sentinel supposent d'abord une couche 1 solide : des définitions d'étapes propres et une discipline des champs constituent le contrat de données consommé par ces systèmes.
Le modèle de VANDFORT existe pour combler la lacune dont traite réellement cet article : la période entre le diagnostic d'un système de couche 2 manquant et la disponibilité des effectifs, du budget ou de la conviction nécessaires pour recruter un GTM Engineer à temps plein. Alejandro Lugo et Mauricio Varela ont construit VANDFORT en tant qu'ingénieurs intégrés chez le client : ils construisent le système dans votre infrastructure, sur vos propres données, et il doit fonctionner à 85 % avant d'être livré. Découvrez-les sur vandfort.com/about. Si vous cherchez à déterminer si votre manque appelle un recrutement, une construction ou ni l'un ni l'autre pour l'instant, le Revenue Leak Report est la version en lecture seule, sur trois semaines, du diagnostic de la première étape : réalisée pour vous, avant d'engager un budget de recrutement.