Un CRO avec qui nous avons échangé l'an dernier venait de signer l'achat d'une nouvelle plateforme d'assignation des leads. Le business case était limpide : les commerciaux se plaignaient que les leads entrants restaient des jours sans suite, le marketing accusait les ventes, les ventes accusaient le marketing, et quelqu'un au conseil avait lu qu'une réponse rapide est corrélée au taux de conversion. Six mois et une implémentation plus tard, le délai de réponse affiché au tableau de bord s'était amélioré. La conversion du pipeline, elle, n'avait pas bougé. Lorsque nous avons extrait le journal d'événements brut lors d'un audit ultérieur, la vraie fuite se trouvait trois étapes après l'assignation : un transfert entre SDR et AE où la fiche d'opportunité restait dans un champ de statut dont personne n'était responsable, en attendant un message Slack manuel qui arrivait, en moyenne, un jour et demi après que l'outil d'assignation avait parfaitement fait son travail. Ils avaient acheté la solution à un problème qu'ils n'avaient pas, et laissé la vraie fuite intacte.
Ce n'est pas l'histoire d'un mauvais outil. La plateforme d'assignation a fonctionné comme prévu. C'est l'histoire d'un diagnostic posé à la mauvaise couche du système : traiter un symptôme visible comme la cause racine parce que personne n'avait suivi l'objet (le lead, puis l'opportunité) sur tout son cycle de vie avant de signer le bon de commande.
C'est un problème de systèmes, ni un problème de personnes ni un problème d'outils, car le mode de défaillance est structurel : les équipes revenus achètent contre un symptôme visible (réponse lente, prévision manquée, pics de désabonnement) sans avoir d'abord identifié quel objet, champ ou transfert du pipeline casse réellement. Un outil acheté contre un symptôme améliore l'indicateur qui représente ce symptôme et laisse la fuite exactement là où elle était, car la fuite se situe généralement à un ou deux sauts de l'endroit où la douleur se fait sentir. Diagnostiquer avant de construire, c'est instrumenter tout le parcours (champs, événements, déclencheurs, tâches de synchronisation) et trouver où l'objet bloque réellement, avant de décider si la correction relève d'un changement de configuration, de la reconstruction d'un workflow ou d'un système réellement nouveau. Notre propre processus d'entrée repose sur cette logique : avant de dimensionner l'un des neuf systèmes de VANDFORT pour un client, la mission commence par un Revenue Leak Report, un diagnostic en lecture seule de trois semaines, précisément parce que nous avons vu ce qui arrive quand une équipe saute cette étape. Le schéma ci-dessous est tiré de constats anonymisés issus de ces audits : pas d'un client en particulier, mais des schémas du registre des fuites qui se répètent assez souvent pour être structurels plutôt qu'anecdotiques.
Là où ça casse
1. Des achats calqués sur le symptôme
L'antipattern le plus courant : un outil est choisi parce que son nom correspond au symptôme. Une réponse lente aux leads appelle un outil d'assignation. Des prévisions manquées, un outil de prévision. Le désabonnement, une plateforme de score de santé. Mais le symptôme est un indicateur retardé situé en aval de plusieurs objets (lead.created, lead.assigned, lead.status, opportunity.stage_changed) et la vraie panne se trouve souvent en amont ou dans un transfert entre deux systèmes, pas dans le système que touche le nouvel outil.
2. La prolifération d'outils sur un objet partagé défaillant
Les équipes qui ont déjà tenté une fois de corriger une fuite empilent souvent un deuxième puis un troisième outil sur le même champ au lieu de le réparer. Nous trouvons régulièrement trois ou quatre automatisations qui écrivent dans le même champ lead_status ou account_stage avec des logiques contradictoires (une depuis l'automatisation marketing, une depuis une règle de workflow du CRM, une depuis un outil de séquences de prospection) parce que chaque nouvel achat a été dimensionné sans vérifier qui possédait déjà ce champ.
3. Des feuilles de route guidées par l'anecdote
Les équipes RevOps sommées de « faire quelque chose » priorisent souvent les corrections selon le commercial qui s'est plaint le plus fort ce trimestre, et non selon la transition d'étape qui présente la plus forte perte pondérée par le volume. L'histoire d'un seul AE sur une affaire perdue peut peser plus lourd qu'une fuite touchant quarante autres comptes, simplement parce que c'est la fuite dont la direction a entendu parler en QBR.
4. Aucune référence avant l'achat
Sans référence capturée avant la mise en service d'un outil, impossible d'attribuer l'évolution du chiffre à l'achat plutôt qu'à la saisonnalité, à un changement d'effectif commercial ou à une mise à jour tarifaire lancée le même trimestre. Nous avons vu des équipes incapables de dire, six mois après un achat, si l'outil avait servi à quelque chose, parce que personne n'avait exporté la référence au niveau des événements avant l'implémentation.
5. Une sélection guidée par la démo
Les démos des éditeurs sont conçues pour briller sur des jeux de données petits et propres. La défaillance apparaît plus tard, face au volume réel de données du client, à son taux de doublons et à l'incohérence de ses champs. Un outil choisi sur une démo de 20 fiches casse souvent dès qu'il rencontre un CRM avec 40 000 contacts en double et une taxonomie d'étapes redéfinie quatre fois par quatre responsables RevOps différents.
Architecture de référence
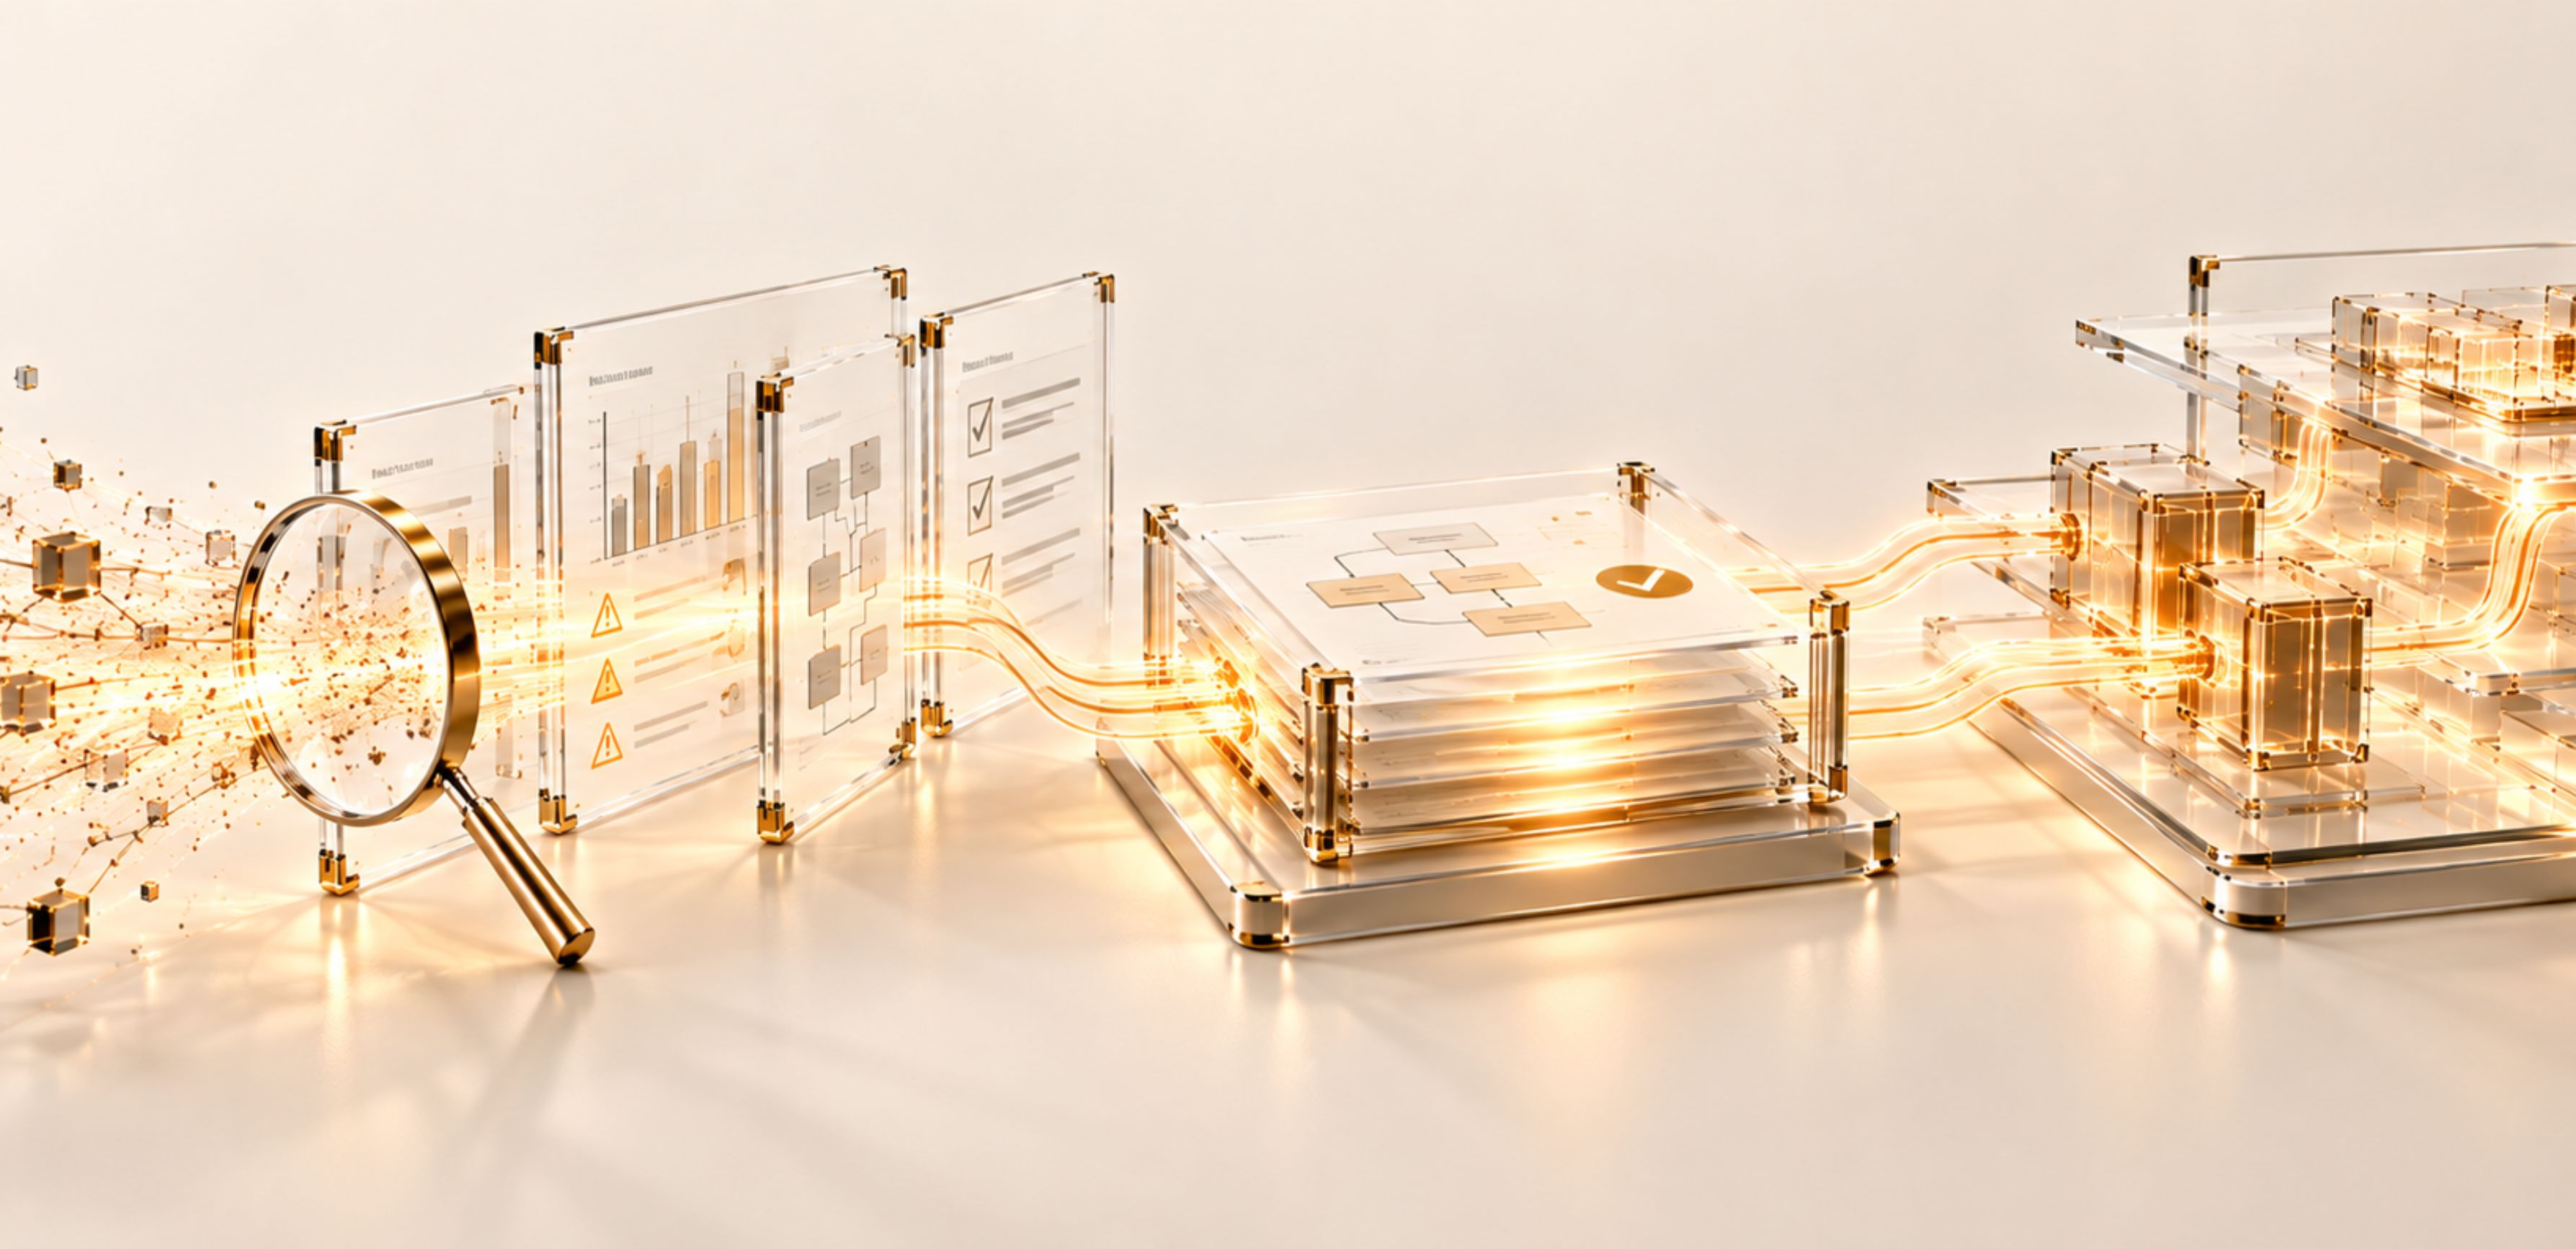
Le diagnostic suit une architecture en couches, la même que celle que nous utilisons pour déterminer lesquels des neuf systèmes un moteur de revenus nécessite réellement. Chaque couche est auditée séparément, avec son propre contrat de données envers la couche supérieure, avant qu'une correction (outil, workflow ou système) ne soit proposée.
Signal brut : CRM (Salesforce, HubSpot), automatisation marketing (Marketo, HubSpot), événements d'usage produit, support et tickets (Zendesk, Intercom), intelligence des appels (Gong, Chorus). Contrat avec la couche suivante : chaque objet (lead, compte, opportunité, ticket) doit porter un identifiant externe stable et un journal d'événements horodaté, pas seulement un champ d'état courant.
Rapprochement des comptes et des contacts, logique de dédoublonnage, contrôles de complétude des champs. Composants : règles de rapprochement fondées sur le domaine et le nom d'entreprise normalisé, audits du taux de valeurs vides sur les champs obligatoires (secteur, niveau d'ICP, propriétaire). Contrat avec la couche suivante : une seule fiche canonique de compte ou de contact par entité réelle, avec un score de confiance du rapprochement documenté, avant que toute logique d'orchestration ne la lise.
Règles d'assignation, déclencheurs de SLA, tâches de synchronisation entre systèmes (outils iPaaS comme Workato ou Zapier, ou automatisation native du CRM). Contrat avec la couche suivante : chaque déclencheur s'active sur un événement défini, écrit dans un seul champ doté d'un responsable et enregistre un horodatage : aucune écriture silencieuse, aucune automatisation orpheline sans responsable clair.
Le CRM comme source de vérité pour l'étape, la catégorie de prévision et la propriété. Contrat avec la couche suivante : les définitions d'étapes sont documentées et appliquées (pas seulement nommées), et chaque transition d'étape est enregistrée comme un événement, pas écrasée sur place.
Les personnes et les agents IA qui agissent sur les données : commerciaux, responsables CS et les systèmes de GTM Operations, Sales Operations, CS Operations et Revenue Intelligence. Contrat : cette couche n'agit que sur des données déjà passées proprement par les couches 1 à 4 ; elle ne compense pas les pannes en amont par des contournements manuels.
Séquence de construction
Construire ou acheter : les compromis
Une fois une fuite diagnostiquée et classée, la question n'est plus « quel outil » mais « quelle architecture convient à cette correction précise ». Les trois voies habituelles présentent des profils différents de coût de possession et de défaillance.
| Approche | Meilleure adéquation | Coût de possession | Risque de défaillance |
|---|---|---|---|
| Workflow ou automatisation native du CRM | Corrections d'un seul champ ou déclencheur entièrement contenues dans un système (par ex. une alerte de changement d'étape, une règle de validation de champ) | Faible : pas de nouvelle licence, maintenu par l'administrateur CRM existant | Faible pour une logique simple ; casse silencieusement à mesure que les règles se multiplient et entrent en conflit |
| iPaaS ou outil de workflows (par ex. Workato, Zapier, Make) | Corrections couvrant deux systèmes ou plus avec un contrat de données clair et stable (du CRM à l'outil de support, de l'automatisation marketing au CRM) | Moyen : nouvelle licence, maintenance continue à mesure que les schémas sources évoluent | Moyen : les tâches de synchronisation échouent silencieusement quand le schéma dérive ; nécessite supervision et relances |
| Code sur mesure ou agent IA | Corrections exigeant du jugement, des données non structurées ou une logique trop complexe pour des workflows en pointer-cliquer (scoring de signaux, détection de schémas de désabonnement, génération de récits de prévision) | Plus élevé au départ, plus faible à long terme s'il est bien construit et bien maintenu, sans le poids des licences par utilisateur | Le plus élevé s'il est construit sans test préalable sur les propres données du client ; le plus faible des trois une fois validé au volume de production |
L'erreur que nous voyons le plus souvent consiste à recourir à la troisième option (code sur mesure ou agent) avant d'avoir vérifié que la fuite ne relève pas en fait de la première : une règle de validation manquante ou un champ sans responsable qu'un workflow natif pourrait régler en un après-midi.
En production
Une fois une correction livrée, le registre des fuites n'est pas archivé ; il devient la référence de supervision. Suivez chaque semaine les mêmes indicateurs de taux de conversion et de temps passé dans l'étape par rapport aux chiffres d'avant correction, et non un KPI générique de tableau de bord, pour que la dérive apparaisse avant qu'un commercial ne la remarque à nouveau de manière anecdotique.
Chaque tâche de synchronisation et chaque déclencheur construits pour corriger une fuite ont besoin d'un état d'échec explicite : ce qui se passe quand le champ source est vide, quand l'API limite le débit, quand deux automatisations tentent d'écrire le même champ en même temps. Concevez le repli (file d'attente, alerte, revue humaine) avant la mise en service, pas après avoir découvert la première panne silencieuse trois semaines plus tard.
La direction n'a pas besoin de la logique du déclencheur ; elle a besoin de l'avant et de l'après dans le registre des fuites : cette étape convertissait à X, nous avons trouvé que la panne se situait dans ce champ ou ce transfert, nous l'avons corrigée, et elle convertit désormais à Y, soit Z de pipeline récupéré. C'est aussi ce cadrage qui justifie de ne pas acheter l'outil suivant tant que la correction actuelle n'a pas été mesurée.
Sa place dans le système
Le diagnostic décrit ici est le point d'entrée du modèle de mission de VANDFORT, pas un service distinct. Un Revenue Leak Report produit le registre des fuites hiérarchisé ; les corrections qui en découlent correspondent directement à des systèmes précis plutôt qu'à des outils génériques. Un transfert défaillant entre SDR et AE, le schéma de notre exemple d'ouverture, est exactement ce que le Handoff Orchestrator est conçu pour résoudre, avec des champs définis et des déclencheurs de SLA au lieu d'un message Slack que quelqu'un oublie d'envoyer. Un premier contact lent ou irrégulier avec les leads entrants est ce contre quoi le système Speed-to-Lead est dimensionné, une fois que l'audit confirme que la panne se situe réellement à cette couche et non plus en aval. Et quand la fuite vient de données de pipeline obsolètes ou non gouvernées qui alimentent une mauvaise prévision, c'est le territoire du Pipeline Hygiene Sentinel. L'intérêt de diagnostiquer d'abord, c'est que le registre des fuites vous indique lequel des neuf systèmes, s'il y en a un, traite réellement la panne pondérée en dollars, au lieu de partir d'une catégorie d'outil et de lui chercher ensuite une justification.