Un consejero hace una pregunta sencilla: de las solicitudes de demo entrantes del último trimestre, ¿cuántas recibieron respuesta de una persona en menos de una hora? El CRO sabe que la respuesta debería llevar un minuto. Lleva tres personas y dos días. Marketing exporta los formularios, los responsables de SDR sacan sus colas, alguien fusiona a mano cuentas duplicadas, y la cifra que por fin llega al consejo viene con una nota al pie sobre la calidad de los datos.
Esa empresa no tiene un problema de reporting. Tiene un problema de madurez. La pregunta no tiene respuesta porque ningún evento de la vida del lead se registró nunca como una marca de tiempo sobre un registro canónico. Un panel mejor no lo arreglará, y una cuarta herramienta de enriquecimiento tampoco. Lo que lo arregla es saber qué capa del motor de ingresos falta y construir esa capa primero.
La mayoría de los modelos de madurez describen las etapas con adjetivos: incipiente, en desarrollo, avanzado, optimizado. Un adjetivo no se puede auditar. Dos directivos puntuarán la misma empresa con dos etapas de diferencia, y ninguna de las dos puntuaciones dice a nadie qué construir el lunes. La parte organizativa del mercado ha avanzado rápido. Gartner predijo en 2021 que el 75% de las empresas de mayor crecimiento desplegaría un modelo de RevOps en 2025. Pero adoptar el organigrama no es lo mismo que hacer madurar los sistemas que hay debajo. Muchos equipos tienen ahora un Head of RevOps al frente de un stack que todavía no sabe decirles cuántas cuentas tienen.
El modelo que sigue funciona de otra forma. Cada etapa se define por un fallo concreto y nombrable que la etapa ha eliminado, y cada transición es un sistema concreto que construyes. Es el vocabulario detrás de nuestro trabajo de diagnosticar antes de construir, y extiende el modelo de forward-deployed engineering para equipos de ingresos hasta convertirlo en un mapa de adónde va realmente el trabajo. La regla que lo hace útil: tu etapa la marca el peor fallo que todavía toleras, no la mejor herramienta que tienes.
Dónde falla
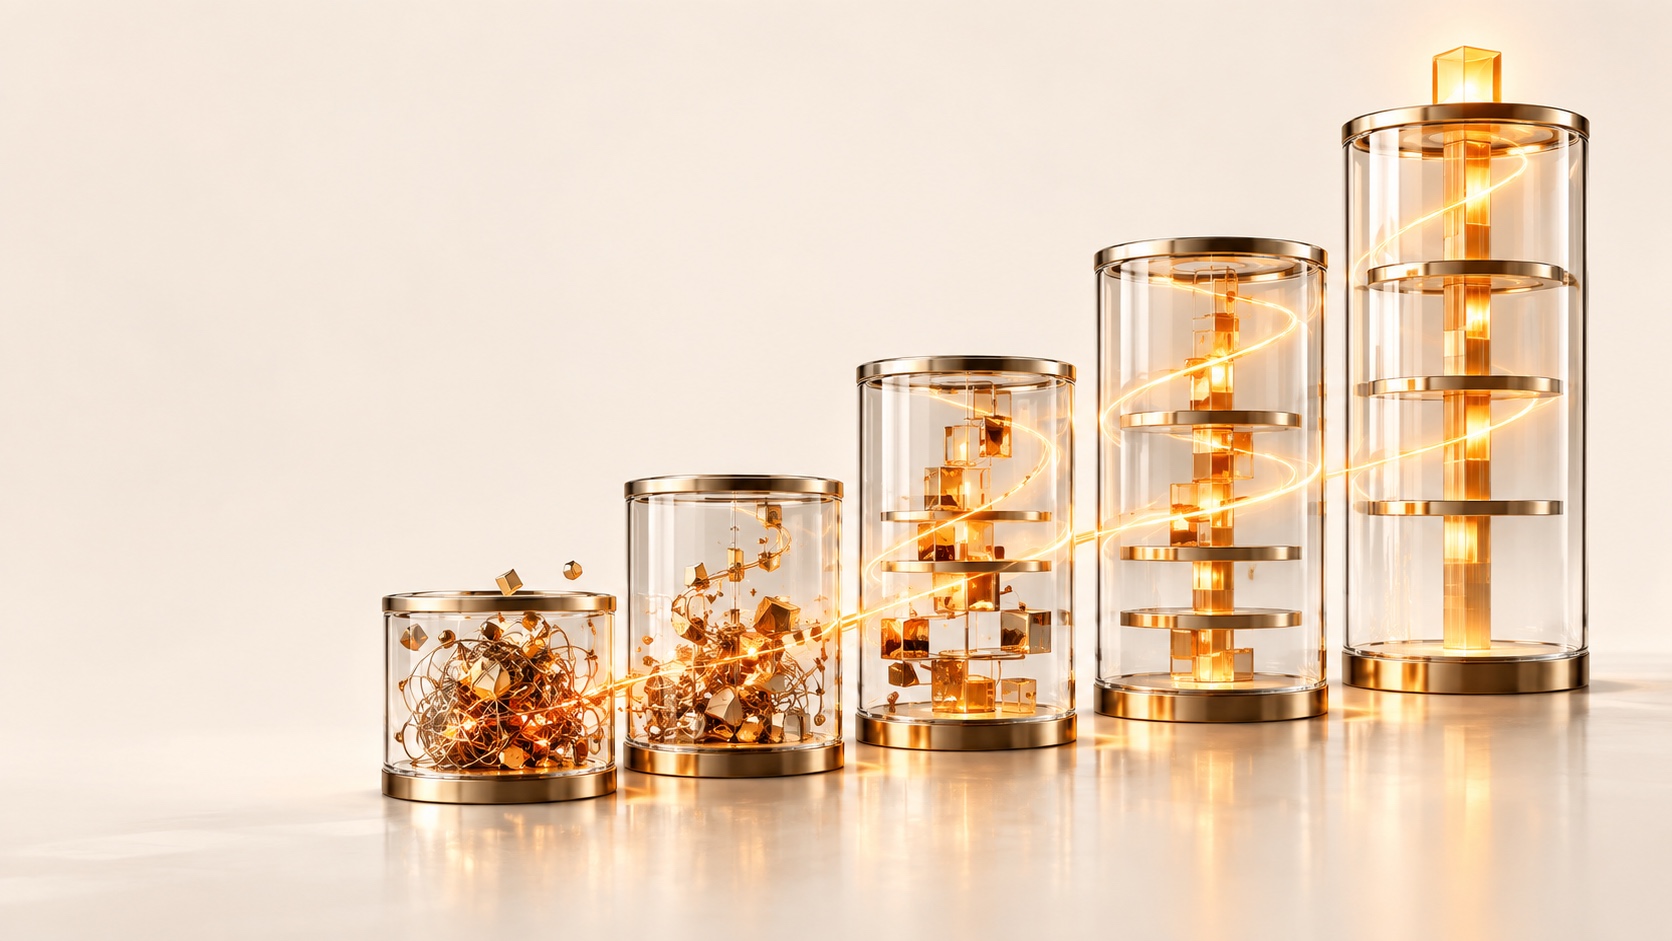
Cada transición de etapa tiene un fallo que la bloquea. Aparecen en un orden predecible porque cada uno se apoya en el anterior.
Fallo de la etapa 1: tres versiones de cada cuenta
Los formularios web crean cuentas. Las importaciones de listas crean cuentas. Los comerciales crean cuentas a mano cuando la búsqueda les falla, y cada herramienta de enriquecimiento escribe su propia versión de vuelta. Sin una clave de emparejamiento obligatoria, normalmente el dominio web normalizado para las cuentas y el email en minúsculas para los contactos, el CRM sigue multiplicando la misma empresa. El daño se extiende aguas abajo: la asignación por turnos asigna el mismo comprador a dos comerciales, la atribución cuenta dos veces una misma operación y los informes de pipeline no cuadran con finanzas. La encuesta de Validity de 2026 encontró que casi un tercio de los equipos dedica seis o más horas a la semana solo a corregir y conciliar datos. Es una jornada laboral completa cada semana sin avanzar.
Fallo de la etapa 2: traspasos que viven en la bandeja de entrada de alguien
En la etapa 2 las herramientas están conectadas, pero la transferencia de la responsabilidad no. Marketing cualifica un lead y se lo dice al equipo de SDR por Slack. El SDR agenda una reunión y el AE se entera por una invitación de calendario. Ninguna de esas transiciones se registra como un evento con responsable y marca de tiempo, así que nadie puede medir el hueco entre ellas. El coste de ese hueco está bien documentado. En el estudio de Harvard Business Review sobre 2.241 empresas estadounidenses (Oldroyd, McElheran y Elkington, 2011), la primera respuesta media a un lead web tardó 42 horas, y las empresas que respondían en menos de una hora tenían casi siete veces más probabilidades de cualificar el lead que las que esperaban aunque solo fuera una hora más.
Fallo de la etapa 3: señales que acaban en un informe en lugar de en una cola
Los equipos en la etapa 3 tienen registros limpios y traspasos con marca de tiempo, así que su reporting por fin funciona. El fallo aquí es más sutil. Los anuncios de financiación, los picos de contratación, las visitas a la página de precios y las caídas de uso del producto se capturan, y después aparecen en un panel que alguien revisa el lunes. Una señal sin ruta y sin responsable es un dato histórico, no un disparador. Cuando llega la revisión semanal, la ventana de acción de la mayoría de las señales de compra ya se ha cerrado.
Fallo de la etapa 4: automatización que falla en silencio
La etapa 4 es donde los equipos conectan Clay, n8n o Zapier y el CRM en flujos de trabajo reales. El modo de fallo es la automatización que nadie vigila. Un proveedor de enriquecimiento renombra un campo, una tarea de sincronización se agota a mitad de un lote, un bucle de reintentos escribe la misma tarea cuarenta veces, y la primera persona en darse cuenta es un comercial que pregunta por qué su cola está vacía. La encuesta de martech de Gartner de 2023 encontró que los equipos de marketing usaban solo un tercio de la capacidad de su stack, frente al 58% de 2020. Más herramientas no produjeron más capacidad, porque nadie era responsable de la capa entre ellas.
Fallo de la etapa 5: autonomía sobre datos en los que nadie confía
El fallo más reciente son agentes que actúan sobre datos de entrada malos. El informe de Validity de 2026 encontró que casi el 78% de los encuestados de la alta dirección había actuado según una recomendación de IA que después sospechó que era errónea, y que solo el 21% de los profesionales de marketing describía los datos de su CRM como muy bien preparados para la IA. Un agente autónomo no arregla una capa de datos de etapa 1. La escala.
Arquitectura de referencia
Estas son las cinco etapas como capas de una misma arquitectura. Cada bloque indica cómo es el stack en esa etapa, qué contrato de datos falta y la prueba de salida: una pregunta que deberías poder responder desde el sistema, sin una hoja de cálculo, antes de avanzar.
Cómo es el stack: El CRM es una lista de contactos. El pipeline vive en hojas de cálculo, la previsión en la cabeza del CRO y la propiedad en quien tocó el registro por última vez.
Contrato que falta: Un registro canónico. No hay una clave de emparejamiento obligatoria para cuentas o contactos, ni campos obligatorios en los cambios de etapa.
Prueba de salida: ¿Cuántas cuentas activas tenemos y quién es responsable de cada una?
Cómo es el stack: Un CRM más un conjunto creciente de herramientas puntuales unidas por sincronizaciones nativas y zaps puntuales. Los registros están mayormente limpios. Las personas mueven el trabajo entre áreas con mensajes.
Contrato que falta: Eventos de traspaso. Cada cambio de responsable debería escribir un evento con el responsable, una marca de tiempo y un SLA.
Prueba de salida: ¿Cuál fue el mes pasado nuestro tiempo mediano desde el formulario hasta el primer contacto humano, por origen?
Cómo es el stack: Los eventos del ciclo de vida tienen marca de tiempo y el reporting es fiable. Una persona con nombre es responsable de la calidad de los datos. Las señales se capturan y se revisan.
Contrato que falta: Enrutamiento de señales. Cada tipo de señal necesita un responsable, una ventana de acción y una cola de destino.
Prueba de salida: De las señales de mayor intención de la semana pasada, ¿cuántas llegaron a un responsable dentro de su ventana de acción?
Cómo es el stack: Los flujos de trabajo se ejecutan entre herramientas con una capa de orquestación que gestiona el estado, los reintentos y los registros. Sistemas como la asignación de leads y la gestión de traspasos funcionan de forma continua.
Contrato que falta: Observabilidad. Cada acción automatizada necesita una entrada en el registro, una ruta de error y una alerta cuando falla o deja de ejecutarse.
Prueba de salida: ¿Qué automatizaciones fallaron esta semana y qué afectó cada fallo?
Cómo es el stack: Los sistemas detectan, deciden dentro de unos límites, actúan y lo registran. Las personas se ocupan de las excepciones, las aprobaciones y la estrategia en lugar de mover registros.
Contrato que falta: Pruebas. Cada sistema se prueba con casos históricos antes de actuar, y cada acción que realiza es reversible o pasa por la aprobación de una persona.
Prueba de salida: ¿Qué hicieron ayer nuestros sistemas por su cuenta, y qué parte de eso habría hecho igual un operador sénior?
Si quieres puntuarte rápidamente, la lógica cabe en unas pocas líneas. Los umbrales son puntos de partida sugeridos, no benchmarks del sector, así que ajústalos a tu modelo comercial:
stage = 1
if duplicate_account_rate < 2% and required_fields_enforced:      stage = 2
if stage == 2 and handoffs_timestamped and sla_breach_rate_known: stage = 3
if stage == 3 and signals_routed_within_action_window > 80%:      stage = 4
if stage == 4 and silent_failures_detected_same_day:             stage = 5
# a single failed check caps the stage, whatever tools you own
Secuencia de construcción
Subir una etapa es una construcción, no una compra. Esta es la secuencia que usamos, porque cada paso produce los datos de los que depende el siguiente.
Puntúa tu etapa actual con exportaciones, no con opiniones
Extrae, en modo solo lectura, las exportaciones de cuentas, contactos, leads y oportunidades. Aplica las cinco pruebas de salida a los propios datos. Allí donde una pregunta necesite una hoja de cálculo para responderse, está tu techo.
Establece el registro canónico
Elige las claves de emparejamiento (dominio normalizado para las cuentas, email en minúsculas para los contactos), fusiona los duplicados existentes y bloquea los nuevos en cada punto de entrada: formularios, importaciones, creación manual y escrituras de enriquecimiento. Haz obligatorios los campos de los cambios de etapa.
Pon marca de tiempo a cada traspaso
Modela cada cambio de responsable como un evento con responsable, marca de tiempo y SLA. Alerta automáticamente de los incumplimientos. Aquí es donde el speed-to-lead deja de ser un eslogan y se convierte en una cifra cuya tendencia puedes seguir.
Enruta las señales por ventana de acción
Haz una lista de tus tipos de señal, asigna a cada uno un responsable y una ventana, y envíalas a colas en lugar de a paneles. Una señal que llega después de cerrarse su ventana debería registrarse como una oportunidad perdida, no descartarse sin decir nada.
Pon una capa de orquestación al mando del estado
Saca los reintentos, la gestión de errores y los registros de los zaps individuales y llévalos a una sola capa que conozca el estado de cada registro en curso. Las herramientas puntuales siguen haciendo lo que hacen bien, mientras la capa de orquestación se encarga de lo que ocurre cuando fallan.
Prueba con tu propio historial antes de conceder autonomía
Antes de que un sistema actúe por su cuenta, ejecútalo sobre unos veinte casos pasados propios, etiquetados por tu equipo. Si no coincide con lo que habría hecho un operador sénior con una frecuencia suficiente, no se pone en marcha.
Construir o comprar: ventajas y desventajas
Cada transición puede abordarse de tres formas. Ninguna es la adecuada en todas las etapas, y el error más caro es usar un enfoque de etapa 4 para resolver un problema de etapa 1.
| Enfoque | Mejor encaje | Coste de propiedad | Riesgo de fallo |
|---|---|---|---|
| Configuración nativa del CRM | De la etapa 1 a la 2: reglas de emparejamiento, campos obligatorios, validación, asignación básica | Bajo. Puede encargarse un administrador, pero se fragmenta a medida que se acumulan reglas entre objetos | Las reglas se quedan obsoletas tras las reorganizaciones y nadie lo nota hasta que los informes no cuadran |
| Herramientas puntuales unidas con iPaaS o herramientas de flujos | De la etapa 2 a la 3: enriquecimiento, asignación y alertas de traspaso entre unas pocas herramientas | Medio. Las licencias son baratas, pero el tiempo de depuración crece con cada herramienta que añades | Fallos silenciosos entre herramientas, sin un único responsable del estado |
| Construcción integrada, forward-deployed | De la etapa 3 a la 5: orquestación, enrutamiento de señales y autonomía probada dentro de tu stack actual | Más alto al principio, y acotado por un diagnóstico en lugar de quedar abierto | Ampliación del alcance si el trabajo empieza sin un diagnóstico de alcance fijo |
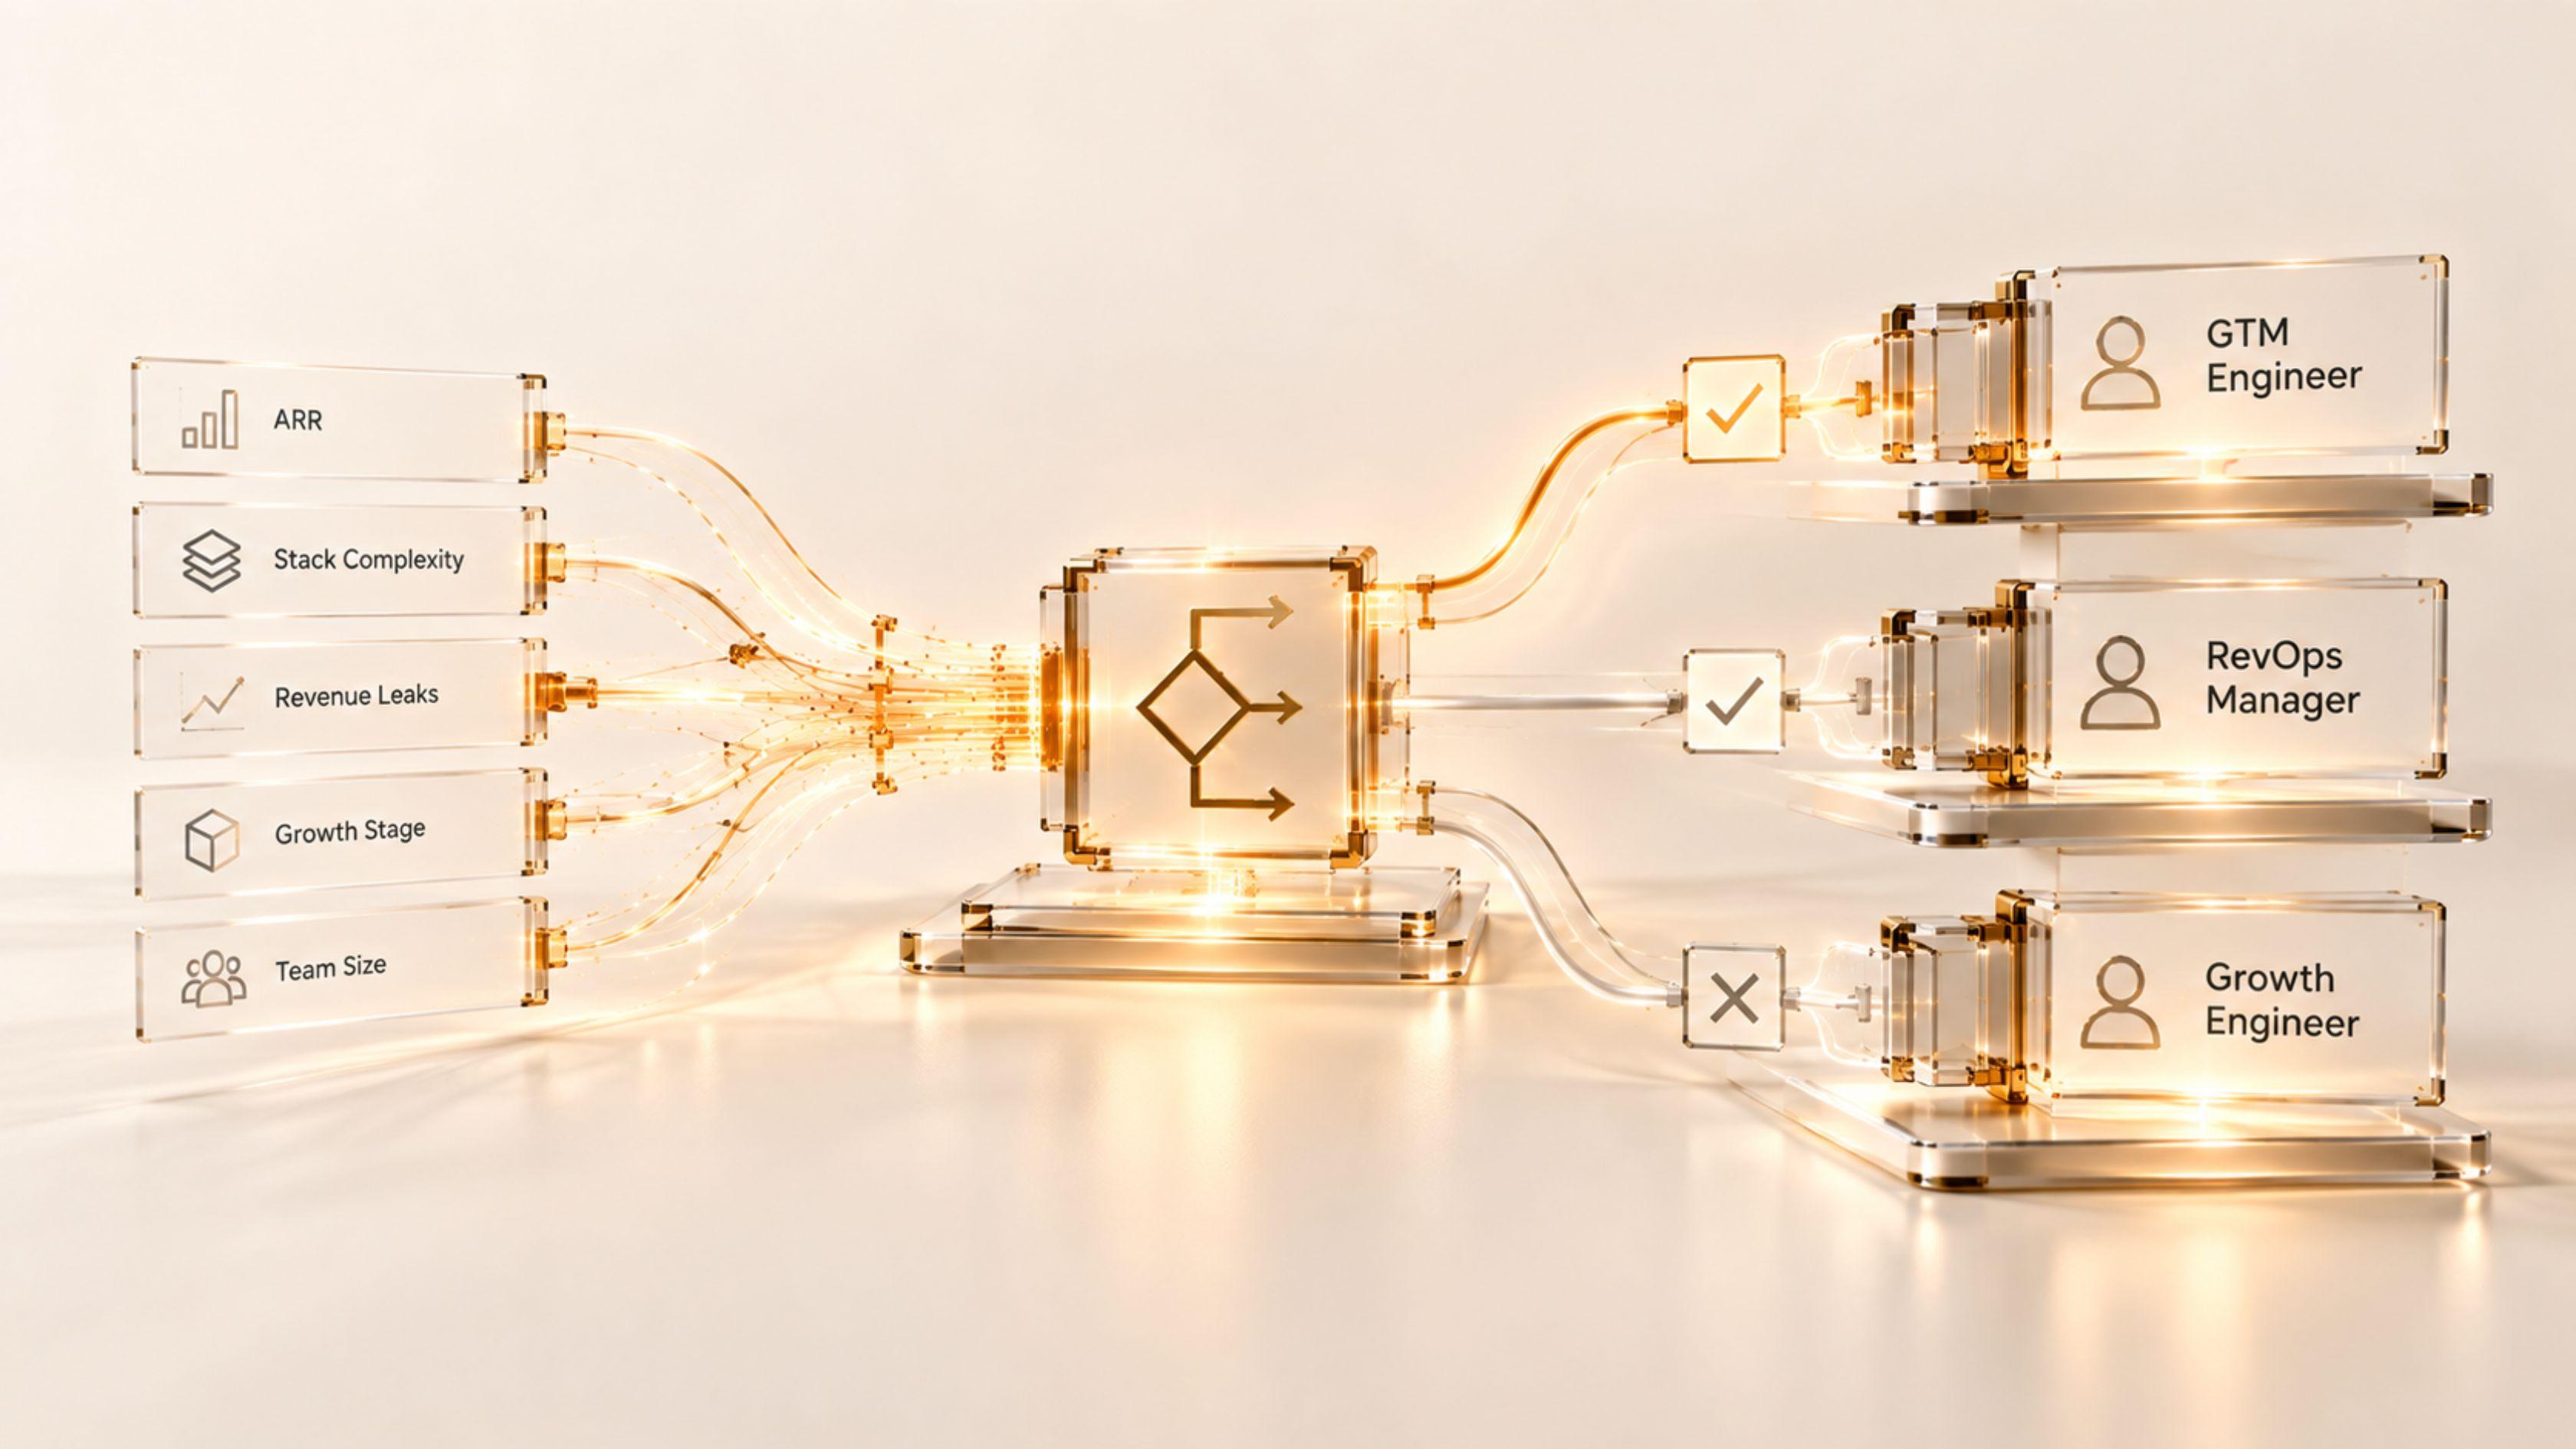
Un patrón común y costoso es un equipo de etapa 1 o 2 que compra herramientas de etapa 4 y se pregunta por qué no mejoró nada. Los datos de uso de Gartner apuntan en la misma dirección. Si todavía estás decidiendo quién debería encargarse de este trabajo, el árbol de decisión entre GTM engineer, responsable de RevOps y growth engineer relaciona la contratación con la etapa.
En producción
La madurez no es un hito que se supera una vez. Cada reorganización, cada herramienta nueva y cada segmento nuevo hacen retroceder un stack una etapa, a menos que alguien vigile las cifras adecuadas.
Sigue cada semana una métrica de salida por etapa: la tasa de cuentas duplicadas, la tasa de incumplimiento del SLA de traspaso, el tiempo de señal a acción y el número de fallos de automatización detectados por una alerta en lugar de por un comercial. Si cualquiera de ellas empeora dos semanas seguidas, has bajado una etapa, diga lo que diga el panel.
Cada acción automatizada escribe una entrada en el registro y tiene vuelta atrás. Todo lo que sea caro o difícil de revertir, como los precios, las condiciones contractuales o los mensajes a clientes actuales, queda detrás de una aprobación humana en todas las etapas. Nuestro propio listón es sencillo: un sistema se lanza con un 85 por ciento de acierto sobre los casos históricos del cliente, o no se lanza.
Los consejos no necesitan la arquitectura. Necesitan cuatro datos en una diapositiva: la etapa actual, el peor fallo que todavía se tolera, lo que ese fallo cuesta en dólares y la construcción que lo elimina. Eso convierte una hoja de ruta de RevOps en una decisión de asignación de capital que la dirección puede tomar de verdad.
Dónde encaja en el sistema
Cada transición de etapa corresponde a sistemas concretos que construimos. Pasar de la etapa 2 a la 3 es el trabajo de Speed-to-Lead y del Handoff Orchestrator, que convierten los traspasos en eventos con marca de tiempo y sujetos a un SLA. Mantener la etapa 3 depende del Pipeline Hygiene Sentinel, porque los datos instrumentados se degradan sin una aplicación continua. Pasar a la etapa 4 es donde el Signal-Based Outbound Engine enruta las señales por ventana de acción. La etapa 5 es donde sistemas como el Churn Signal Watchtower y el Board Report Engine funcionan por su cuenta con una persona atendiendo las excepciones. El mapa completo está en la página de sistemas.
El modelo también explica por qué integrar ingenieros solo funciona con un alcance acotado. Como defendimos en lo que el modelo forward-deployed de Palantir acierta y en qué falla para los equipos de ingresos, el trabajo forward-deployed sin un diagnóstico fijo se convierte en consultoría sin final. La etapa de madurez es ese diagnóstico. Te dice qué capa construir a continuación y te dice cuándo has terminado.
Los próximos artículos de esta serie usan el mismo vocabulario. Cuando escribamos sobre resolución de identidades, capas de orquestación o gobierno de agentes, la etapa te dirá si el artículo ya se aplica a ti.
Fuentes: Validity, State of CRM Data Management 2026 (n=500 profesionales de marketing, agosto de 2026). Salesforce, State of Sales, 5.ª edición (n=7.775 profesionales de ventas, diciembre de 2022). Gartner, encuesta de tecnología de marketing de 2023. Gartner, nota de prensa del 17 de mayo de 2021, sobre la adopción de RevOps en 2025. Oldroyd, McElheran y Elkington, "The Short Life of Online Sales Leads", Harvard Business Review, marzo de 2011.