Un CRO con el que hablamos el año pasado acababa de cerrar la compra de una nueva plataforma de asignación de leads. El caso de negocio era claro: los comerciales se quejaban de que los leads entrantes pasaban días sin atender, marketing culpaba a ventas, ventas culpaba a marketing, y alguien en el consejo había leído que responder rápido se correlaciona con la tasa de cierre. Seis meses y una implementación después, el tiempo de respuesta en el panel se veía mejor. La conversión del pipeline no se movió. Cuando extrajimos el registro de eventos en bruto durante una auditoría posterior, la fuga real estaba tres pasos más abajo de la asignación: un traspaso entre SDR y AE en el que el registro de la oportunidad quedaba en un campo de estado del que nadie era responsable, esperando un mensaje manual de Slack que llegaba, de media, un día y medio después de que la herramienta de asignación hubiera hecho su trabajo a la perfección. Habían comprado la solución a un problema que no tenían y dejado intacta la fuga real.
Esta no es una historia sobre una mala herramienta. La plataforma de asignación funcionó tal como estaba diseñada. Es una historia sobre diagnosticar en la capa equivocada del sistema: tratar un síntoma visible como la causa raíz porque nadie había seguido el objeto (el lead y después la oportunidad) a lo largo de todo su ciclo de vida antes de firmar la orden de compra.
Es un problema de sistemas, no de personas ni de herramientas, porque el modo de fallo es estructural: los equipos de ingresos compran contra un síntoma que pueden ver (respuesta lenta, previsión fallida, picos de abandono) sin rastrear antes qué objeto, campo o traspaso del pipeline es el que realmente falla. Una herramienta comprada contra un síntoma mejora el indicador que sustituye a ese síntoma y deja la fuga exactamente donde estaba, porque la fuga suele estar uno o dos saltos más allá de donde se siente el dolor. Diagnosticar antes de construir significa instrumentar todo el recorrido (campos, eventos, disparadores, tareas de sincronización) y encontrar dónde se detiene realmente el objeto, antes de decidir si la solución es un cambio de configuración, la reconstrucción de un flujo o un sistema verdaderamente nuevo. Nuestro propio proceso de entrada funciona con esta lógica: antes de dimensionar cualquiera de los nueve sistemas de VANDFORT para un cliente, el trabajo empieza con un Revenue Leak Report, un diagnóstico de solo lectura de tres semanas, precisamente porque hemos visto lo que ocurre cuando un equipo se salta ese paso. El patrón que sigue procede de hallazgos anonimizados de esas auditorías: no de un cliente concreto, sino de los patrones del registro de fugas que se repiten con la frecuencia suficiente para ser estructurales y no anecdóticos.
Dónde falla
1. Compras que imitan el síntoma
El antipatrón más común: se elige una herramienta porque su nombre coincide con el síntoma. La respuesta lenta a los leads recibe una herramienta de asignación. Las previsiones fallidas, una herramienta de previsión. El abandono, una plataforma de puntuación de salud. Pero el síntoma es un indicador rezagado que está aguas abajo de varios objetos (lead.created, lead.assigned, lead.status, opportunity.stage_changed) y el fallo real suele estar aguas arriba o en un traspaso entre dos sistemas, no dentro del sistema que toca la nueva herramienta.
2. Proliferación de herramientas sobre un objeto compartido y roto
Los equipos que ya intentaron corregir una fuga una vez suelen apilar una segunda y una tercera herramienta sobre el mismo campo en lugar de corregirlo. Con frecuencia encontramos tres o cuatro automatizaciones escribiendo en el mismo campo lead_status o account_stage con lógica contradictoria (una de la automatización de marketing, otra de una regla de flujo del CRM y otra de una herramienta de secuencias de prospección) porque cada nueva compra se dimensionó sin comprobar quién era ya responsable de ese campo.
3. Hojas de ruta guiadas por anécdotas
Los equipos de RevOps presionados para "hacer algo" suelen priorizar las correcciones según qué comercial se quejó más fuerte este trimestre, no según qué transición de etapa tiene la mayor caída ponderada por volumen. La historia de un solo AE sobre una operación perdida puede pesar más que una fuga que afecta a otras cuarenta cuentas, simplemente porque fue la fuga de la que la dirección oyó hablar en la QBR.
4. Sin línea base previa a la compra
Sin una línea base capturada antes de que una herramienta entre en funcionamiento, no hay forma de atribuir el cambio en la cifra a la compra frente a la estacionalidad, los cambios de plantilla comercial o una actualización de precios lanzada el mismo trimestre. Hemos visto equipos incapaces de responder, seis meses después de una compra, si la herramienta sirvió para algo, porque nadie exportó la línea base a nivel de evento antes de la implementación.
5. Selección guiada por demos
Las demos de los proveedores están diseñadas para lucir bien con conjuntos de datos pequeños y limpios. El fallo aparece después, frente al volumen real de datos del cliente, su tasa de duplicados y la incoherencia de sus campos. Una herramienta elegida con una demo de 20 registros suele romperse la primera vez que se enfrenta a un CRM con 40.000 contactos duplicados y una taxonomía de etapas que cuatro responsables de RevOps distintos han redefinido cuatro veces.
Arquitectura de referencia
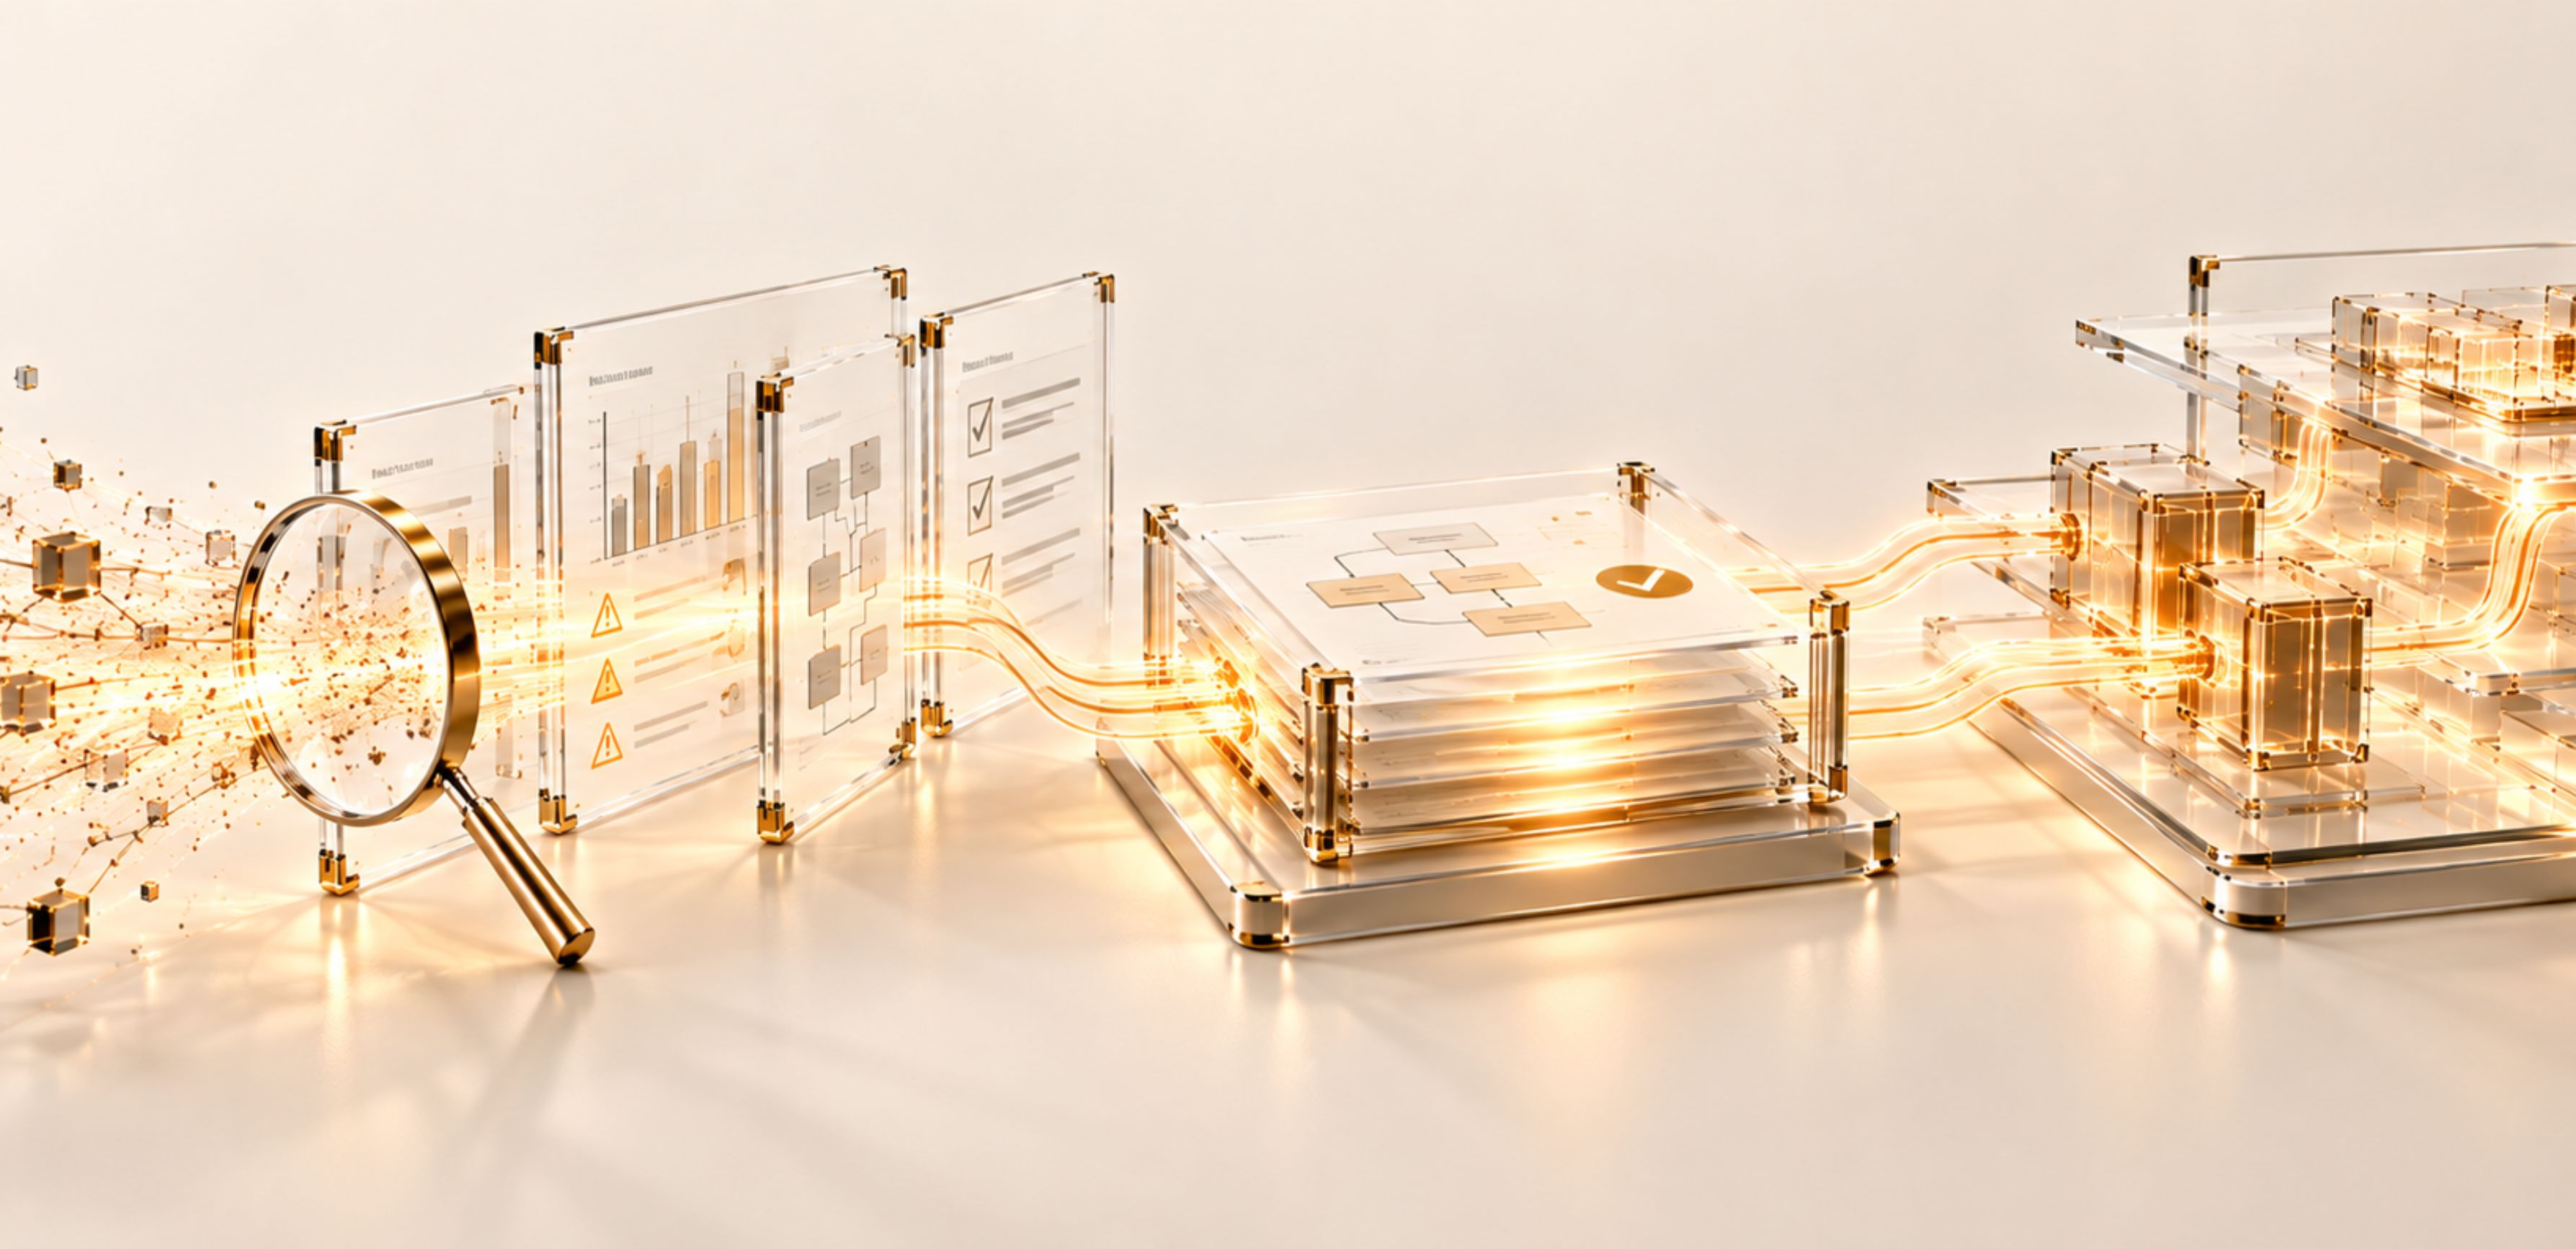
El diagnóstico sigue una arquitectura por capas, la misma que usamos para decidir cuáles de los nueve sistemas necesita realmente un motor de ingresos. Cada capa se audita por separado, con su propio contrato de datos hacia la capa superior, antes de proponer cualquier corrección (herramienta, flujo o sistema).
Señal en bruto: CRM (Salesforce, HubSpot), automatización de marketing (Marketo, HubSpot), eventos de uso del producto, soporte y tickets (Zendesk, Intercom), inteligencia de llamadas (Gong, Chorus). Contrato con la capa siguiente: cada objeto (lead, cuenta, oportunidad, ticket) debe llevar un ID externo estable y un registro de eventos con marca de tiempo, no solo un campo con el estado actual.
Emparejamiento de cuentas y contactos, lógica de deduplicación, comprobaciones de completitud de campos. Componentes: reglas de emparejamiento basadas en el dominio y el nombre de empresa normalizado, auditorías de la tasa de nulos en campos obligatorios (sector, nivel de ICP, propietario). Contrato con la capa siguiente: un único registro canónico de cuenta o contacto por entidad real, con una puntuación de confianza del emparejamiento documentada, antes de que cualquier lógica de orquestación lea de él.
Reglas de asignación, disparadores de SLA, tareas de sincronización entre sistemas (herramientas iPaaS como Workato o Zapier, o la automatización nativa del CRM). Contrato con la capa siguiente: cada disparador se activa ante un evento definido, escribe en un único campo con responsable y registra una marca de tiempo: nada de escrituras silenciosas ni de automatizaciones huérfanas sin un responsable claro.
El CRM como fuente de verdad para la etapa, la categoría de previsión y la propiedad. Contrato con la capa siguiente: las definiciones de etapa están documentadas y se aplican (no solo tienen nombre), y cada transición de etapa se registra como un evento, no se sobrescribe en el mismo campo.
Las personas y los agentes de IA que actúan sobre los datos: comerciales, responsables de CS y los sistemas de GTM Operations, Sales Operations, CS Operations y Revenue Intelligence. Contrato: esta capa solo actúa sobre datos que ya han pasado limpios por las capas 1-4; no compensa los fallos de más arriba con soluciones manuales.
Secuencia de construcción
Construir o comprar: ventajas y desventajas
Una vez diagnosticada y clasificada una fuga, la pregunta deja de ser "qué herramienta" y pasa a ser "qué arquitectura encaja con esta corrección concreta". Los tres caminos habituales tienen perfiles distintos de coste de propiedad y de fallo.
| Enfoque | Mejor encaje | Coste de propiedad | Riesgo de fallo |
|---|---|---|---|
| Flujo o automatización nativa del CRM | Correcciones de un solo campo o disparador contenidas por completo en un sistema (p. ej., una alerta por cambio de etapa, una regla de validación de campo) | Bajo: sin licencia nueva, lo mantiene el administrador actual del CRM | Bajo con lógica sencilla; falla en silencio a medida que crecen las reglas y empiezan a entrar en conflicto |
| iPaaS o herramienta de flujos (p. ej., Workato, Zapier, Make) | Correcciones que abarcan dos o más sistemas con un contrato de datos claro y estable (del CRM a la herramienta de soporte, de la automatización de marketing al CRM) | Medio: licencia nueva y mantenimiento continuo a medida que cambian los esquemas de origen | Medio: las tareas de sincronización fallan en silencio cuando el esquema cambia; requiere monitorización y reintentos |
| Código a medida o agente de IA | Correcciones que requieren criterio, datos no estructurados o una lógica demasiado compleja para flujos visuales (puntuación de señales, detección de patrones de abandono, generación de narrativas de previsión) | Más alto al inicio y más bajo a largo plazo si se construye y se mantiene bien, sin el lastre de las licencias por usuario | El más alto si se construye sin probarlo antes con los datos del propio cliente; el más bajo de los tres una vez validado con el volumen de producción |
El error que más vemos es recurrir a la tercera opción (código a medida o un agente) antes de confirmar que la fuga no es en realidad una corrección de la primera opción: una regla de validación que falta o un campo sin responsable que un flujo nativo podría resolver en una tarde.
En producción
Una vez lanzada una corrección, el registro de fugas no se archiva; se convierte en la línea base de monitorización. Sigue cada semana las mismas métricas de tasa de conversión y tiempo en la etapa frente a las cifras previas a la corrección, no un indicador genérico del panel, para que la deriva aparezca antes de que un comercial la vuelva a notar de forma anecdótica.
Cada tarea de sincronización y cada disparador construidos para corregir una fuga necesitan un estado de fallo explícito: qué ocurre cuando el campo de origen está vacío, cuando la API limita las peticiones o cuando dos automatizaciones intentan escribir el mismo campo a la vez. Diseña la alternativa (cola, alerta, revisión humana) antes del lanzamiento, no después de descubrir el primer fallo silencioso tres semanas más tarde.
La dirección no necesita la lógica del disparador; necesita el antes y el después en el registro de fugas: esta etapa convertía al X, encontramos que el fallo estaba en este campo o traspaso, lo corregimos y ahora convierte al Y, lo que vale Z en pipeline recuperado. Ese enfoque es también lo que justifica no comprar la siguiente herramienta hasta haber medido la corrección actual.
Dónde encaja en el sistema
El diagnóstico descrito aquí es la puerta de entrada al modelo de trabajo de VANDFORT, no un servicio aparte. Un Revenue Leak Report produce el registro de fugas ordenado; las correcciones que salen de él se asignan directamente a sistemas concretos en lugar de a herramientas genéricas. Un traspaso roto entre SDR y AE, el patrón de nuestro ejemplo inicial, es exactamente lo que el Handoff Orchestrator está diseñado para cerrar, con campos definidos y disparadores de SLA en lugar de un mensaje de Slack que alguien olvida enviar. Un primer contacto lento o irregular con los leads entrantes es aquello contra lo que se dimensiona el sistema Speed-to-Lead, una vez que la auditoría confirma que el fallo está realmente en esa capa y no más abajo. Y cuando la fuga son datos de pipeline obsoletos o sin gobierno que alimentan una mala previsión, ese es el terreno del Pipeline Hygiene Sentinel. La razón de diagnosticar primero es que el registro de fugas te dice cuál de los nueve sistemas, si alguno, resuelve realmente el fallo ponderado en dólares, en lugar de partir de una categoría de herramienta y buscar después una justificación.