Una empresa en serie B contrata a su primera GTM engineer. Es buena. En catorce meses lanza la asignación de leads, una cascada de enriquecimiento, una alerta de Slack para cuentas de alta intención y una tarea nocturna que concilia el uso del producto con el CRM. Después acepta una oferta mejor. Tres semanas más tarde, los leads entrantes dejan de asignarse. Al equipo le cuesta cuatro días descubrir por qué: el flujo que escribía Lead.OwnerId se ejecutaba con su cuenta personal en una herramienta de automatización, autenticado con su clave de API, y la clave se revocó cuando IT la dio de baja. Nadie más sabía que ese flujo existía, y mucho menos cuáles de los otros ochenta dependían de él.
Cerca de allí, una empresa parecida tomó el otro camino y compró una plataforma de ingresos con asignación, secuencias y puntuación incluidas. La implantación fue bien. Once meses después, la plataforma usa una regla de emparejamiento de lead a cuenta que no coincide con la del CRM, los objetos personalizados nunca se sincronizaron y una responsable de RevOps pasa los viernes exportando CSV para responder preguntas que la plataforma debía responder. Ninguna hizo una mala contratación ni compró una mala herramienta. Las dos tomaron una decisión de arquitectura sin darse cuenta.
La demanda de este trabajo no está en duda. El análisis de Bloomberry de 2026 sobre esas mismas 1.000 ofertas concluyó que, por responsabilidades, los puestos de GTM engineering y de RevOps son en gran medida el mismo trabajo, con más peso en la automatización y la integración. Lo que sigue sin resolverse es el modelo operativo. La mayoría de las empresas lo plantea como una cuestión de contratación, y eso oculta las dos decisiones que determinan si la función funciona. La primera es qué capas del stack de ingresos necesitas poseer y cuáles alquilar. La segunda es quién conserva el estado de cada proceso automatizado (las credenciales, las reglas de escritura en campos, la lógica de reintentos y los registros) cuando la persona que lo construyó ya no está.
Si lo tratas como un problema de sistemas, las tres opciones se vuelven comparables. Contratar significa incorporar a alguien y poseer todas las capas. Comprar significa licenciar una plataforma y aceptar su modelo de datos. Integrar significa traer un equipo de forward-deployed engineering que primero diagnostica, construye dentro de tu stack actual y entrega sistemas que tu equipo puede operar. Cada uno falla de una forma predecible, y cada fallo señala los objetos que se rompen.
Dónde falla
Todos estos modos de fallo son de arquitectura, y por eso una contratación mejor o una herramienta mejor rara vez los resuelve.
Contratar: el stack con un solo responsable
Una contratación interna avanza rápido porque no hay ningún proceso que la frene. Esa velocidad se acumula como estado sin documentar: flujos creados con un usuario personal, claves de API emitidas a una persona en lugar de a una cuenta de servicio, columnas de enriquecimiento que escriben en campos del CRM que nadie más sabe que están gestionados, y tareas programadas que solo existen en la interfaz de una herramienta. El factor bus de todo el motor de ingresos es uno. La Oficina de Estadísticas Laborales de EE. UU. informó en septiembre de 2026 de que la antigüedad mediana en el empleador actual era de 3,0 años para los trabajadores de 25 a 34 años, la franja de edad en la que se encuentran la mayoría de los primeros GTM engineers. Si el sistema no sobrevive a una dimisión, no es un sistema.
Contratar: incorporar a alguien a un stack que nadie ha diagnosticado
Los datos de Bloomberry muestran ofertas que piden una media de 4,11 años de experiencia, con SQL y Python presentes cada uno en el 38% de los anuncios. Las empresas contratan ingenieros. Luego los ponen ante un CRM con tres versiones de cada cuenta y sin traspasos con marca de tiempo, y los dos primeros trimestres se van en fusionar duplicados y rehacer reglas de validación. Sin un diagnóstico antes de contratar, el puesto se define en torno a los síntomas, y el ingeniero pasa un año descubriendo lo que una auditoría de solo lectura habría mapeado en semanas. Desarrollamos este argumento en el playbook de diagnosticar antes de construir.
Comprar: la plataforma configurada para la demo, no para tu modelo de datos
Las plataformas vienen con un esquema propio. El fallo aparece en las juntas: la lógica de emparejamiento de cuentas del proveedor no coincide con la de tu CRM, los objetos personalizados como Subscription__c o una tabla de uso del producto no forman parte de la sincronización, los mapeos de campos bidireccionales se sobrescriben entre sí, y las reglas de asignación de la plataforma viven fuera del CRM, donde tu administrador no puede auditarlas. La encuesta de tecnología de marketing de Gartner de 2023 encontró que los equipos de marketing usaban solo un tercio de la capacidad de su stack, frente al 58% de 2020.
Comprar: suponer que el proveedor asume el aprendizaje
El argumento más sólido para comprar viene de la IA. El estudio de MIT NANDA de 2025, basado en 150 entrevistas a directivos, una encuesta a 350 empleados y 300 despliegues públicos, encontró que las herramientas compradas a proveedores especializados tenían éxito alrededor del 67% de las veces, mientras que los desarrollos internos lo tenían solo un tercio de las veces. La misma investigación situó el fallo en una brecha de aprendizaje: las herramientas genéricas que no se adaptan a los flujos de trabajo de la organización se estancan. Comprar ayuda cuando el proveedor adapta la herramienta a tu proceso. Perjudica cuando tu proceso tiene que doblarse alrededor de la herramienta, y el trabajo de configuración que cierra esa brecha sigue teniendo que hacerlo alguien.
Integrar: trabajos sin límite ni entrega
Un equipo integrado puede cerrar la brecha entre contratar y comprar, pero tiene su propio modo de fallo. Sin un diagnóstico de alcance fijo, el trabajo integrado se convierte en consultoría sin final, como explicamos en lo que el modelo forward-deployed de Palantir acierta y en qué falla para los equipos de ingresos. Sin un contrato de entrega, reproduce el problema del responsable único a nivel de proveedor: la lógica se ejecuta en las cuentas del proveedor y los runbooks viven en sus cabezas.
Arquitectura de referencia
La decisión se simplifica cuando dejas de elegir un modelo para toda la función y eliges uno por capa. Cada bloque indica los componentes, herramientas de ejemplo (ejemplos, no recomendaciones), el contrato de datos que entrega a la capa siguiente y qué modelo suele encajar.
Componentes: Formularios web, eventos del producto, proveedores de enriquecimiento y de intención, actividad de calendario y email, facturación.
Herramientas de ejemplo: Creadores de formularios, un pipeline de analítica de producto, proveedores de enriquecimiento, el sistema de facturación.
Contrato con la capa siguiente: Cada evento lleva un origen, una marca de tiempo y un identificador en bruto (email, dominio o ID de cuenta).
Mejor encaje: Comprar. Las fuentes son productos estándar, y construir tu propio enriquecimiento rara vez compensa.
Componentes: Claves de emparejamiento, reglas de fusión, campos obligatorios y validación en cada punto de entrada, incluidas las importaciones y las escrituras de enriquecimiento.
Herramientas de ejemplo: Reglas nativas de duplicados del CRM, herramientas de deduplicación dedicadas, un modelo de identidad en el almacén de datos.
Contrato con la capa siguiente: Un único ID canónico de cuenta y de contacto, con una regla documentada sobre cómo se resolvió.
Mejor encaje: Poseerla, ya sea construida internamente o integrada y entregada. Tu lógica de emparejamiento codifica tu negocio, así que no se puede alquilar.
Componentes: Asignación, SLA, gestión de señales, reintentos, rutas de error y registros.
Herramientas de ejemplo: Herramientas de flujos como n8n o Make, iPaaS, flujos del CRM o servicios a medida.
Contrato con la capa siguiente: Cada acción es idempotente, se registra con el ID del registro y se ejecuta con una cuenta de servicio.
Mejor encaje: Contratar o integrar. Esta capa guarda el estado que desaparece cuando las personas se van, así que debe ejecutarse con credenciales de la empresa y con la lógica bajo control de versiones.
Componentes: Objetos del CRM, etapas del ciclo de vida, campos de propiedad y el historial de auditoría.
Herramientas de ejemplo: Salesforce, HubSpot.
Contrato con la capa siguiente: Los cambios de etapa exigen campos obligatorios, y cada cambio de responsable se escribe como un evento con marca de tiempo.
Mejor encaje: Comprar la plataforma y poseer la configuración.
Componentes: Secuencias, alertas, redacción y resúmenes con IA, resultados de previsión y de reporting.
Herramientas de ejemplo: Plataformas de engagement, inteligencia de conversaciones, herramientas de IA especializadas.
Contrato con la capa siguiente: Las acciones son reversibles o pasan por la aprobación de una persona, y cada una puede rastrearse hasta el dato que la provocó.
Mejor encaje: Comprar herramientas especializadas o integrar sistemas probados. Los datos del MIT favorecen aquí las herramientas especializadas frente a los desarrollos internos, siempre que alguien las adapte a tu flujo de trabajo.
Secuencia de construcción
Este orden funciona sea cual sea el modelo que elijas, y cada paso produce algo que se puede comprobar.
Diagnostica el stack en modo solo lectura
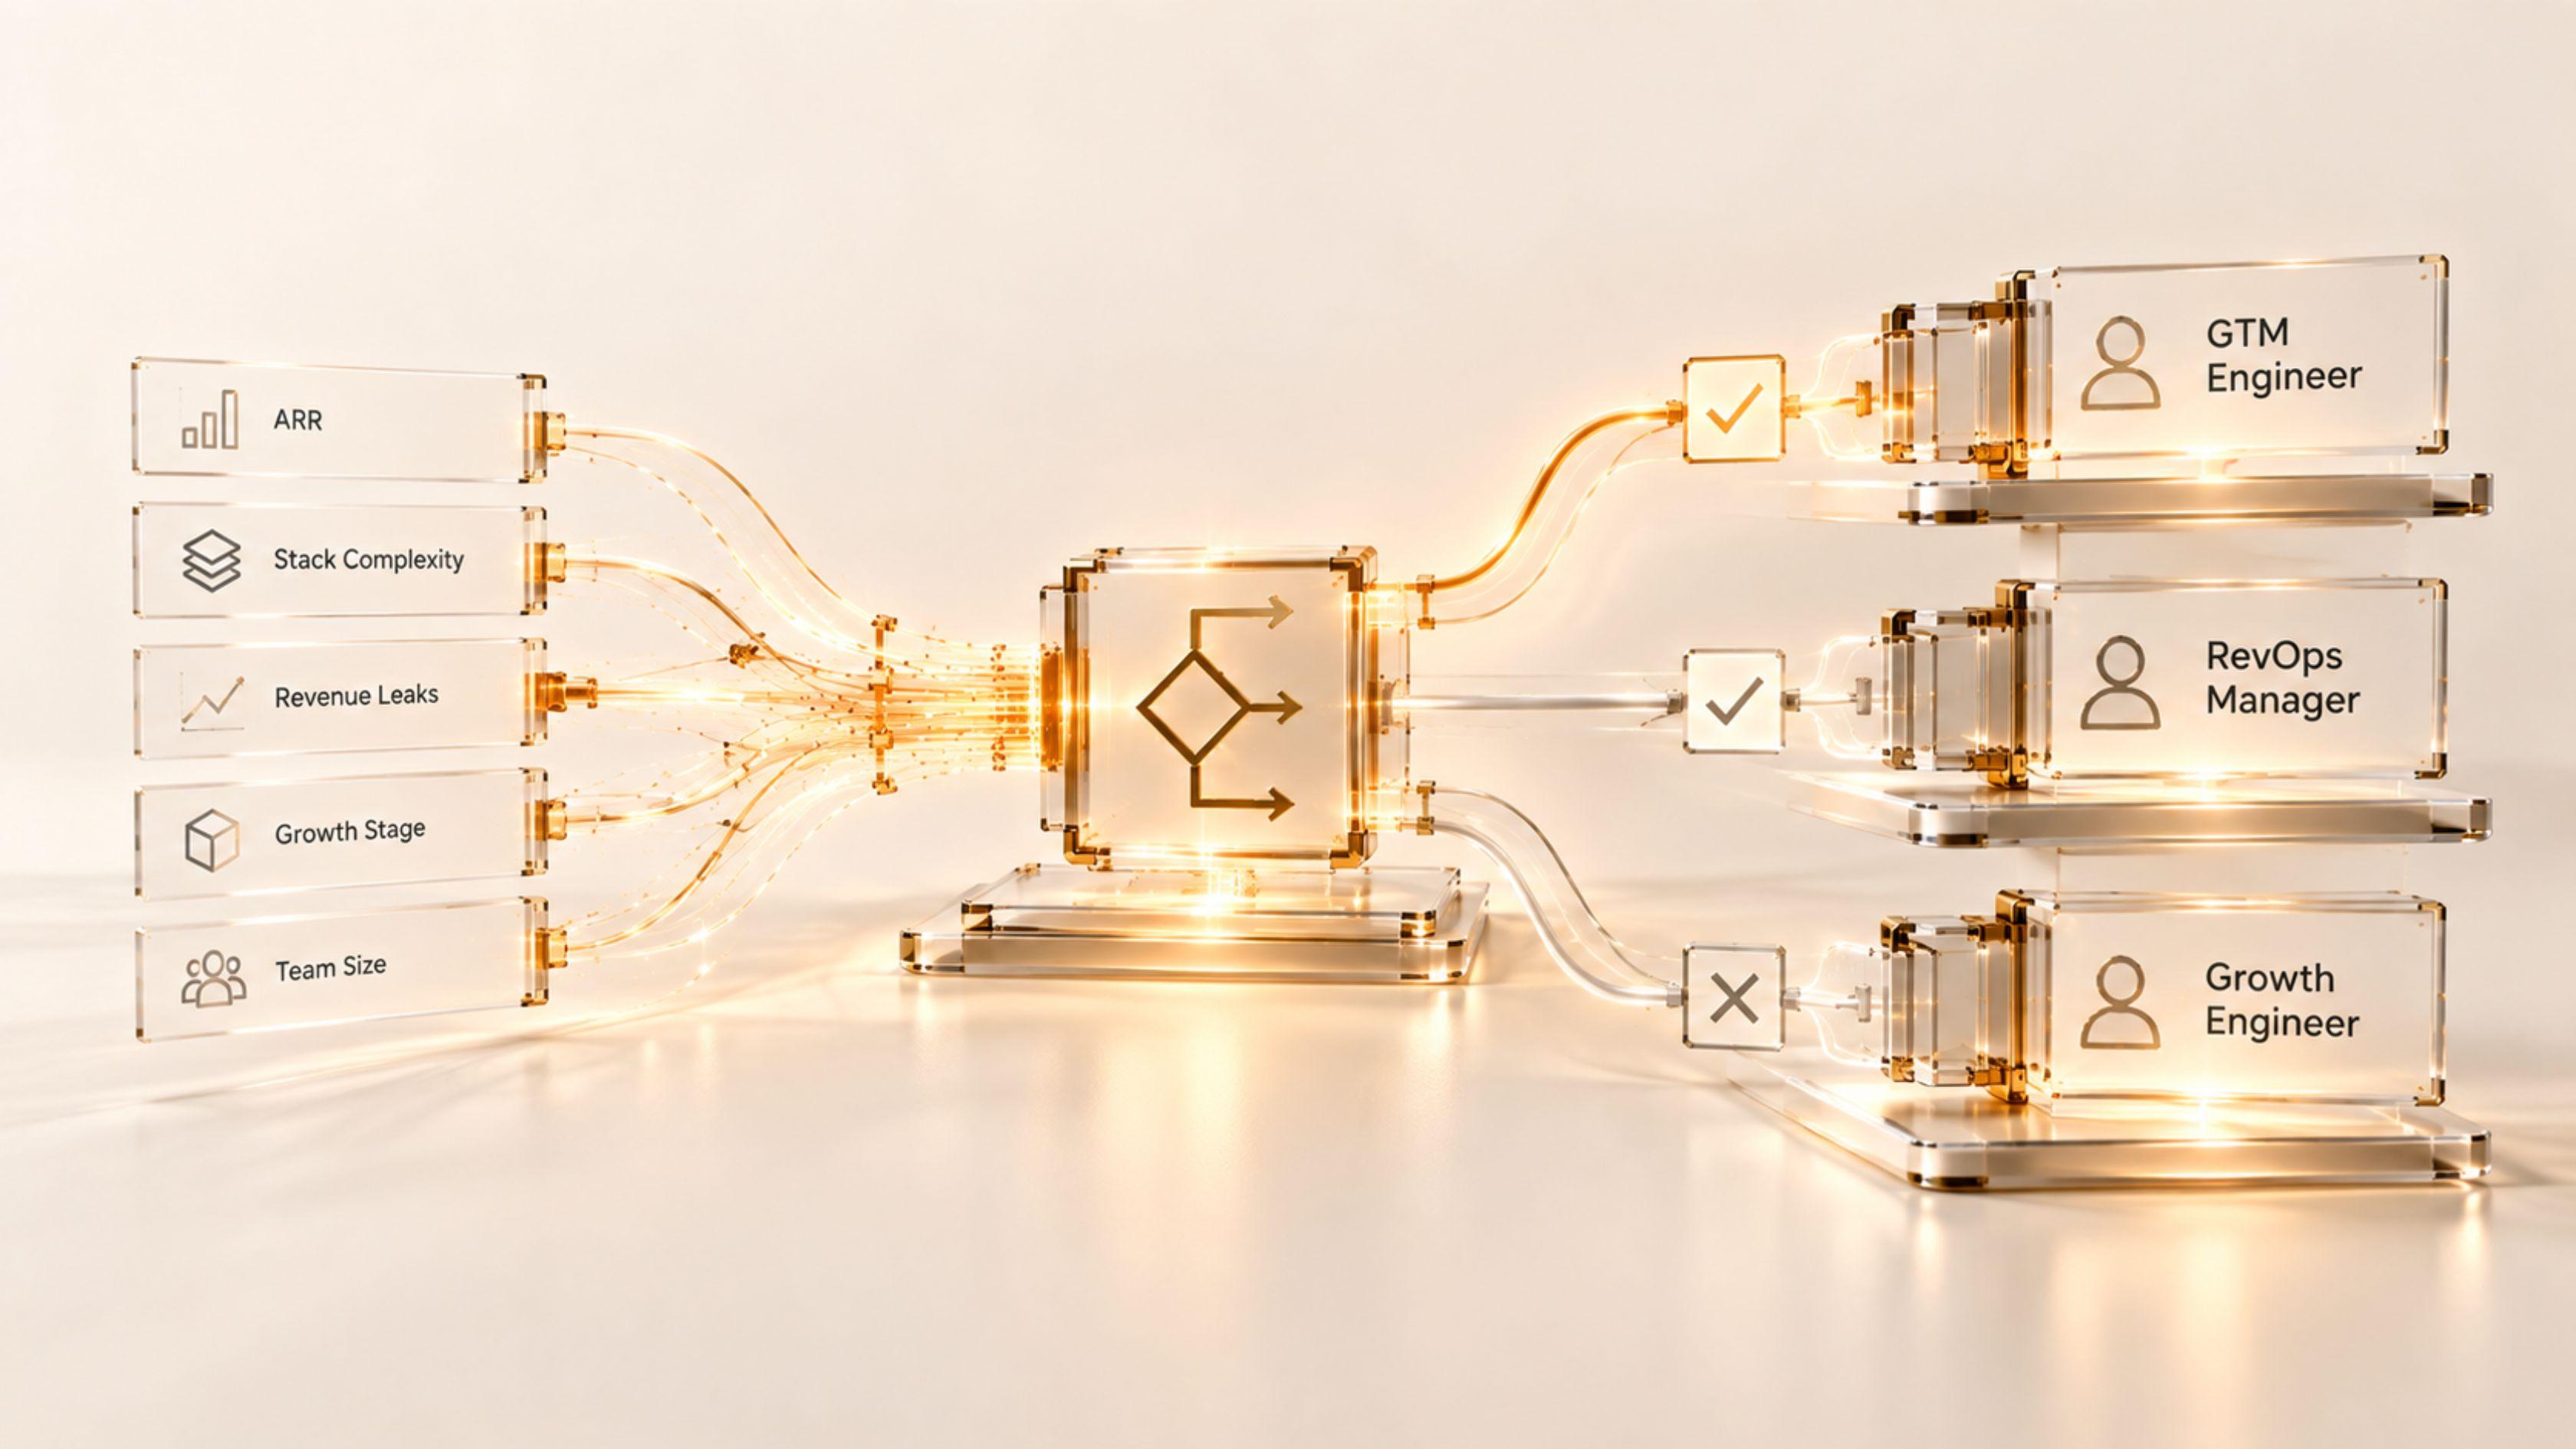
Exporta cuentas, contactos, leads, oportunidades e inventarios de automatizaciones. Mide la tasa de duplicados, los huecos en los traspasos y la proporción de preguntas sobre ingresos que necesitan una hoja de cálculo para responderse. Eso te sitúa en el modelo de madurez de RevOps y te dice qué capa falta, lo que a su vez te dice qué tipo de capacidad necesitas. Para la parte organizativa, el árbol de decisión entre GTM engineer, responsable de RevOps y growth engineer relaciona la contratación con la etapa.
Haz inventario de todo lo que guarda estado
Enumera cada flujo, integración, tarea programada y clave de API, y anota quién es responsable de cada uno y qué campos escribe. Todo lo que dependa de una cuenta personal va a una lista de migración.
Asigna un modelo por capa
Usa la arquitectura de referencia: compra las fuentes y el sistema de registro, quédate con la identidad y la orquestación, y decide la activación según si una herramienta especializada encaja con tu flujo de trabajo sin forzarlo demasiado.
Modela el coste y el tiempo hasta el primer sistema en producción
Compara los tres caminos con las mismas dos cifras: el coste del primer año y las semanas de calendario hasta que un sistema funcione en producción con tus datos. El modelo de abajo muestra la forma del cálculo.
Redacta el contrato de entrega antes de empezar cualquier trabajo
Cuentas de servicio en lugar de personales, lógica bajo control de versiones, un runbook por sistema, alertas enviadas a un canal del equipo y un responsable interno con nombre. Esto se aplica tanto a una contratación interna como a un proveedor.
Prueba con tu propio historial antes de la puesta en marcha
Ejecuta cada sistema sobre unos veinte casos pasados propios, etiquetados por tu equipo, antes de que toque registros reales. Fija de antemano el listón para aprobar. El nuestro es un 85 por ciento de coincidencia con lo que habría hecho un operador sénior, o el sistema no se lanza.
La comparación de costes es aritmética sencilla una vez que los datos de partida son honestos. El salario y el coste por contratación del modelo de abajo proceden de las fuentes citadas en este artículo. Todos los demás valores son marcadores para tus propias cifras, no benchmarks.
# Illustrative example: replace every assumption with your own inputs
build_year1   = base_salary * (1 + burden_rate) + cost_per_hire + tooling
              # base_salary  = 150,000   (RevGuild 2026 median base)
              # cost_per_hire = 4,700    (SHRM benchmarking, 2022)
              # burden_rate, tooling = your finance team's numbers
build_weeks   = weeks_to_fill + weeks_to_ramp + weeks_to_first_system
buy_year1     = license + implementation + internal_admin_time
buy_weeks     = weeks_to_implement + weeks_to_adapt_to_your_schema
embed_year1   = diagnostic + system_builds + internal_owner_time
embed_weeks   = diagnostic_weeks + weeks_to_first_system
# compare cost per system in production, not cost per head
La última línea cambia las decisiones. Una contratación puede parecer más barata por año y aun así costar más por sistema en funcionamiento cuando sumas los meses hasta que se lanza el primero, y una plataforma parece la más barata hasta que valoras el tiempo necesario para adaptarla a tu esquema.
Construir o comprar: ventajas y desventajas
Ninguno de los tres gana en todas partes. La tabla muestra dónde encaja cada uno y cómo suele fallar.
| Modelo | Mejor encaje | Coste de propiedad | Tiempo hasta el primer sistema en producción | Riesgo de fallo |
|---|---|---|---|---|
| Contratar: incorporar a alguien | Empresas con un stack diagnosticado, una hoja de ruta clara de varios sistemas y un responsable capaz de revisar trabajo técnico | Un salario completo antes de lanzar nada, más el coste de selección y las herramientas. El coste por sistema baja a medida que crece la hoja de ruta | El más lento: tiempo para cubrir el puesto, después la incorporación, después la construcción | Estado con un solo responsable, y puestos definidos en torno a los síntomas cuando no hubo un diagnóstico previo |
| Comprar: licenciar una plataforma | Capas estándar como las fuentes, el sistema de registro y herramientas de activación especializadas que encajan con tu proceso | Licencias predecibles, pero el tiempo interno de administración e integración crece con cada objeto personalizado | Rápido para el caso de uso del proveedor, más lento para el tuyo | Un desajuste de esquema en las juntas, y lógica que vive fuera de tu CRM |
| Integrar: equipo forward-deployed | Empresas que necesitan sistemas funcionando dentro de un stack existente antes de poder justificar o gestionar una contratación a tiempo completo | Acotado por un diagnóstico y un número de sistemas, no por plantilla. Requiere un responsable interno | Rápido: el diagnóstico encuentra el primer sistema, que después se prueba con tu historial | Alcance abierto sin un diagnóstico fijo, y estado en manos del proveedor sin un contrato de entrega |
En la práctica, las configuraciones más sólidas son híbridas. Un patrón habitual es integrar para diagnosticar y lanzar los primeros sistemas, comprar para las capas estándar y después contratar a un ingeniero u operador interno cuando ya hay un conjunto de sistemas en marcha que merece la pena poseer.
En producción
El modelo que elijas importa menos que si la función sobrevive al mes dieciocho.
Vigila quién guarda el estado, no solo los resultados. Una vez al mes, revisa el inventario de automatizaciones: cuenta los flujos que se ejecutan con credenciales personales (el objetivo es cero), las tareas sin alerta en caso de fallo y los campos que escribe más de una integración.
Cada sistema necesita una alternativa manual documentada y un interruptor de apagado que pueda usar un operador, no solo un ingeniero. Si el flujo de asignación se detiene, los leads deberían ir a una cola por defecto vigilada en lugar de no ir a ninguna parte. Las acciones difíciles de revertir, como los mensajes a clientes, los precios y los cambios de responsable en operaciones abiertas, quedan detrás de una aprobación humana sea cual sea el modelo que las construyó.
Presenta la elección como asignación de capital, no como plantilla. Muestra para cada modelo el coste del primer año, las semanas hasta el primer sistema en producción y el coste por sistema en producción, junto al valor en dólares de la fuga que cierra ese sistema. Los consejos financian antes fugas cerradas que cargos.
Dónde encaja en el sistema
La decisión de contratar, comprar o integrar es en realidad una decisión sobre quién pone en marcha y opera sistemas concretos. Para la mayoría de las empresas de entre $3M y $30M de ARR, los primeros candidatos están donde ocurren los traspasos: Speed-to-Lead y el Handoff Orchestrator viven en la capa de orquestación, la que más necesita un estado en propiedad y credenciales de la empresa. El Pipeline Hygiene Sentinel protege las capas de identidad y de sistema de registro de las que dependen todos los demás sistemas, y por eso compensa con cualquier modelo. Los sistemas de la capa de activación, como el Signal-Based Outbound Engine, solo funcionan cuando las capas inferiores se sostienen. El mapa completo está en la página de sistemas.
Aquí es también donde el modelo de integración se gana su sitio en la comparación. No es una alternativa a contratar. Bien hecho, es el paso que hace que la contratación funcione: un diagnóstico acotado, unos pocos sistemas probados con tus datos y funcionando en tus cuentas, y una entrega que convierte el primer trimestre del siguiente ingeniero en operación en lugar de arqueología.
Fuentes: Bloomberry, "I analyzed 1,000 GTM Engineering jobs" (Henley Wing Chiu, actualizado en enero de 2026). RevGuild, GTM Engineer Salary Market Report 2026 (datos de Glozo Talent Intelligence, n=71 puestos con salario publicado, julio de 2026). MIT NANDA, The GenAI Divide: State of AI in Business 2025 (agosto de 2025, según Fortune). Oficina de Estadísticas Laborales de EE. UU., Employee Tenure in January 2026 (septiembre de 2026). SHRM, "The Real Costs of Recruitment" (abril de 2022). Gartner, encuesta de tecnología de marketing de 2023.