Escenario ilustrativo. El vicepresidente de Ventas de una empresa SaaS en serie B publica una vacante de responsable de RevOps tras un mal trimestre. Los leads pasan dos días sin atender, las previsiones siguen desviándose 30 puntos y el consejo exige una explicación. Seis meses después, la nueva incorporación ha depurado sesenta reglas de validación de Salesforce, reconstruido tres paneles y heredado cuarenta tareas de Zapier sin documentar de un contratista de operaciones de ventas que ya se fue. Pero el tiempo de respuesta a los leads no ha cambiado, porque nadie diagnosticó que el fallo real era un webhook ausente entre la plataforma de automatización de marketing y Salesforce, no una carencia de informes. La empresa necesitaba un ingeniero capaz de construir un sistema y hacerse responsable de él. Contrató a un operador capaz de mantenerlo. El cargo no correspondía al problema, y nadie había puesto por escrito cuál era realmente ese problema antes de publicar la vacante.
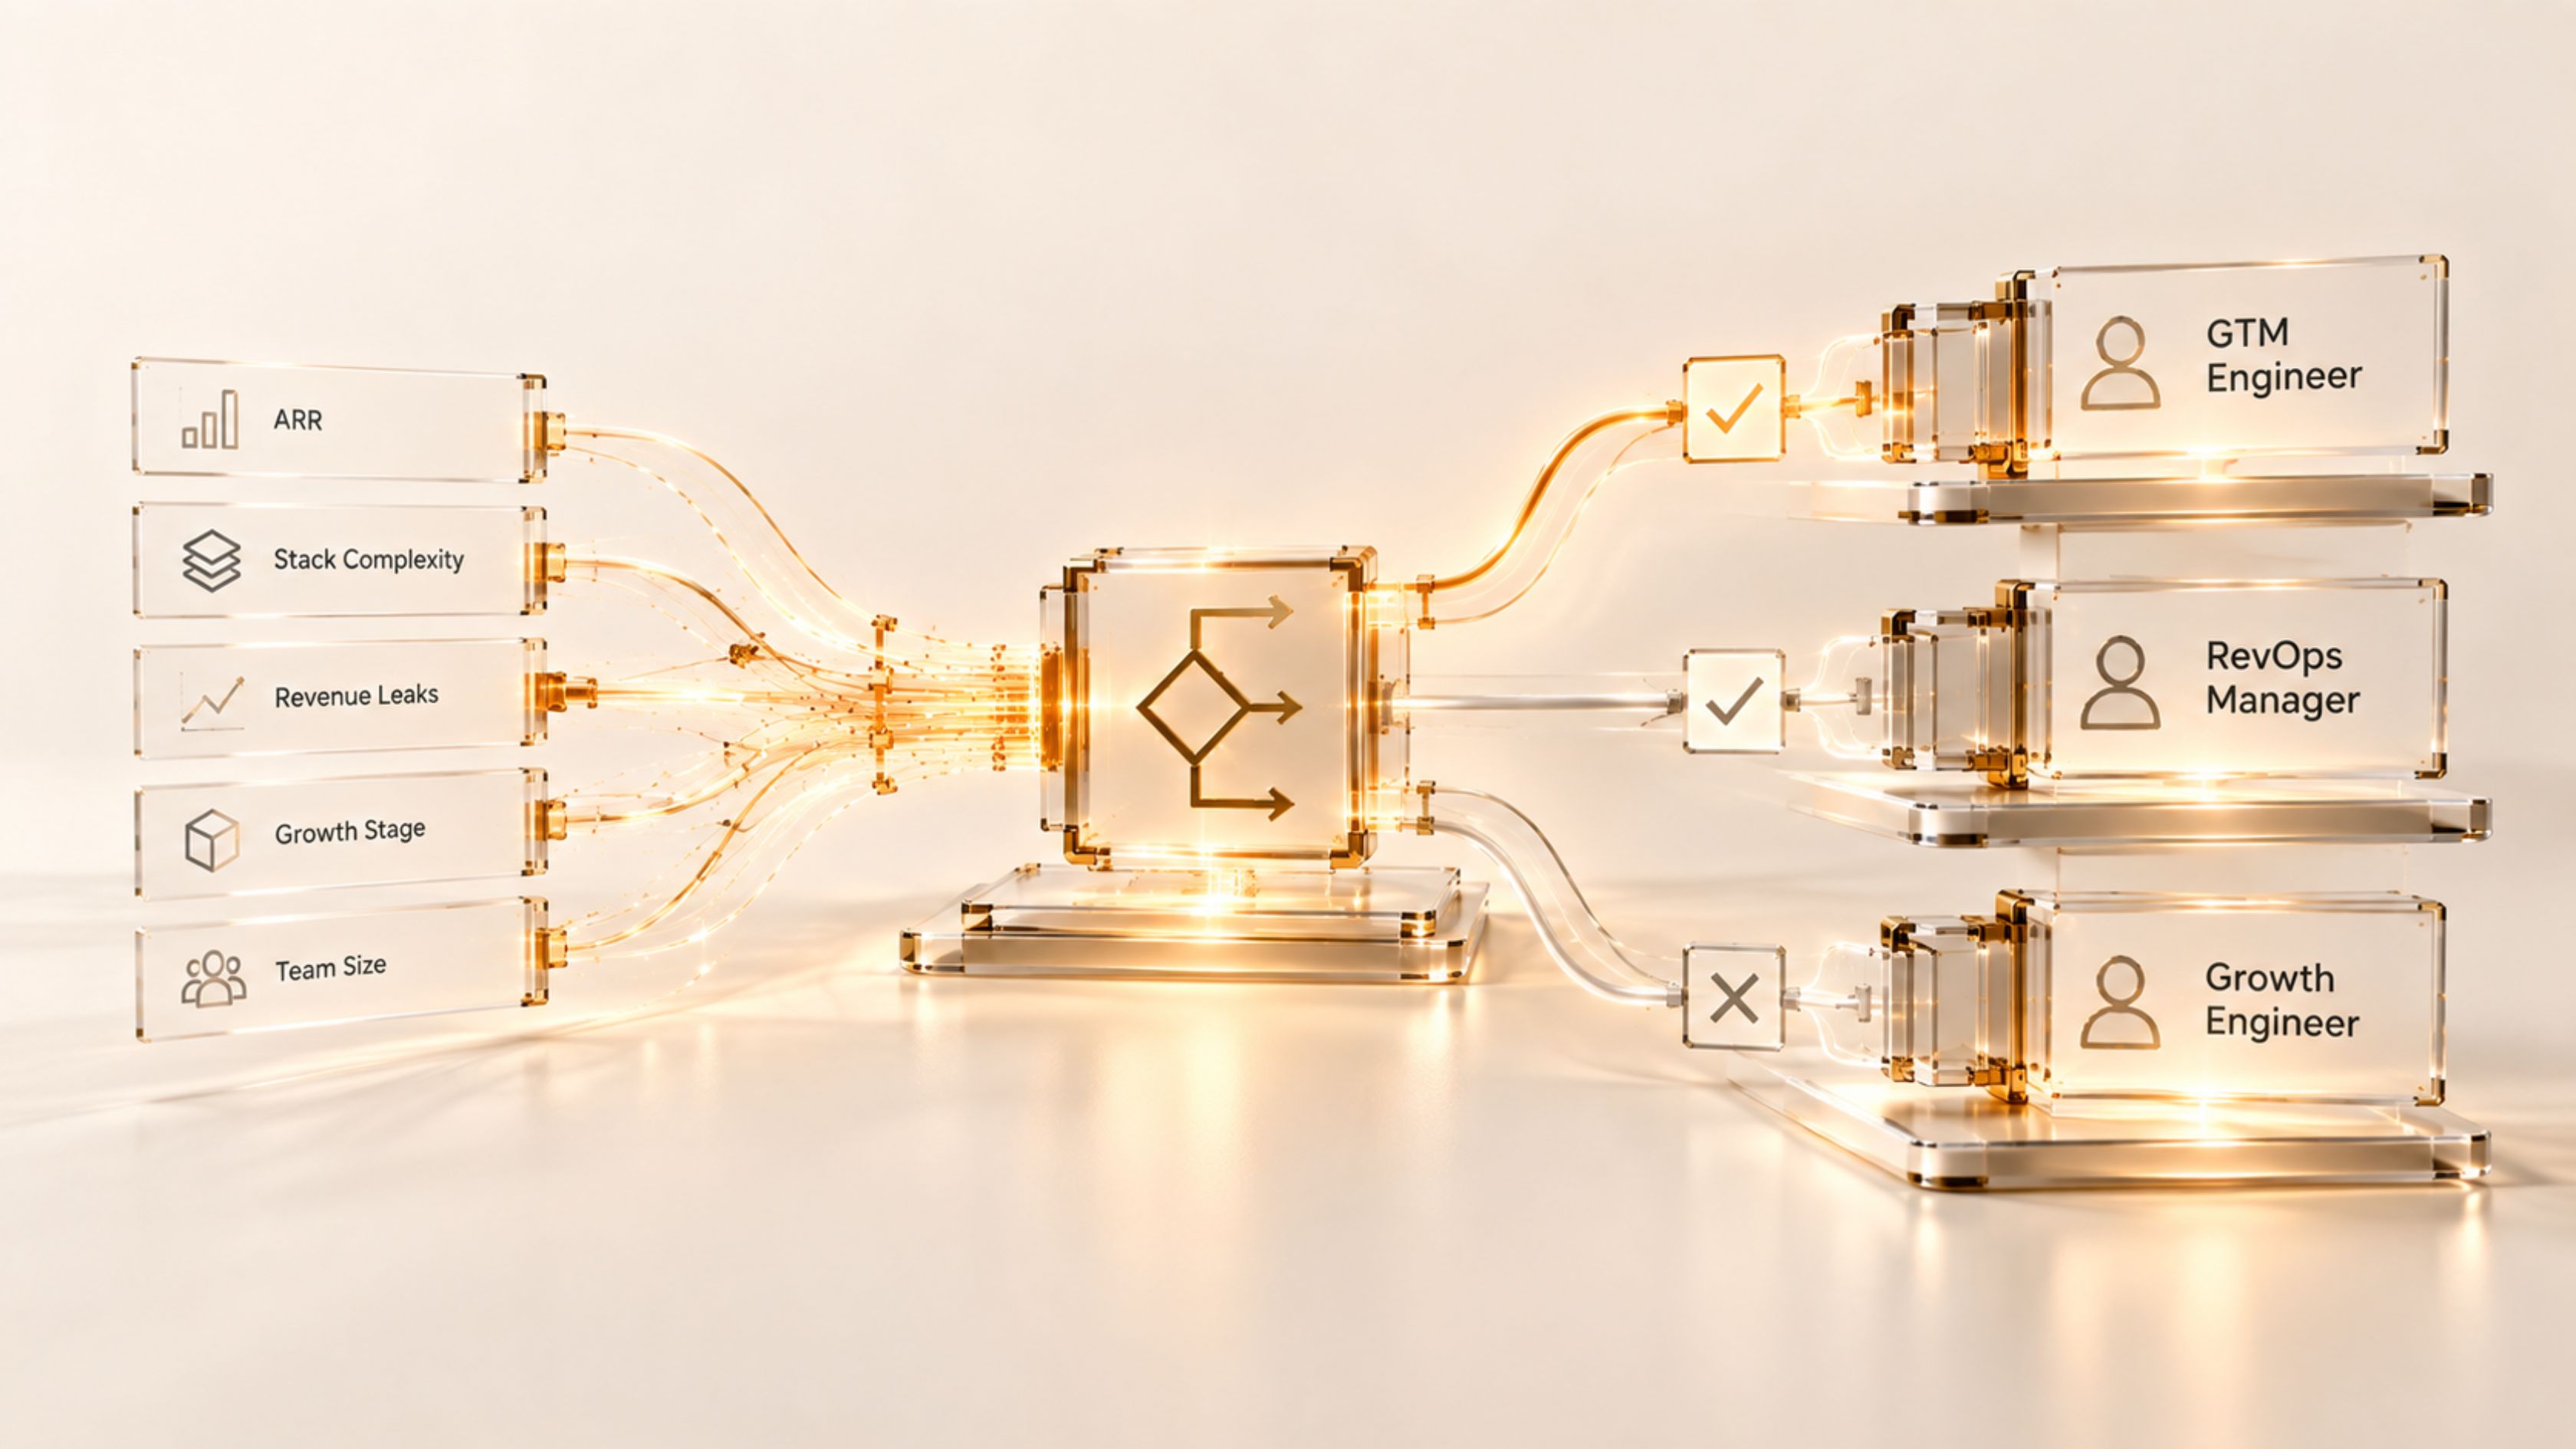
No es un problema de personas ni de herramientas: es un problema de arquitectura de sistemas disfrazado de descripción de puesto. GTM Engineer, responsable de RevOps y Growth Engineer no son cargos intercambiables para una misma función; corresponden a capas distintas de la infraestructura de ingresos, modos de fallo diferentes y curvas de coste de propiedad distintas. Contratar al perfil equivocado no solo desperdicia una partida de personal: deja intacta la avería real mientras una persona competente pierde un año sorteándola. Antes de redactar la vacante, necesitas un árbol de decisión, no una preferencia por un cargo.
Dónde falla
Contratar a un responsable de RevOps para resolver un problema de ingeniería
Los responsables de RevOps destacan en el diseño de procesos, el gobierno de campos y la lógica de informes dentro de las herramientas que ya tienes: Salesforce, HubSpot, Outreach y editores nativos de flujos de trabajo. Lo que la mayoría de sus descripciones de puesto no contempla es escribir y mantener integraciones API a medida, construir disparadores basados en eventos entre sistemas que no se comunican de forma nativa o depurar el contenido de un webhook defectuoso a las once de la noche. Cuando el fallo real es un evento lead.routed ausente entre la herramienta de formularios y el CRM, el responsable de RevOps crea una solución provisional dentro del CRM: un informe, una cola manual o una alerta de Slack que alguien debe pulsar, porque ese es su conjunto de herramientas. El síntoma mejora ligeramente. La causa raíz, un sistema de respuesta rápida a leads que no se ha construido, sigue sin resolverse.
Contratar a un GTM Engineer antes de tener una infraestructura que justifique ingeniería
El fallo inverso es igual de habitual. Una empresa en fase semilla con 400 registros en el CRM y dos comerciales contrata a un GTM Engineer esperando que construya lógica de orquestación a medida entre sistemas que apenas contienen datos. No hay volumen de señales para construir un Signal-Based Outbound Engine, ni una cadencia de traspasos lo bastante compleja para justificar un orquestador, ni datos históricos de oportunidades con los que entrenar un modelo de previsión. El ingeniero dedica los dos primeros trimestres a limpiar datos y administrar el CRM, un trabajo que un generalista de RevOps habría hecho más rápido, por menos dinero y sin el coste de oportunidad de un salario de ingeniería desaprovechado.
Contratar a un Growth Engineer y asignarle trabajo crítico para los ingresos
Los Growth Engineers suelen orientarse al producto y la experimentación: están preparados para lanzar páginas de destino, ejecutar ciclos de activación e instrumentar eventos de analítica de producto. Cuando una empresa les asigna la lógica de traspaso comercial o la detección de señales de abandono, el resultado suele ser un script puntual en lugar de un sistema monitorizado: nadie se hace responsable de la tarea de sincronización cuando falla, no hay alertas cuando el disparador deja de ejecutarse silenciosamente ni alternativa cuando la API de origen cambia su esquema. Los Growth Engineers suelen ser buenos constructores, pero la infraestructura crítica para los ingresos necesita un responsable que rinda cuentas a la dirección de Ventas y de Éxito del Cliente, no a una lista de tareas de crecimiento.
Tratar la decisión como permanente en lugar de escalonada
El antipatrón más caro no es elegir el cargo equivocado: es suponer que la primera contratación será la última. Una empresa que necesita un responsable de RevOps con $3M ARR para establecer el gobierno de campos y un GTM Engineer con $8M ARR para construir la lógica de Handoff Orchestrator no comete dos errores distintos si los contrata en ese orden. Solo se equivoca si contrata al segundo perfil antes de que existan los cimientos del primero (campos limpios, etapas definidas y un sistema de registro de referencia documentado) sobre los que el ingeniero pueda construir.
Arquitectura de referencia: asigna el perfil a la capa que falla
Aún no se decide ninguna contratación. Se trata de una auditoría de solo lectura de la infraestructura actual: higiene de campos del CRM, inventario de integraciones, latencia de asignación y traspaso, e historial de precisión de las previsiones. El resultado es un registro de fugas: una lista priorizada de dónde se pierden ingresos por procesos defectuosos, fallos de ingeniería o falta de personal. Sin esta capa, cada contratación posterior es una conjetura.
Se encarga de la taxonomía de campos, las definiciones de etapas, la automatización nativa del CRM (reglas de validación, reglas de asignación y editores de flujos incluidos) y la lógica de informes. Trabaja dentro de la configuración admitida por el proveedor: Salesforce Flow, HubSpot Workflows y ajustes nativos de Gong u Outreach. Contrato de datos: consume datos suficientemente limpios de las fuentes existentes; no construye nuevas integraciones entre sistemas.
Se encarga de la orquestación entre sistemas: integraciones a nivel de API, disparadores basados en eventos y tareas de sincronización entre CRM, automatización de marketing, telemetría de producto y plataformas de Éxito del Cliente. Construye y monitoriza los sistemas que la configuración de RevOps por sí sola no puede producir: asignación de leads que se activa mediante un webhook en segundos, o lógica de traspaso que comprueba varios campos de dos objetos antes de crear una tarea. Contrato de datos: publica eventos definidos y se suscribe a ellos (lead.created, opp.stage_changed, usage.threshold_crossed), con un esquema documentado en el que otros sistemas pueden confiar.
Se encarga de la instrumentación y experimentación próximas al producto: seguimiento de eventos de activación, estímulos dentro del producto y lógica de conversión de autoservicio. Coincide con GTM Engineering en el traspaso de señales de uso del producto a los sistemas de Ventas y Éxito del Cliente, pero no debería ser responsable de las tareas de sincronización críticas para los ingresos, sino únicamente de las señales que las alimentan.
Secuencia de construcción: cómo contratar, no solo elegir un cargo
Construir o contratar: ventajas y desventajas
| Enfoque | Mejor encaje | Coste de propiedad | Riesgo de fallo |
|---|---|---|---|
| CRM nativo / contratación de RevOps | Gobierno de campos, definiciones de etapas e informes dentro de una herramienta principal | Banda salarial más baja; escala mal más allá de 3-4 sistemas integrados | Soluciones provisionales en lugar de correcciones cuando el fallo cruza sistemas |
| iPaaS / herramienta de flujos (Zapier, Make, Workato) gestionada por un generalista o Growth Engineer | Automatizaciones sencillas y de bajo volumen entre dos o tres herramientas | Inicio barato; el precio por tarea y las cadenas frágiles se vuelven caros e inestables a escala | Fallos silenciosos: un zap se desactiva y nadie lo advierte hasta que los datos de oportunidades están desactualizados |
| Código a medida / ingeniería GTM integrada en el cliente | Orquestación basada en eventos en toda la infraestructura de ingresos, probada con tus propios datos | Mayor coste inicial; menor mantenimiento a largo plazo una vez entregado al 85% y estable | Exige responsabilidad real y disciplina de monitorización en producción: el riesgo pasa de «¿se rompió?» a «¿alguien se dio cuenta?» |
Las empresas subestiman la fila intermedia. Una cadena de flujos que parecía un atajo en serie A se convierte en el sistema sin documentar que un nuevo GTM Engineer debe desentrañar en serie B, normalmente sin que quede nadie que recuerde por qué existe un determinado zap. Evaluar el coste real exige incluir ese desmantelamiento futuro, no solo la cuota mensual de la herramienta.
Operarlo en producción
Sea cual sea el perfil responsable de un sistema, la monitorización en producción debe existir independientemente de su atención. Un sistema de asignación de leads necesita una alerta cuando el volumen cae a cero o el tiempo de respuesta supera un umbral, no un panel que alguien consulta cuando se acuerda. Si la única monitorización es «el responsable de RevOps lo ve en el informe semanal», el sistema no tiene monitorización: tiene una esperanza.
Define qué ocurre cuando cae la tarea de sincronización que alimenta un sistema. ¿El lead queda sin asignar o pasa a una cola con un responsable predeterminado? ¿Una previsión obsoleta se marca como tal o se presenta al consejo como actual? El estado seguro ante fallos debe diseñarse durante la construcción. Añadirlo después de la primera interrupción silenciosa es una forma de erosionar la confianza en el sistema.
El consejo no necesita saber a qué API llama la lógica de traspaso. Necesita una frase: «los leads se asignan automáticamente al comercial adecuado en cinco minutos y recibimos una alerta si eso deja de ocurrir». Si la persona responsable no puede resumirlo así, probablemente el sistema sea más frágil, o más improvisado, de lo que sugiere el organigrama. Esta también es la prueba de que el perfil adecuado se hace responsable: un responsable de RevOps suele explicar con claridad un proceso de informes; explicar claramente una cadena de disparadores entre sistemas indica que la capa de ingeniería está realmente construida, no improvisada.
Dónde encaja en el sistema
Este árbol de decisión precede a todos los sistemas de la página de sistemas de VANDFORT. Speed-to-Lead y Handoff Orchestrator pertenecen específicamente a la capa 2: son problemas de orquestación entre sistemas, no de configuración nativa del CRM. Por eso las empresas que intentan construirlos solo con un generalista de RevOps suelen estancarse en la fase de soluciones provisionales descrita antes. Forecast Assistant y Pipeline Hygiene Sentinel dependen de que la capa 1 sea sólida primero: las definiciones limpias de etapas y la disciplina de campos son el contrato de datos que consumen esos sistemas.
El modelo de VANDFORT existe para cubrir la brecha de la que trata realmente este artículo: el periodo entre diagnosticar que falta un sistema de capa 2 y disponer de la plantilla, el presupuesto o la convicción para contratar a un GTM Engineer a tiempo completo. Alejandro Lugo y Mauricio Varela construyeron VANDFORT como ingenieros integrados en el cliente: construyen el sistema dentro de tu infraestructura, con tus propios datos, y debe funcionar al 85% antes de entregarse. Conoce a ambos en vandfort.com/about. Si intentas determinar si te falta una contratación, una construcción o todavía ninguna de las dos, el Revenue Leak Report es la versión de solo lectura y tres semanas del diagnóstico del primer paso: realizada para ti, antes de comprometer una partida de personal.