Votre première semaine ressemble à ceci. Le CRO demande pourquoi les prévisions ont changé quatre fois au trimestre précédent. La direction commerciale veut que le routage des leads soit corrigé avant vendredi. Le marketing affirme que la moitié de ses MQL disparaît après le transfert. Vous ouvrez l'instance Salesforce ou HubSpot et découvrez 340 champs personnalisés sur l'objet Opportunity, trois propriétés Lifecycle Stage aux valeurs qui se recoupent, 60 workflows et flux actifs (dont une douzaine appartient à des personnes parties depuis) et un compte Zapier payé avec la carte personnelle de quelqu'un, qui écrit dans l'objet Account toutes les cinq minutes.
Cette instance est un cas composite, pas une entreprise précise, mais le schéma est familier à quiconque a été la deuxième recrue RevOps. La première recrue, souvent un généraliste des opérations commerciales ou un fondateur doté de droits d'administration, a construit ce que le trimestre exigeait. Personne n'avait tort. Personne ne pilotait non plus l'ensemble, et le CRM reflète maintenant deux ans de décisions locales sans conception globale.
Ces chiffres expliquent pourquoi ce poste existe. The State of CRM Data Management in 2025 de Validity, une enquête auprès de 602 utilisateurs et administrateurs de CRM aux États-Unis, au Royaume-Uni et en Australie publiée en juillet 2025, révèle que 76 % déclarent que moins de la moitié de leurs données CRM sont exactes et complètes, et que 37 % disent que leur organisation a perdu des revenus directement à cause de la mauvaise qualité des données. La même étude, selon le compte rendu de MediaPost, révèle que 46 % n'ont aucun salarié à temps plein dédié à la qualité des données. Sur le terrain, l'étude State of Sales de Salesforce, menée en 2024 auprès de 5 500 professionnels de la vente dans 27 pays, révèle que seuls 35 % font entièrement confiance à l'exactitude des données de leur organisation. Et une étude Gartner de 2020 situe le coût moyen de la mauvaise qualité des données à au moins $12.9 millions par an et par organisation.
C'est un problème de systèmes, pas de personnes ni d'outils. Le CRM ne s'est pas dégradé parce que les commerciaux sont négligents ou que la plateforme est mauvaise. Il s'est dégradé parce que rien dans l'architecture ne décide qui peut créer un champ, qui peut y écrire, quelle automatisation contrôle chaque transition ou ce qui se passe lorsque deux sources se contredisent. La gouvernance est cette couche manquante, et c'est un artefact d'ingénierie : un ensemble de contrats imposés par la configuration, pas un document de politique dans un dossier partagé.
Où le système se casse
Les instances héritées échouent selon quelques schémas récurrents. Chacun désigne des objets que vous pouvez retrouver dans votre propre organisation cette semaine.
Une prolifération de champs sans responsable ni définition
Les champs personnalisés s'accumulent parce qu'en créer un coûte peu et qu'en supprimer un semble risqué. Résultat : trois champs pour la même idée (Customer_Tier__c, Segment__c et une liste de sélection appelée Size), avec des taux de remplissage et des acteurs d'écriture différents. Les rapports des différentes équipes utilisent des champs différents ; le conseil d'administration et les commerciaux voient donc des chiffres différents pour un même segment. Le signal révélateur est un champ modifié au cours du dernier mois, sans description, absent de toute mise en page et utilisé dans aucun rapport que quelqu'un puisse nommer.
Des définitions d'étapes et de statuts qui ont dérivé
Les valeurs d'Opportunity StageName ont été définies une fois, puis étendues : une étape "Verbal" ajoutée pour une équipe, une étape "Pending Legal" pour une autre, des probabilités modifiées à la main. Lead Status et Lifecycle Stage n'ont pas le même sens dans l'automatisation marketing et dans le CRM. Sans critères de sortie écrits pour chaque étape, les taux de conversion entre étapes ne sont pas comparables d'un trimestre à l'autre. Voilà pourquoi les prévisions bougent chaque fois que quelqu'un relit le pipeline.
Des automatisations aux déclencheurs qui se chevauchent
Les règles de workflow, les vestiges de Process Builder, les flux déclenchés par les enregistrements, les workflows HubSpot et les outils externes s'exécutent tous lors de la même mise à jour d'un enregistrement. Deux définissent OwnerId, un définit Lead Status et une tâche d'enrichissement tierce écrase Industry après sa correction par un commercial. Personne ne peut prévoir l'état final d'un enregistrement après sauvegarde ni identifier l'automatisation responsable d'une mauvaise valeur sans lire les journaux de débogage.
Des accès en écriture non maîtrisés aux frontières
Des utilisateurs d'intégration dotés de profils d'administrateur système, des clés API dans des comptes personnels d'automatisation, des imports CSV par toute personne ayant "Modify All" et des applications de synchronisation natives configurées pour "toujours écraser". Ces voies contournent les règles de validation que vous ajoutez ; corriger l'interface ne résout donc rien. Chacune a besoin d'un responsable, d'un périmètre et d'une liste des champs qu'elle peut modifier.
Des doublons et des enregistrements orphelins qui cassent les agrégations
Les comptes Account en double répartissent le pipeline et l'activité entre plusieurs enregistrements ; les contacts Contact sans Account disparaissent des rapports par compte ; les opportunités Opportunity sans Contact Roles rendent l'attribution conjecturale. Ce sont des problèmes d'identité déguisés en problèmes de gouvernance, et ils aggravent tous les dysfonctionnements précédents.
Architecture de référence
Traitez la gouvernance comme un système en couches, avec un contrat entre chaque couche, comme vous traiteriez n'importe quel pipeline de données. Les outils cités illustrent une catégorie ; ce ne sont pas des recommandations.
Composants : toutes les voies par lesquelles les données entrent dans le CRM : l'interface, les formulaires web, la synchronisation de l'automatisation marketing, les outils d'enrichissement comme Clay ou ZoomInfo, les intégrations de facturation et de produit, les imports CSV et les utilisateurs d'intégration.
Contrat avec la couche suivante : chaque voie d'entrée est enregistrée avec un responsable, un utilisateur d'intégration dédié doté de permissions de moindre privilège et une liste explicite des champs qu'elle peut créer ou mettre à jour. Les voies non enregistrées sont fermées, pas tolérées.
Composants : règles de correspondance et de doublons, règles de validation des champs obligatoires par étape, restriction des listes de sélection et normalisation des domaines, pays et intitulés de poste, grâce à la gestion native des doublons ou à un outil comme DemandTools, Plauti ou Insycle.
Contrat avec la couche suivante : chaque Account porte un domaine normalisé et chaque Contact correspond à un seul Account. Les enregistrements qui échouent à la validation sont retenus pour examen avec un motif, pas sauvegardés avec des valeurs vides.
Composants : un inventaire unique des automatisations, un flux déclenché par les enregistrements par objet et moment d'exécution (avant et après sauvegarde) comme point d'entrée, la logique de routage et une carte des responsabilités des champs qui désigne l'unique acteur autorisé à écrire dans chaque champ gouverné.
Contrat avec la couche suivante : pour tout champ gouverné, exactement une automatisation ou un rôle humain peut y écrire, et chaque écriture automatisée enregistre une source et un horodatage.
Composants : le modèle d'objets, un dictionnaire de données pour chaque champ gouverné (définition, responsable, valeurs autorisées, acteur d'écriture et rapports en aval), les définitions d'étapes avec critères de sortie, les profils et les ensembles de permissions.
Contrat avec la couche suivante : les rapports et tableaux de bord ne peuvent utiliser que des champs présents dans le dictionnaire. Un champ absent du dictionnaire est destiné à être retiré, pas discrètement réutilisé.
Composants : tableaux de bord, prévisions, routage, séquences, scores de santé du customer success et tout agent d'IA qui lit ou écrit des données CRM.
Contrat : l'activation ne lit que des champs gouvernés et n'écrit que par la couche d'orchestration. Un agent reçoit le même utilisateur d'intégration de moindre privilège que n'importe quel autre outil.
Choisir ce qu'il faut gouverner en premier est une question de priorité, et la réponse n'est pas "ce qui fait le plus de bruit". Classez chaque constat selon les pertes financières qu'il provoque, rapportées à l'effort nécessaire. Voici un point de départ suggéré, pas une référence de marché :
for each finding (field, flow, stage, entry path):
  exposure   = revenue that passes through the affected records per quarter
  error_rate = share of those records that are wrong or late (sample 50)
  leak       = exposure * error_rate * probability the error changes an outcome
  effort     = days to fix + days to test

  priority   = leak / effort

sequence:  days 0-30  -> stop new damage on the top 3 by priority
           days 31-60 -> repair and define (dictionary, stages, dedupe)
           days 61-90 -> enforce and hand over (permissions, monitors)
Exemple illustratif avec des chiffres ronds inventés : si $2M de pipeline par trimestre passent par des leads entrants, que 20 % sont mal routés et qu'un mauvais routage divise par deux la probabilité de conversion pour, disons, un quart de ces leads, ce problème provoque bien plus de pertes qu'une liste Industry désordonnée qui alimente un seul tableau de bord. Corrigez d'abord le routage, même si la liste génère davantage de plaintes.
Séquence de construction
Six étapes sur quatre-vingt-dix jours. Chacune se termine par un test à exécuter avant de passer à la suite.
Jours 1 à 10 : geler et inventorier, en lecture seule
Suspendez pendant trente jours la création de champs et d'automatisations, avec une procédure d'exception qui passe par vous. Exportez ensuite les métadonnées : chaque champ personnalisé avec son taux de remplissage et sa date de dernière modification, chaque automatisation active avec son objet déclencheur et les champs dans lesquels elle écrit, chaque utilisateur d'intégration avec ses permissions. Le playbook de diagnostic avant construction explique comment procéder sans toucher à un enregistrement. Test : pour les objets Opportunity et Lead, vous pouvez produire une liste de tous les acteurs d'écriture de chaque champ utilisé pour les prévisions et le routage.
Jours 10 à 20 : chiffrer les fuites et les classer
Échantillonnez cinquante enregistrements récents par flux à forte valeur (routage entrant, progression des étapes et transfert des ventes gagnées au customer success) et mesurez combien sont erronés, en retard ou orphelins. Appliquez la logique de priorité ci-dessus. Test : chacun des trois principaux constats possède une exposition en dollars, un taux d'erreur issu de votre échantillon et une estimation d'effort que le CRO a vue.
Jours 20 à 30 : bloquer les nouveaux dégâts sur les trois priorités
Fermez les voies d'entrée et corrigez les automatisations qui créent les erreurs les plus prioritaires : transférez les intégrations incontrôlées vers des utilisateurs d'intégration dédiés, limitez les écrasements des champs importants et consolidez les flux qui se disputent OwnerId ou l'étape. Test : rééchantillonnez les mêmes flux après une semaine et montrez que le taux d'erreur baisse sur les nouveaux enregistrements.
Jours 31 à 60 : définir, puis réparer
Rédigez le dictionnaire de données des champs gouvernés et les définitions d'étapes avec critères de sortie, validés avec les directions commerciales et customer success. Dédupliquez ensuite les Account et Contact, fusionnez les champs redondants et complétez les valeurs des champs conservés. Test : chaque tableau de bord utilisé lors de la réunion hebdomadaire de prévisions ne lit que des champs du dictionnaire, et le nombre de comptes Account en double par domaine normalisé est proche de zéro.
Jours 61 à 80 : faire respecter les règles dans la plateforme
Transformez les définitions en configuration : règles de validation à l'entrée d'une étape, listes de sélection restreintes, sécurité au niveau du champ pour que seul le rôle ou l'automatisation responsable puisse modifier les champs gouvernés, et procédure de demande de changement (un ticket, une sandbox, une revue) pour les nouveaux champs et flux. Test : tentez une écriture incorrecte par chaque voie d'entrée, interface, import, API et synchronisation, et confirmez que chacune la rejette ou l'oriente vers un examen.
Jours 80 à 90 : démontrer sur des cas passés et transmettre
Rejouez une vingtaine d'enregistrements réels récents, dont des leads, changements d'étape, fusions et transferts de ventes gagnées, dans la configuration gouvernée et comparez le résultat à ce qu'un opérateur estime avoir dû se produire. Nous imposons le même seuil à chaque système : 85 pour cent de concordance sur les propres cas passés du client, sinon il n'est pas livré. Transmettez ensuite le dictionnaire, la carte des responsabilités et les moniteurs à la direction des revenus. Test : une autre personne que vous peut répondre à "qui écrit dans ce champ et pourquoi" à partir de la seule documentation.
Construire ou acheter : les compromis
La gouvernance repose surtout sur des décisions, mais les appliquer et les surveiller nécessite des mécanismes. Il existe trois façons courantes de les fournir.
| Approche | Cas adapté | Coût de maintenance | Risque d'échec |
|---|---|---|---|
| Contrôles natifs du CRM (règles de validation, de doublons et de correspondance, listes de sélection restreintes, sécurité au niveau du champ, historique des champs et permissions des propriétés HubSpot) | Un seul CRM, un ou deux administrateurs, la plupart des écritures via l'interface et peu d'intégrations | Le plus faible. Utilise les licences et compétences d'administration déjà en place | Les règles se multiplient et entrent en conflit ; la correspondance native des doublons est limitée pour les noms de comptes désordonnés ; rien ne signale qu'une règle est contournée via l'API |
| Outils de qualité des données et de workflow (par exemple Plauti, Insycle ou DemandTools pour la déduplication et la normalisation ; n8n ou Workato pour les voies d'écriture gouvernées) | Plusieurs voies d'entrée, un grand volume d'enregistrements, des doublons récurrents et une équipe RevOps capable de gérer les tâches planifiées | Modéré. Des licences et un responsable des tâches, règles de fusion et files d'exceptions | Devient un autre acteur d'écriture avec ses propres règles d'écrasement s'il n'est pas enregistré dans la carte des responsabilités ; les nettoyages planifiés masquent la voie en amont qui continue à créer le problème |
| Moniteurs ou agents sur mesure (comparaison des métadonnées, audits des voies d'écriture et contrôles d'anomalies fondés sur les API de métadonnées et d'événements, avec alertes dans Slack ou Teams) | Organisations grandes ou évoluant vite, nombreuses intégrations, agents d'IA écrivant dans le CRM et ingénieur GTM dans l'équipe | Le plus élevé. Nécessite un responsable ingénierie, des tests et une astreinte | Le plus précis et le plus rapide pour détecter les dérives, mais une petite équipe peut finir par maintenir du code de surveillance au lieu de corriger la conception sous-jacente |
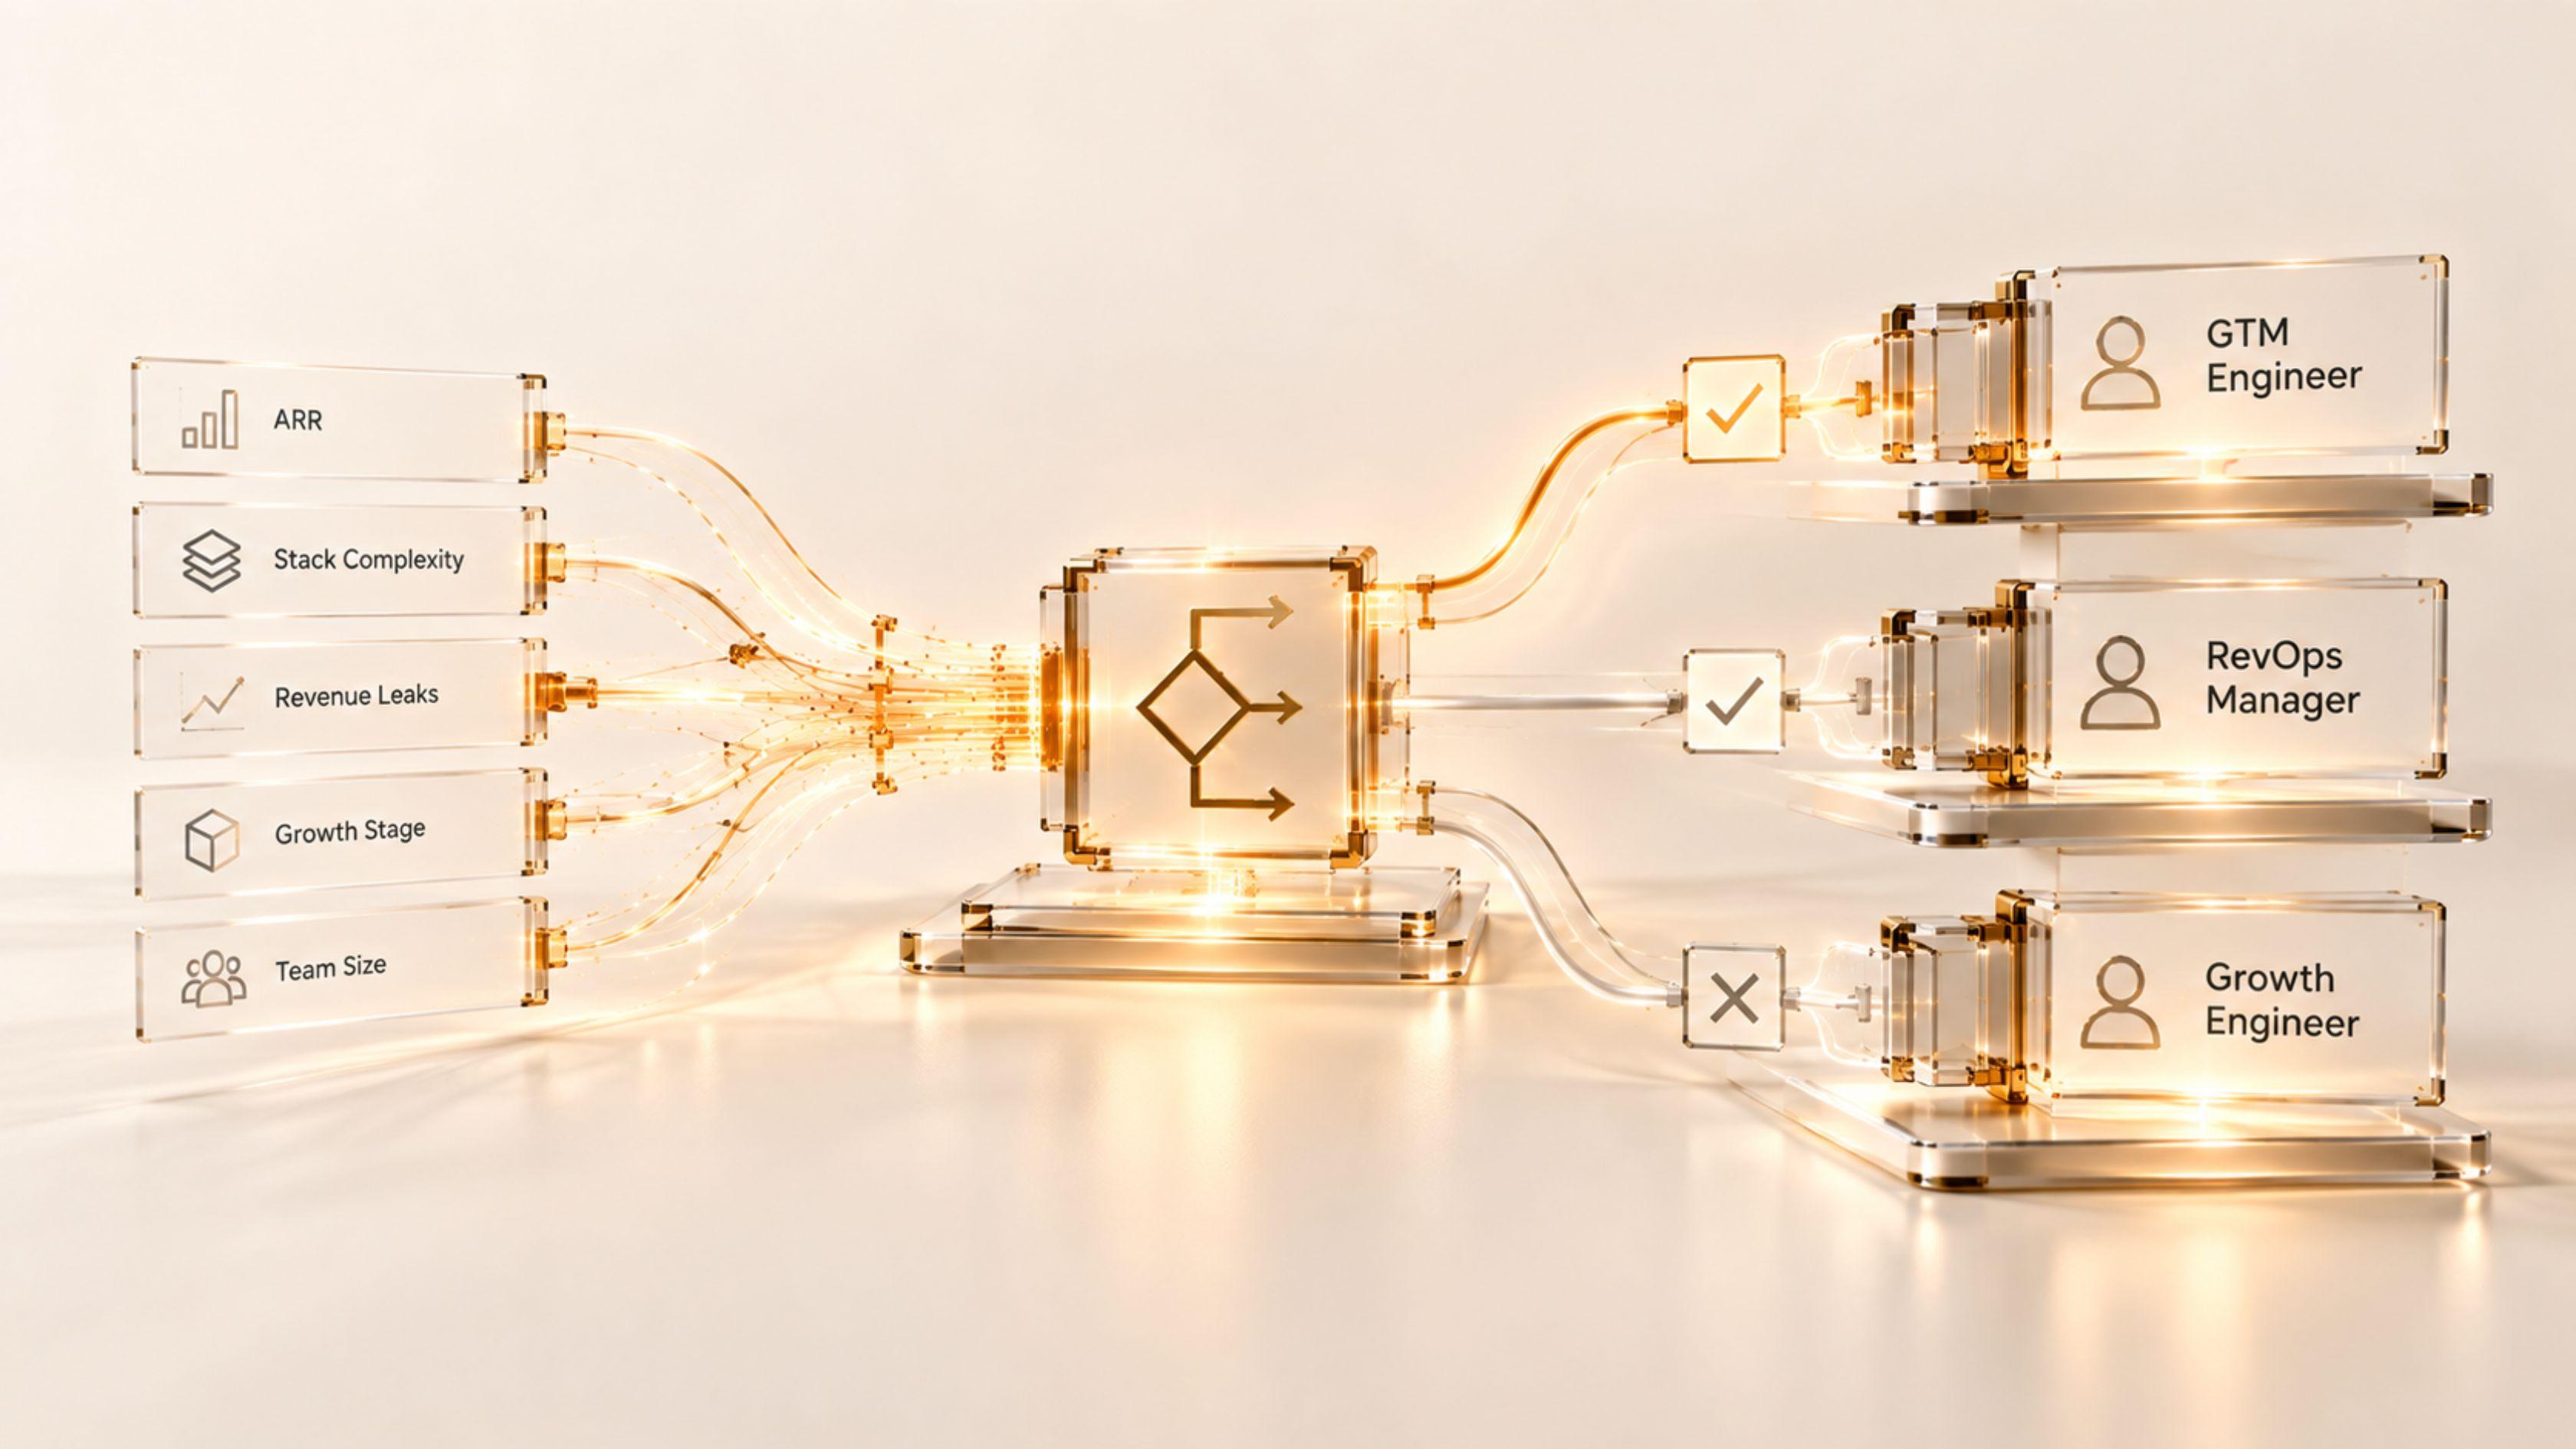
La plupart des deuxièmes recrues devraient commencer avec les contrôles natifs et n'ajouter un outil que si le taux d'erreur échantillonné reste élevé après la fermeture des voies d'entrée. Désigner le responsable de l'option sur mesure relève de la conception organisationnelle, qu'examine l'arbre de décision entre ingénieur GTM et responsable RevOps.
Exploitation en production
Surveillez une liste courte chaque semaine : nouveaux champs personnalisés et automatisations créés hors de la procédure de changement, écritures dans les champs gouvernés par d'autres acteurs que leur responsable, comptes Account en double créés par semaine et par voie d'entrée, taux de remplissage des champs obligatoires par étape et taux d'erreur échantillonné sur vos trois principaux flux. Une hausse de l'un de ces indicateurs pointe généralement vers une nouvelle intégration ou un administrateur bien intentionné.
Lorsqu'une règle de validation ou un contrôle de responsabilité bloque une écriture, l'enregistrement rejoint une file d'exceptions avec un responsable et un délai de réponse, pas un échec silencieux qu'un commercial découvre en fin de trimestre. Conservez une dérogation d'urgence pour la direction, journalisée et examinée chaque semaine, afin que l'urgence ne devienne pas discrètement le nouveau processus.
Présentez la gouvernance en argent et en confiance, pas en champs nettoyés. Montrez les dollars qui traversent chaque flux gouverné, le taux d'erreur avant et après et si le chiffre de prévision varie moins entre les réunions hebdomadaires. L'étude Validity de 2025, selon le compte rendu de MediaPost, révèle que les salariés passent environ 13 heures par semaine à chercher des données ; le temps récupéré est un deuxième chiffre que la direction comprend.
La place de la gouvernance dans le système
La gouvernance est le préalable à tout système qui lit le CRM. Le Pipeline Hygiene Sentinel est de la gouvernance exécutée en continu : il vérifie les critères de sortie des étapes, les dates de clôture obsolètes et les champs manquants par rapport aux définitions rédigées du jour 31 au jour 60. Le Forecast Assistant ne peut être plus stable que ces définitions. Speed-to-Lead et le Handoff Orchestrator dépendent d'un responsable unique pour OwnerId, Lead Status et Lifecycle Stage, précisément ce qu'impose la carte des responsabilités des champs. La carte complète figure sur la page des systèmes.
L'ordre importe davantage que la liste des tâches. C'est l'intérêt du forward-deployed engineering dans une reconstruction de gouvernance : travailler dans l'instance héritée, chiffrer les fuites sur vos propres enregistrements, corriger un flux à la fois et prouver chaque changement sur des cas réels avant sa mise en production.
Sources : Validity, The State of CRM Data Management in 2025 (602 utilisateurs et administrateurs de CRM, États-Unis, Royaume-Uni et Australie, juillet 2025) ; compte rendu de MediaPost sur l'étude Validity (11 juillet 2025). Salesforce, étude State of Sales (5 500 professionnels de la vente, 27 pays, 2024). Gartner, recherche sur la qualité des données (2020).