Vous l'avez sans doute vécu, peut-être sous un autre nom. Un prestataire intègre un ingénieur à votre équipe RevOps. Il obtient un accès en lecture à Salesforce, HubSpot et votre entrepôt de données. Il commence à cartographier les objets : Lead, Opportunity, Account, la tâche de synchronisation entre votre plateforme d'automatisation marketing et le CRM, les déclencheurs qui s'activent à chaque changement d'étape. Au bout de trois mois, il cartographie encore. Au bout de six, il a un accès en écriture à deux systèmes et une liste croissante d'éléments pour la « phase deux ». Au bout de douze, vous payez un ingénieur à temps plein rattaché à l'organigramme d'un prestataire, et personne ne peut vous dire ce qui a été livré, ce que cela coûte à faire tourner ni ce qui se passe si cette personne précise s'en va. La mission n'a jamais eu de limite. Elle avait seulement une date de début.
Ce n'est ni un problème de personnes ni un problème d'outils. C'est ce qui arrive quand on emprunte le modèle du forward-deployed engineering sans emprunter la contrainte qui le fait fonctionner : un diagnostic à périmètre fixe avant que quiconque écrive une ligne de logique d'orchestration.
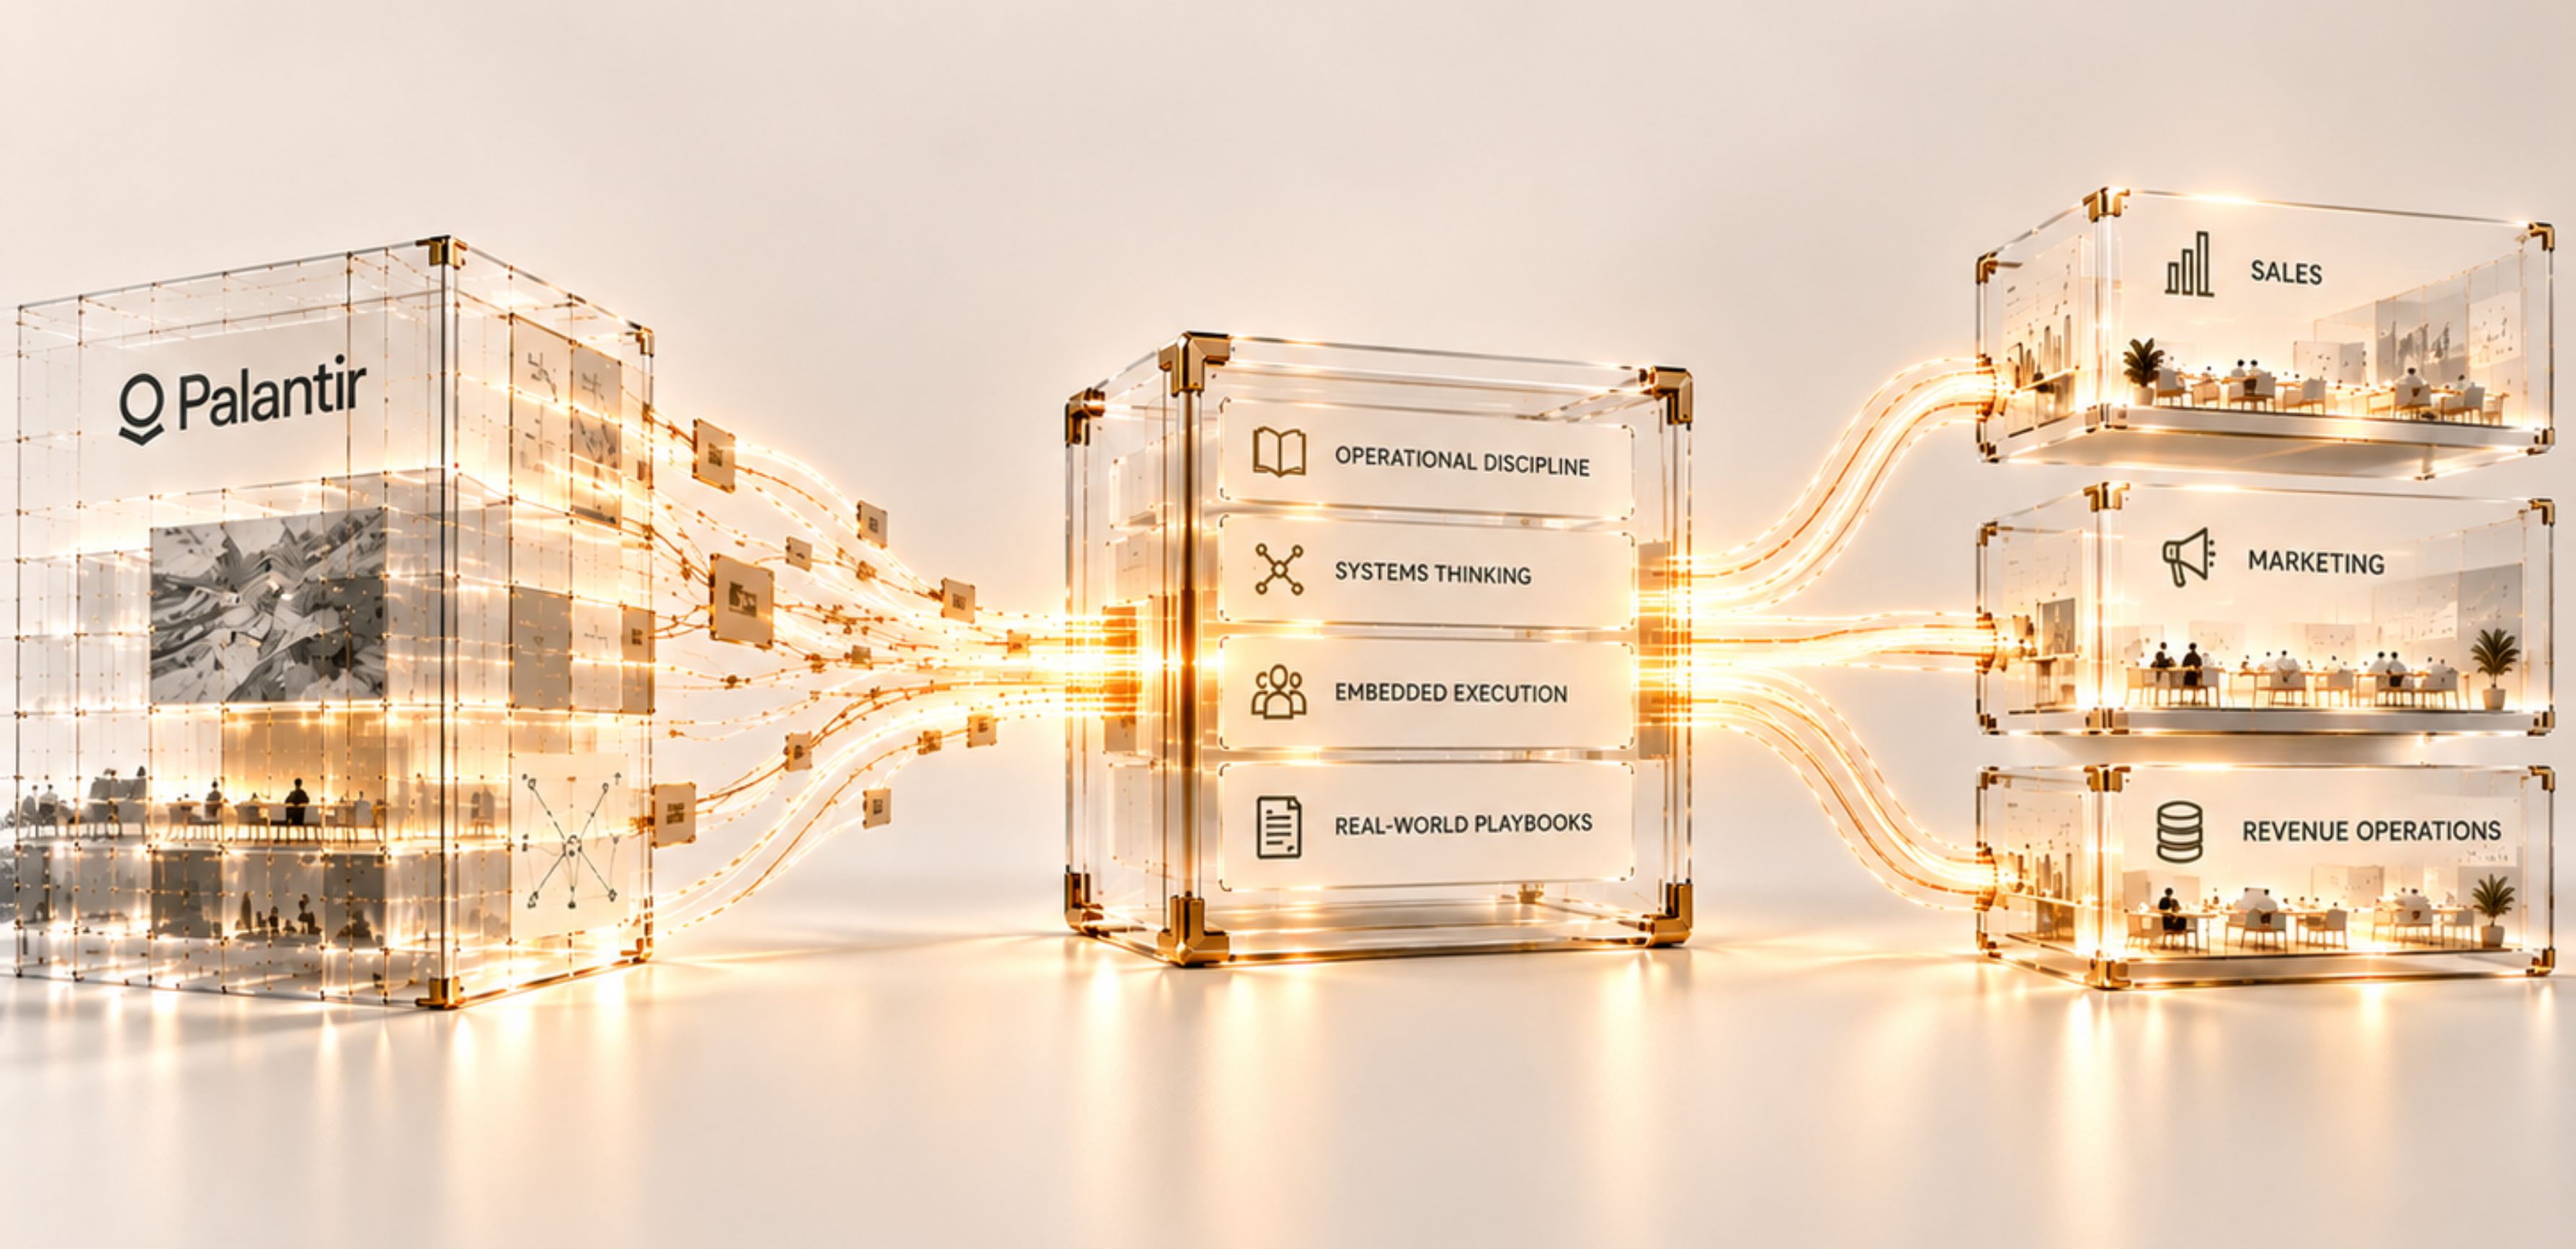
Palantir a créé le modèle FDE pour résoudre un problème précis : un logiciel qui doit fonctionner dans un environnement opérationnel existant, désordonné et à fort enjeu (un champ de bataille, une chaîne logistique, un système hospitalier) ne peut pas être spécifié à distance. Quelqu'un doit s'installer dans cet environnement, voir les données réelles et construire à partir de ce qui existe vraiment, pas de ce qu'affirme le cahier des charges. Les équipes revenus ont le même problème. Votre logique d'assignation des leads, vos déclencheurs de transfert, votre consolidation des prévisions : rien de tout cela ne peut être bien conçu à partir d'une réunion de lancement et d'une présentation de cadrage. Quelqu'un doit examiner votre instance Salesforce réelle, vos tâches de synchronisation réelles et votre désordre réel au niveau des champs avant de pouvoir construire quoi que ce soit qui résiste à la production.
Cette partie du playbook se transpose sans difficulté. Ce qui ne se transpose pas automatiquement, c'est la discipline qui empêche un ingénieur intégré de devenir une ligne budgétaire permanente dont personne ne répond. Le modèle de Palantir fonctionne parce que l'ingénieur forward-deployed travaille sur une mission définie avec des critères de réussite définis, et non parce que l'intégration aurait quelque chose de magique. Supprimez le périmètre fixe et « forward-deployed » n'est plus qu'un joli mot pour désigner du renfort de personnel mieux emballé.
Là où ça casse
Les modes de défaillance ci-dessous sont précis, pas des reproches génériques du type « le conseil tourne mal ». Chacun laisse une trace concrète dans votre stack : un champ qui n'a jamais reçu de définition, un déclencheur dont personne n'est responsable, une tâche de synchronisation qui a commencé à perdre des enregistrements sans prévenir.
L'ingénieur intégré devient une ligne d'effectif sans condition de sortie
C'est la défaillance la plus courante, et elle est structurelle, pas personnelle. Sans diagnostic écrit (objets précis, points de défaillance précis, systèmes précis à construire), la mission d'un ingénieur intégré s'étend naturellement jusqu'à remplir le calendrier. Il est sollicité pour des demandes ponctuelles : « peux-tu aussi corriger le champ de scoring des leads ? », « peux-tu aussi regarder pourquoi la consolidation des prévisions ne tombe pas juste ? ». Chacune de ces demandes est légitime. Aucune n'était dans le périmètre. Dix-huit mois plus tard, vous avez payé une personne, pas un système, et le savoir de cette personne (quels champs comptent, quels déclencheurs portent tout, pourquoi la tâche de synchronisation s'exécute dans cet ordre) vit dans sa tête, pas dans un runbook.
La lecture pour toujours, l'écriture jamais
Le principe « d'abord l'accès en lecture » du modèle FDE est juste : vous ne devriez laisser personne écrire en production avant de comprendre ce qui se passe réellement dans les transitions d'Opportunity.StageName ou dans la logique de conversion de Contact en Lead. Mais certains prestataires s'arrêtent là. Ils restent indéfiniment en mode observation, à produire des tableaux de bord et des recommandations, parce que passer à l'accès en écriture les obligerait à s'engager sur un résultat vérifiable. Rester en lecture seule pour toujours n'est pas de la prudence. C'est une façon d'éviter le moment où un système fonctionne ou ne fonctionne pas.
Un logiciel qui ne reste pas, parce qu'il n'a jamais été conçu pour survivre au départ de l'ingénieur
L'objectif affiché de Palantir est que les ingénieurs forward-deployed finissent par laisser un logiciel que le client peut exploiter seul. Dans les missions GTM, c'est là que la plupart des prestataires échouent discrètement. La logique d'assignation est construite dans un compte Zapier personnel, dans un déclencheur Apex sur mesure sans commentaires, ou dans un workflow d'un outil pour lequel le client n'a pas de licence entreprise. Aucun contrat de données ne documente les champs que lit la logique, les événements qu'elle écoute ni ce qu'elle réécrit. À la fin de la mission, le « système » n'est en réalité que le jugement non documenté d'une personne, encodé tant bien que mal dans un outil. Il casse la première fois qu'un champ est renommé.
Aucun diagnostic à périmètre fixe avant la construction
C'est la cause racine des trois premiers. Le conseil sans limite apparaît quand la découverte et la construction se confondent dans une même phase ouverte. Il n'existe aucun moment où quelqu'un dit : voici le registre des fuites, voici les systèmes précis qui les referment, voici ce que « terminé » signifie pour chacun. Sans ce moment, le périmètre n'a aucune raison de cesser de grandir, car chaque nouveau constat pendant la mission ressemble à une justification pour davantage de travail plutôt qu'à un candidat pour un futur système au périmètre distinct.
La propriété du système de référence n'est jamais transférée
Même quand le logiciel est construit et qu'il reste, la propriété, elle, ne suit souvent pas. Le prestataire reste le seul à pouvoir modifier sans risque le déclencheur ou la tâche de synchronisation, si bien que « le logiciel est resté » est techniquement vrai et opérationnellement faux. Vous dépendez toujours du prestataire pour chaque changement, ce qui revient au même verrouillage qu'une ligne d'effectif, simplement sous un autre habit.
Architecture de référence
Voici, dans l'ordre, les couches qu'une mission forward-deployed doit réellement toucher dans un stack de revenus B2B SaaS. Le principe de conception qui l'empêche de devenir du conseil sans limite est que chaque couche a un contrat de données explicite avec celle du dessus et celle du dessous, de sorte que n'importe quel ingénieur, même quelqu'un qui n'a jamais été dans la pièce, peut lire le contrat et savoir ce qu'une couche attend et produit.
Événements d'usage produit, formulaires remplis, données d'intention, transcriptions d'appels, tickets de support. Outils types : Segment, un pipeline d'analyse produit, Clearbit ou des flux d'enrichissement similaires, les données d'appels de Gong ou Chorus. Contrat avec la couche supérieure : chaque événement source porte un identifiant stable (domaine du compte, e-mail du contact ou identifiant d'entité attribué par l'entrepôt) et un horodatage. Aucun événement ne devrait pouvoir être consommé en aval sans eux.
Logique de dédoublonnage, résolution des entités entre systèmes, standardisation des champs. Outils types : une couche de reverse ETL, un entrepôt (Snowflake, BigQuery) qui fait le rapprochement, ou les règles de dédoublonnage natives du CRM pour les cas simples. Contrat : chaque système en aval reçoit une seule fiche canonique par compte et par contact, avec une règle de rapprochement documentée, et non cinq fiches « Account » qui se chevauchent avec des orthographes différentes pour la même entreprise.
Les vraies règles d'assignation, de scoring et de déclenchement : assignation speed-to-lead, conditions de transfert, seuils de signal pour la prospection. Outils types : une couche iPaaS (Workato, Tray), les éditeurs de flows natifs du CRM, ou du code sur mesure quand la logique est trop conditionnelle pour des outils en pointer-cliquer. Contrat : chaque règle se déclenche sur un événement nommé et versionné (lead.created, stage.changed, signal.detected) et écrit son résultat dans un champ précis doté d'une définition documentée, pas dans une note en texte libre.
Salesforce ou HubSpot comme modèle d'objets de référence pour l'état des Account, Opportunity et Contact. Contrat : les champs écrits par la logique d'orchestration appartiennent à cette logique. Aucune modification manuelle sans changement correspondant dans la règle, et chaque écriture automatique est attribuable à une tâche ou à un déclencheur précis, visible dans l'historique du champ.
Là où le système agit vraiment : un SDR reçoit une alerte en quelques minutes, un commercial voit un signalement d'hygiène du pipeline, un CSM reçoit un signal de désabonnement, un rapport pour le conseil se génère tout seul. Outils types : alertes Slack, tâches dans le CRM, un agent IA qui rédige des messages de prospection. Contrat : chaque activation renvoie à la règle et à l'enregistrement précis qui l'ont déclenchée, pour qu'un commercial ou un dirigeant puisse remonter de « pourquoi ai-je reçu ceci » à un événement précis, et non à une boîte noire.
// example data contract, Layer 3 -> Layer 4
event: lead.speed_to_lead_breach
fires_when: Lead.CreatedDate + 5min elapsed AND Lead.Status = 'New' AND Lead.OwnerAssignedAt IS NULL
writes_to: Lead.SLA_Breach_Flag__c (boolean), Lead.SLA_Breach_Timestamp__c
owned_by: orchestration layer, job "speed-to-lead-monitor"
downstream_consumer: Layer 5 Slack alert to Lead.Owner + RevOps channel
Séquence de construction
Construire ou acheter : les compromis
| Approche | Adéquation | Coût de possession | Risque de défaillance |
|---|---|---|---|
| Automatisation native du CRM (flows, workflows) | Adaptée à une logique simple sur un seul objet : un déclencheur, une mise à jour de champ | Faible au départ, augmente vite à mesure que la logique conditionnelle se multiplie entre objets | Pannes silencieuses quand des champs sont renommés ou que l'ordre des flows entre en conflit avec d'autres automatisations |
| iPaaS ou outil de workflows (Workato, Tray, type Zapier) | Adapté à l'orchestration multi-systèmes quand la logique est moyennement complexe sans exiger de scoring sur mesure ni de NLP | Modéré : licences plus une personne qui comprend tout le graphe des flux, pas une seule étape | Fragile face aux changements d'API des outils connectés ; les pannes passent souvent inaperçues sans supervision explicite |
| Code sur mesure ou ingénierie intégrée (forward-deployed) | La meilleure option quand la logique doit raisonner sur des données réelles, conditionnelles et désordonnées : scoring, réponses d'agents, jugement entre objets | Plus élevé au départ, mais plus faible à long terme si la propriété et la documentation sont réellement transférées | Risque maximal quand le périmètre n'a pas de limite ; minimal quand il est borné, testé sur des données réelles et remis avec un runbook |
La réponse honnête pour la plupart des équipes revenus est un mélange : l'automatisation native pour les cas triviaux, une couche iPaaS pour orchestrer deux ou trois systèmes, et l'ingénierie intégrée uniquement pour les systèmes où le jugement dans des conditions désordonnées compte vraiment : assignation speed-to-lead sous charge réelle, détection de signaux de désabonnement dans des données d'usage bruitées, logique de prévision qui doit concilier les estimations divergentes des commerciaux et des managers.
En production
Chaque règle d'orchestration a besoin d'un signal de défaillance visible, pas silencieux. Si la tâche speed-to-lead cesse de se déclencher parce qu'un champ a été renommé lors d'une mise à jour du CRM, la première personne à s'en apercevoir ne devrait pas être un commercial qui se demande trois semaines plus tard pourquoi le pipeline s'est tari. Mettez en place un contrôle quotidien du volume d'événements : si les événements lead.speed_to_lead_breach tombent à zéro ou s'envolent sans raison, c'est l'alerte, avant même que quiconque regarde les chiffres de conversion.
Concevez en prévoyant la panne de la tâche de synchronisation, pas seulement son bon fonctionnement. Si la couche de résolution d'identité ne parvient pas à rapprocher un nouveau lead d'un compte existant, le système doit l'envoyer dans une file de revue humaine, et non créer un doublon ou abandonner l'enregistrement en silence. Chaque couche automatisée a besoin d'un chemin explicite « je ne sais pas », un repli qui se dégrade proprement au lieu d'échouer de manière invisible.
Un CRO n'a pas besoin de voir la logique du déclencheur. Il lui faut une phrase : « les leads sont assignés en moins de 5 minutes selon le territoire et le score, et voici le taux hebdomadaire d'assignation dans les délais ». Chaque système a besoin d'un résumé pour la direction qui renvoie directement au contrat de données sous-jacent, pour que l'explication ne s'éloigne pas de ce que fait réellement le système. C'est la même discipline qu'exige un récit de preuves crédible : il doit renvoyer au mécanisme réel, pas à une histoire à son sujet.
Sa place dans le système
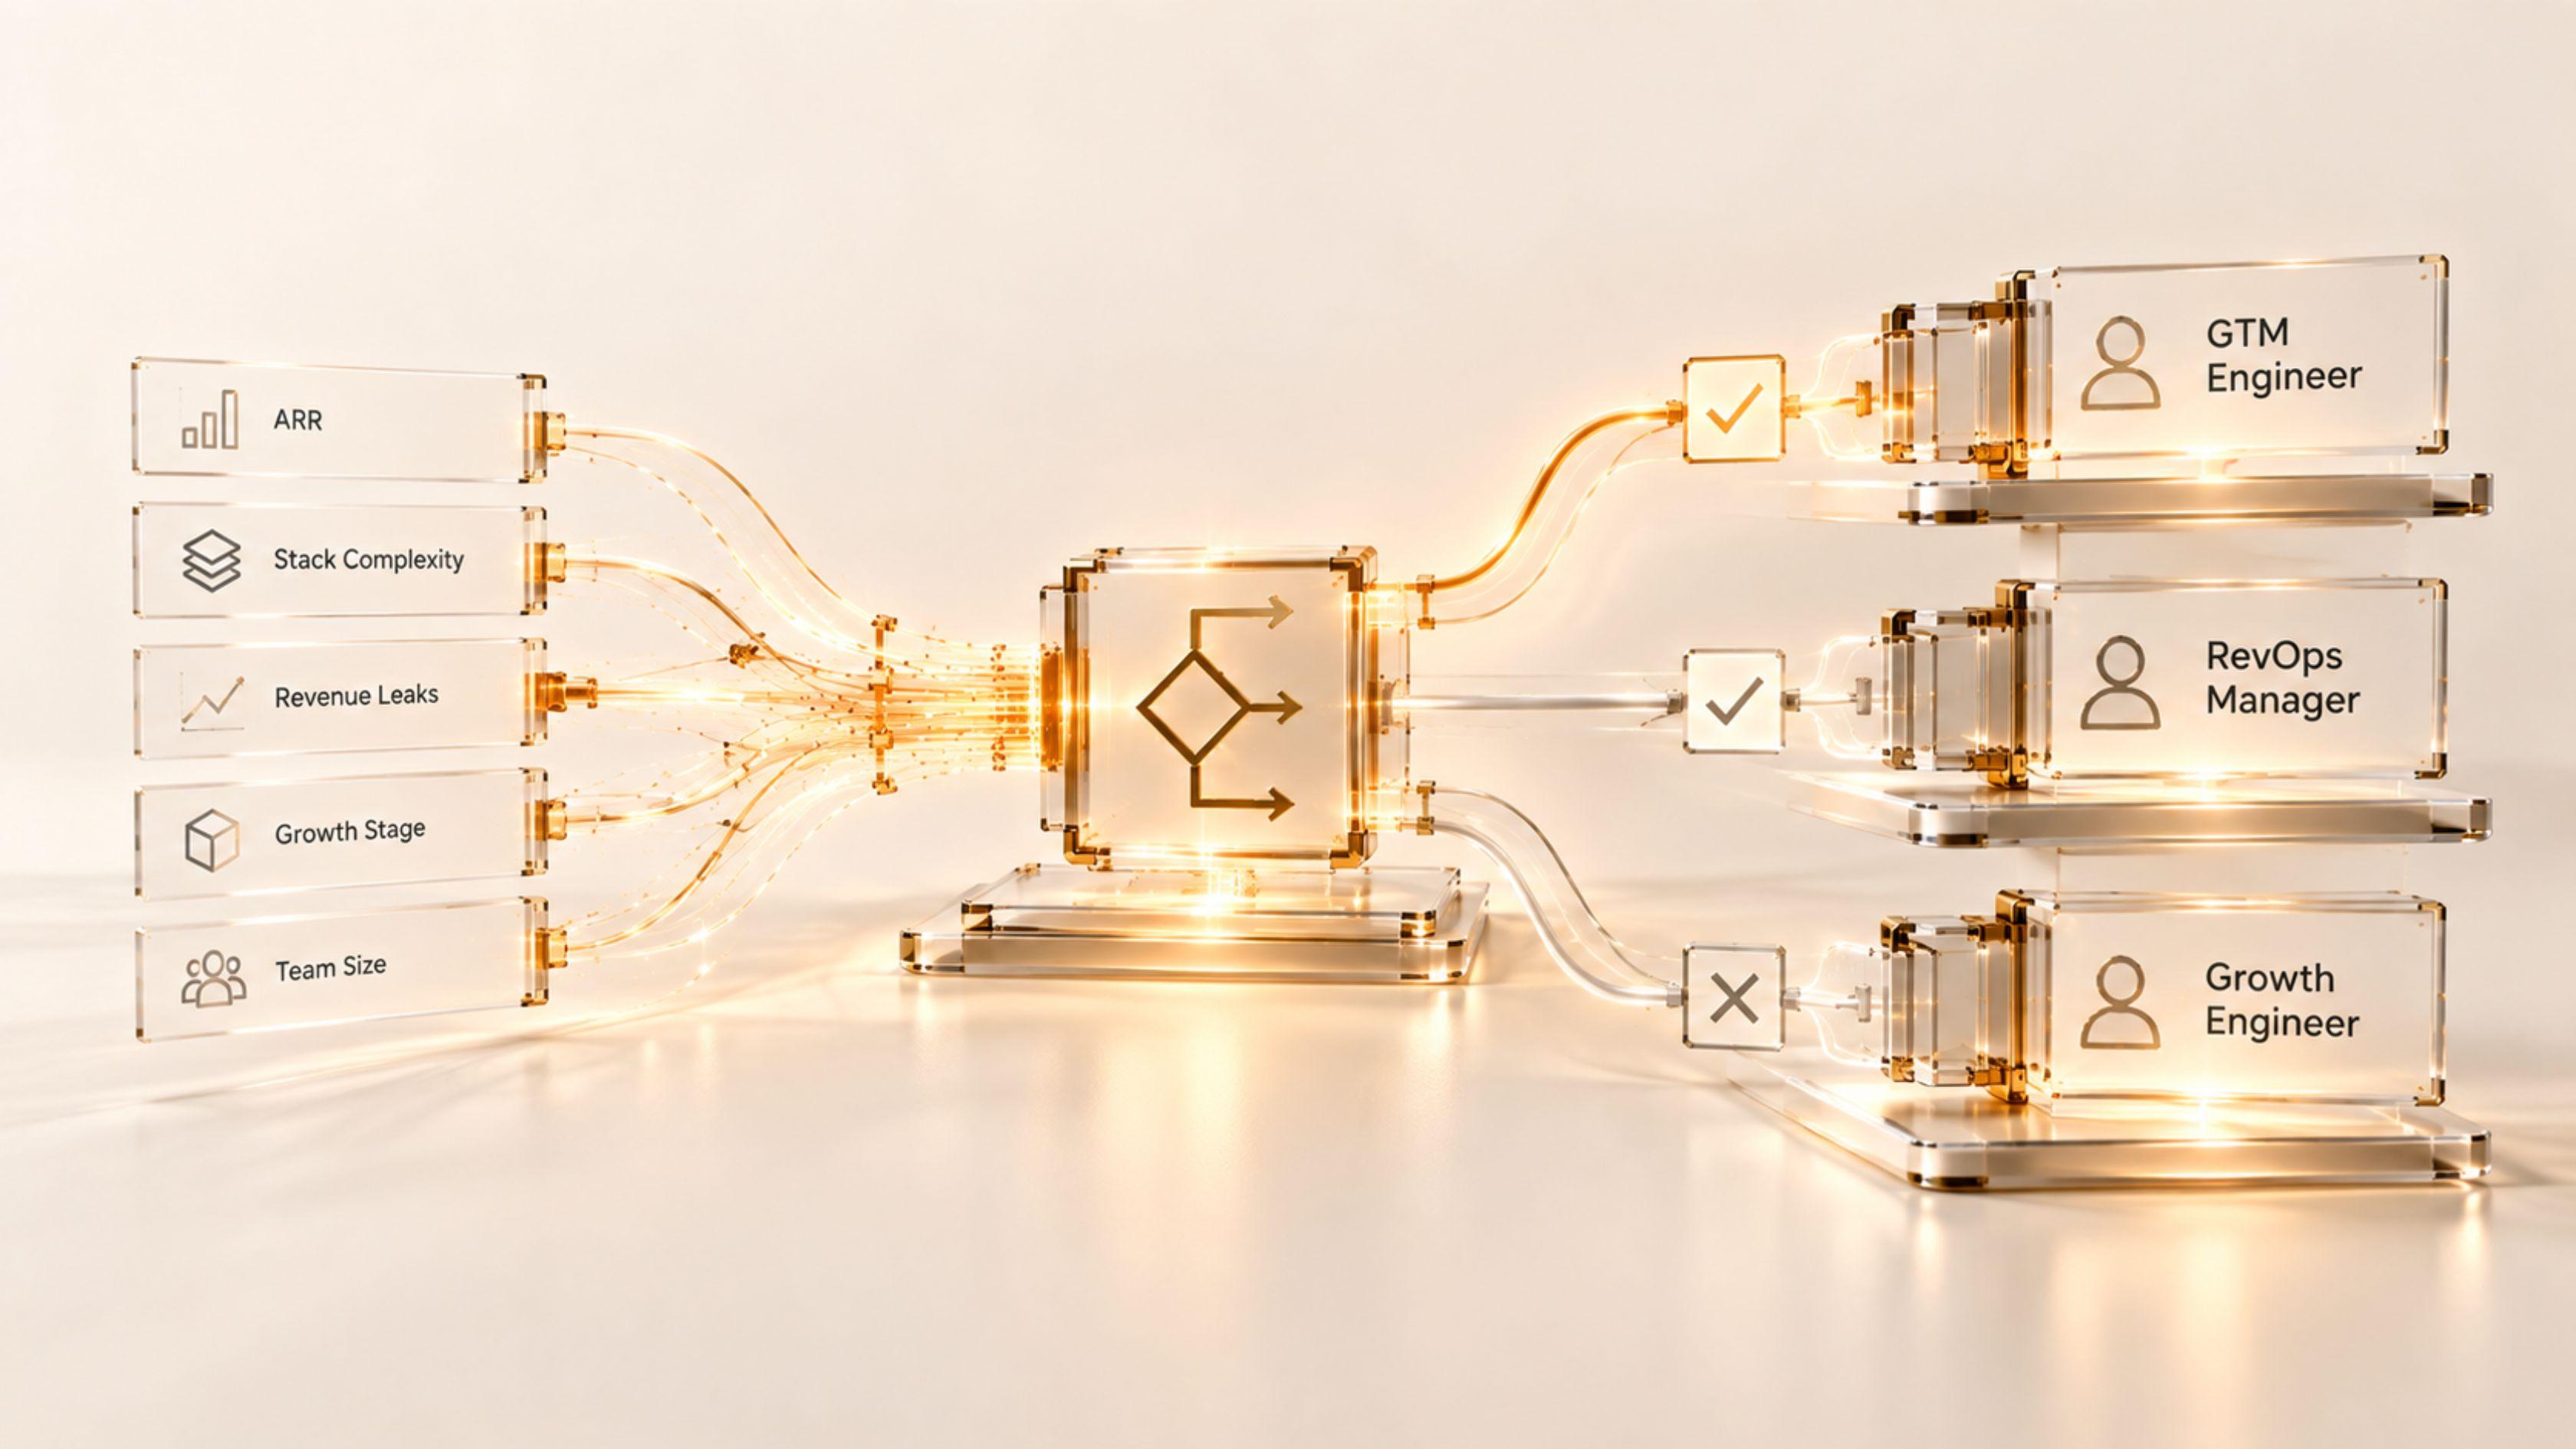
La discipline forward-deployed décrite ici (d'abord l'accès en lecture, un diagnostic à périmètre fixe, une construction sur des données réelles, une livraison à un seuil de fonctionnement, un transfert de propriété) est le modèle opérationnel derrière chacun des neuf systèmes de VANDFORT, et non une méthodologie distincte plaquée dessus. Elle se voit surtout dans les deux systèmes GTM Operations les plus exposés aux modes de défaillance ci-dessus : le système Speed-to-Lead, où une règle d'assignation non documentée et sans responsable est exactement le genre de logiciel qui « reste » seulement de nom, et le Handoff Orchestrator, qui existe précisément parce que la logique de transfert entre marketing, SDR et AE est la couche la plus souvent laissée à l'état de savoir tribal plutôt que de contrat de données documenté. Tous deux sont construits comme cet article estime que l'ingénierie intégrée devrait fonctionner : avec un périmètre borné, testés sur les propres données du client et livrés à un seuil défini (le niveau affiché par VANDFORT est de 85 %) plutôt que laissés ouverts. Les cofondateurs Alejandro Lugo et Mauricio Varela ont bâti le modèle de mission autour de cette contrainte précise, car l'alternative est le mode de défaillance qui ouvre cet article : un ingénieur intégré dont la mission n'a aucune limite.