Tu primera semana transcurre así. El CRO pregunta por qué la previsión cambió cuatro veces el trimestre pasado. La dirección de ventas quiere el enrutamiento de leads arreglado para el viernes. Marketing dice que la mitad de sus MQL desaparece después del traspaso. Abres la instancia de Salesforce o HubSpot y encuentras 340 campos personalizados en el objeto Opportunity, tres propiedades Lifecycle Stage con valores superpuestos, 60 workflows y flujos activos (una docena pertenece a personas que ya se fueron) y una cuenta de Zapier pagada con la tarjeta personal de alguien que escribe en el objeto Account cada cinco minutos.
Esa instancia es una composición de varios casos, no una empresa concreta, pero el patrón resulta familiar a cualquiera que haya sido la segunda contratación de RevOps. La primera persona, a menudo un generalista de operaciones de ventas o un fundador con permisos de administrador, construyó lo que exigía cada trimestre. Nadie estaba equivocado. Tampoco nadie estaba a cargo del conjunto, y el CRM refleja ahora dos años de decisiones locales sin un diseño global.
Las cifras explican por qué existe este puesto. The State of CRM Data Management in 2025, de Validity, una encuesta a 602 usuarios y administradores de CRM de Estados Unidos, Reino Unido y Australia publicada en julio de 2025, encontró que el 76% dice que menos de la mitad de sus datos de CRM es precisa y completa, y que el 37% dice que su organización ha perdido ingresos como consecuencia directa de la mala calidad de los datos. El mismo estudio, según informó MediaPost, encontró que el 46% no tiene un empleado dedicado a tiempo completo a supervisar la calidad de los datos. En primera línea, la investigación State of Sales de Salesforce, con 5.500 profesionales de ventas de 27 países encuestados en 2024, encontró que solo el 35% confía plenamente en la precisión de los datos de su organización. Y la investigación de Gartner de 2020 situó el coste medio de la mala calidad de los datos en al menos $12.9 millones al año por organización.
Es un problema de sistemas, no de personas ni de herramientas. El CRM no se deterioró porque los vendedores sean descuidados ni porque la plataforma sea incorrecta. Se deterioró porque nada en la arquitectura decide quién puede crear un campo, quién puede escribir en él, qué automatización controla cada transición o qué ocurre cuando dos fuentes discrepan. La gobernanza es esa capa que falta, y es un artefacto de ingeniería: un conjunto de contratos aplicados mediante configuración, no un documento de políticas en una carpeta compartida.
Dónde falla
Las instancias heredadas fallan de unas pocas formas recurrentes. Cada una señala objetos que puedes encontrar en tu propia organización esta semana.
Proliferación de campos sin responsable ni definición
Los campos personalizados se acumulan porque crear uno es barato y eliminarlo parece arriesgado. El resultado son tres campos para la misma idea (Customer_Tier__c, Segment__c y una lista de selección llamada Size), con distintas tasas de cumplimentación y distintos actores que escriben en ellos. Los informes de distintos equipos usan campos distintos, así que el consejo y el equipo de ventas ven cifras diferentes para el mismo segmento. La señal de alerta es un campo modificado durante el último mes que no tiene descripción, no aparece en ningún diseño de página y no se utiliza en ningún informe que alguien pueda identificar.
Definiciones de etapas y estados que han cambiado
Los valores de Opportunity StageName se configuraron una vez y después se ampliaron: una etapa "Verbal" para un equipo, otra "Pending Legal" para otro y probabilidades editadas a mano. Lead Status y Lifecycle Stage significan cosas distintas en la automatización de marketing y en el CRM. Sin criterios de salida escritos para cada etapa, las tasas de conversión entre etapas no se pueden comparar entre trimestres. Por eso la previsión cambia cada vez que alguien vuelve a leer el pipeline.
Automatizaciones con disparadores superpuestos
Las reglas de workflow, los restos de Process Builder, los flujos activados por registros, los workflows de HubSpot y las herramientas externas se ejecutan con la misma actualización de un registro. Dos establecen OwnerId, una establece Lead Status y un proceso externo de enriquecimiento sobrescribe Industry después de que un vendedor lo haya corregido. Nadie puede predecir el estado final de un registro al guardarlo ni decir qué automatización causó un valor incorrecto sin leer los registros de depuración.
Acceso de escritura sin control desde los extremos
Usuarios de integración con perfiles de administrador del sistema, claves de API en cuentas personales de automatización, importaciones CSV realizadas por cualquiera con "Modify All" y aplicaciones de sincronización nativa configuradas para "sobrescribir siempre". Estas vías eluden las reglas de validación que añades, así que arreglar la interfaz no soluciona nada. Cada una necesita un responsable, un alcance y una lista de los campos que puede modificar.
Duplicados y registros huérfanos que rompen las agregaciones
Las cuentas Account duplicadas reparten el pipeline y la actividad entre registros; los contactos Contact sin Account quedan fuera de los informes por cuenta; las oportunidades Opportunity sin Contact Roles convierten la atribución en conjeturas. Son problemas de identidad disfrazados de gobernanza y agravan todos los fallos anteriores.
Arquitectura de referencia
Trata la gobernanza como un sistema por capas con un contrato entre cada capa, igual que tratarías cualquier pipeline de datos. Las herramientas mencionadas son ejemplos de una categoría, no recomendaciones.
Componentes: todas las vías por las que entran datos al CRM: la interfaz, los formularios web, la sincronización de automatización de marketing, las herramientas de enriquecimiento como Clay o ZoomInfo, las integraciones de facturación y producto, las importaciones CSV y los usuarios de integración.
Contrato con la siguiente capa: cada vía de entrada se registra con un responsable, un usuario de integración dedicado con permisos de mínimo privilegio y una lista explícita de los campos que puede crear o actualizar. Las vías no registradas se cierran, no se toleran.
Componentes: reglas de coincidencia y duplicados, reglas de validación para los campos obligatorios por etapa, restricciones de listas de selección y normalización de dominios, países y cargos, mediante la gestión nativa de duplicados o una herramienta como DemandTools, Plauti o Insycle.
Contrato con la siguiente capa: cada Account tiene un dominio normalizado y cada Contact corresponde a una sola Account. Los registros que no superan la validación se retienen para revisión con un motivo, en lugar de guardarse con valores vacíos.
Componentes: un único inventario de automatizaciones, un flujo activado por registros por objeto y momento de ejecución (antes y después de guardar) como punto de entrada, lógica de enrutamiento y un mapa de responsabilidad de campos que identifica al único actor autorizado a escribir en cada campo gobernado.
Contrato con la siguiente capa: para cada campo gobernado, exactamente una automatización o un rol humano puede escribir en él, y cada escritura automatizada registra la fuente y la marca de tiempo.
Componentes: el modelo de objetos, un diccionario de datos para cada campo gobernado (definición, responsable, valores permitidos, actor autorizado a escribir e informes posteriores), definiciones de etapas con criterios de salida, perfiles y conjuntos de permisos.
Contrato con la siguiente capa: los informes y paneles solo pueden usar campos del diccionario. Un campo que no está en el diccionario se programa para su retirada, no se reutiliza discretamente.
Componentes: paneles, previsiones, enrutamiento, secuencias, puntuaciones de salud de customer success y cualquier agente de IA que lea o escriba datos del CRM.
Contrato: la activación solo lee campos gobernados y solo escribe a través de la capa de orquestación. Un agente recibe el mismo usuario de integración de mínimo privilegio que cualquier otra herramienta.
Decidir qué gobernar primero es una cuestión de prioridades, y la respuesta no es "lo que genere más ruido". Ordena cada hallazgo por el dinero que hace perder, ajustado por el esfuerzo. Un punto de partida sugerido, no un benchmark:
for each finding (field, flow, stage, entry path):
  exposure   = revenue that passes through the affected records per quarter
  error_rate = share of those records that are wrong or late (sample 50)
  leak       = exposure * error_rate * probability the error changes an outcome
  effort     = days to fix + days to test

  priority   = leak / effort

sequence:  days 0-30  -> stop new damage on the top 3 by priority
           days 31-60 -> repair and define (dictionary, stages, dedupe)
           days 61-90 -> enforce and hand over (permissions, monitors)
Ejemplo ilustrativo con cifras redondas inventadas: si $2M de pipeline por trimestre pasa por leads entrantes, el 20% se enruta mal y ese error reduce a la mitad la probabilidad de conversión en, digamos, una cuarta parte de esos leads, el problema de enrutamiento provoca muchas más pérdidas que una lista Industry desordenada que alimenta un solo panel. Arregla primero el enrutamiento, aunque la lista genere más quejas.
Secuencia de construcción
Seis pasos a lo largo de noventa días. Cada uno termina con una prueba que puedes ejecutar antes de seguir.
Días 1 a 10: congelar e inventariar, en modo de solo lectura
Pausa durante treinta días la creación de campos y automatizaciones, con una vía de excepción que pase por ti. Después exporta los metadatos: cada campo personalizado con su tasa de cumplimentación y fecha de última modificación, cada automatización activa con su objeto disparador y los campos que escribe, y cada usuario de integración con sus permisos. El playbook de diagnóstico antes de construir explica cómo hacerlo sin tocar un registro. Prueba: puedes producir, para los objetos Opportunity y Lead, una lista de todos los actores que escriben en cada campo usado para la previsión y el enrutamiento.
Días 10 a 20: cuantificar las fugas y priorizarlas
Toma una muestra de cincuenta registros recientes por flujo de alto valor (enrutamiento entrante, progresión de etapas y traspaso de ventas ganadas a customer success) y mide cuántos son incorrectos, tardíos o huérfanos. Aplica la lógica de prioridad anterior. Prueba: los tres hallazgos principales tienen una exposición en dólares, una tasa de error de tu muestra y una estimación de esfuerzo que el CRO ha visto.
Días 20 a 30: frenar nuevos daños en los tres problemas principales
Cierra las vías de entrada y arregla las automatizaciones que crean los errores de mayor prioridad: traslada las integraciones no controladas a usuarios de integración dedicados, restringe las sobrescrituras en los campos importantes y consolida los flujos que compiten por OwnerId o por la etapa. Prueba: vuelve a muestrear los mismos flujos después de una semana y muestra que la tasa de error baja en los registros nuevos.
Días 31 a 60: definir y después reparar
Escribe el diccionario de datos para los campos gobernados y las definiciones de etapas con criterios de salida, acordados con las direcciones de ventas y customer success. Después elimina duplicados de Account y Contact, fusiona los campos redundantes en uno y completa los valores de los campos que se conservan. Prueba: cada panel usado en la reunión semanal de previsión lee únicamente campos del diccionario y las cuentas Account duplicadas por dominio normalizado están cerca de cero.
Días 61 a 80: hacer cumplir las reglas en la plataforma
Convierte las definiciones en configuración: reglas de validación al entrar en una etapa, listas de selección restringidas, seguridad a nivel de campo para que solo el rol o la automatización responsable pueda editar campos gobernados, y un proceso de solicitud de cambios (un ticket, un sandbox y una revisión) para campos y flujos nuevos. Prueba: intenta una escritura incorrecta por cada vía de entrada, interfaz, importación, API y sincronización, y confirma que todas la rechazan o la envían a revisión.
Días 80 a 90: demostrarlo con casos anteriores y entregar el sistema
Reprocesa unos veinte registros reales recientes, incluidos leads, cambios de etapa, fusiones y traspasos de ventas ganadas, con la configuración gobernada y compara el resultado con lo que un operador dice que debería haber ocurrido. Exigimos el mismo umbral a todos los sistemas: un 85 por ciento de concordancia con los casos anteriores del cliente, o no se publica. Después entrega el diccionario, el mapa de responsabilidades y los monitores al equipo directivo de ingresos. Prueba: alguien que no seas tú puede responder "quién escribe en este campo y por qué" únicamente con la documentación.
Construir o comprar: compromisos
La gobernanza consiste sobre todo en decisiones, pero aplicarla y supervisarla requiere mecanismos. Hay tres formas habituales de proporcionarlos.
| Enfoque | Cuándo encaja | Coste de mantenimiento | Riesgo de fallo |
|---|---|---|---|
| Controles nativos del CRM (reglas de validación, duplicados y coincidencia, listas de selección restringidas, seguridad a nivel de campo, historial de campos y permisos de propiedades de HubSpot) | Un solo CRM, uno o dos administradores, la mayoría de las escrituras desde la interfaz y pocas integraciones | El más bajo. Usa las licencias y competencias de administración existentes | Las reglas se multiplican y entran en conflicto; la coincidencia nativa de duplicados es limitada con nombres de cuentas desordenados; nada avisa cuando una regla se elude mediante la API |
| Herramientas de calidad de datos y workflows (por ejemplo, Plauti, Insycle o DemandTools para deduplicación y normalización; n8n o Workato para vías de escritura gobernadas) | Varias vías de entrada, mucho volumen de registros, duplicados recurrentes y un equipo RevOps capaz de gestionar tareas programadas | Moderado. Licencias más un responsable de las tareas, reglas de fusión y colas de excepciones | Se convierte en otro actor que escribe con sus propias reglas de sobrescritura si no figura en el mapa de responsabilidades; las limpiezas programadas ocultan la vía de origen que sigue creando el problema |
| Monitores o agentes personalizados (comparación de metadatos, auditorías de vías de escritura y detección de anomalías sobre las API de metadatos y eventos, con alertas en Slack o Teams) | Organizaciones grandes o que cambian rápido, muchas integraciones, agentes de IA que escriben en el CRM y un ingeniero GTM en el equipo | El más alto. Necesita responsabilidad de ingeniería, pruebas y guardias | La mayor precisión y rapidez para detectar desviaciones, pero un equipo pequeño puede acabar manteniendo código de supervisión en vez de arreglar el diseño subyacente |
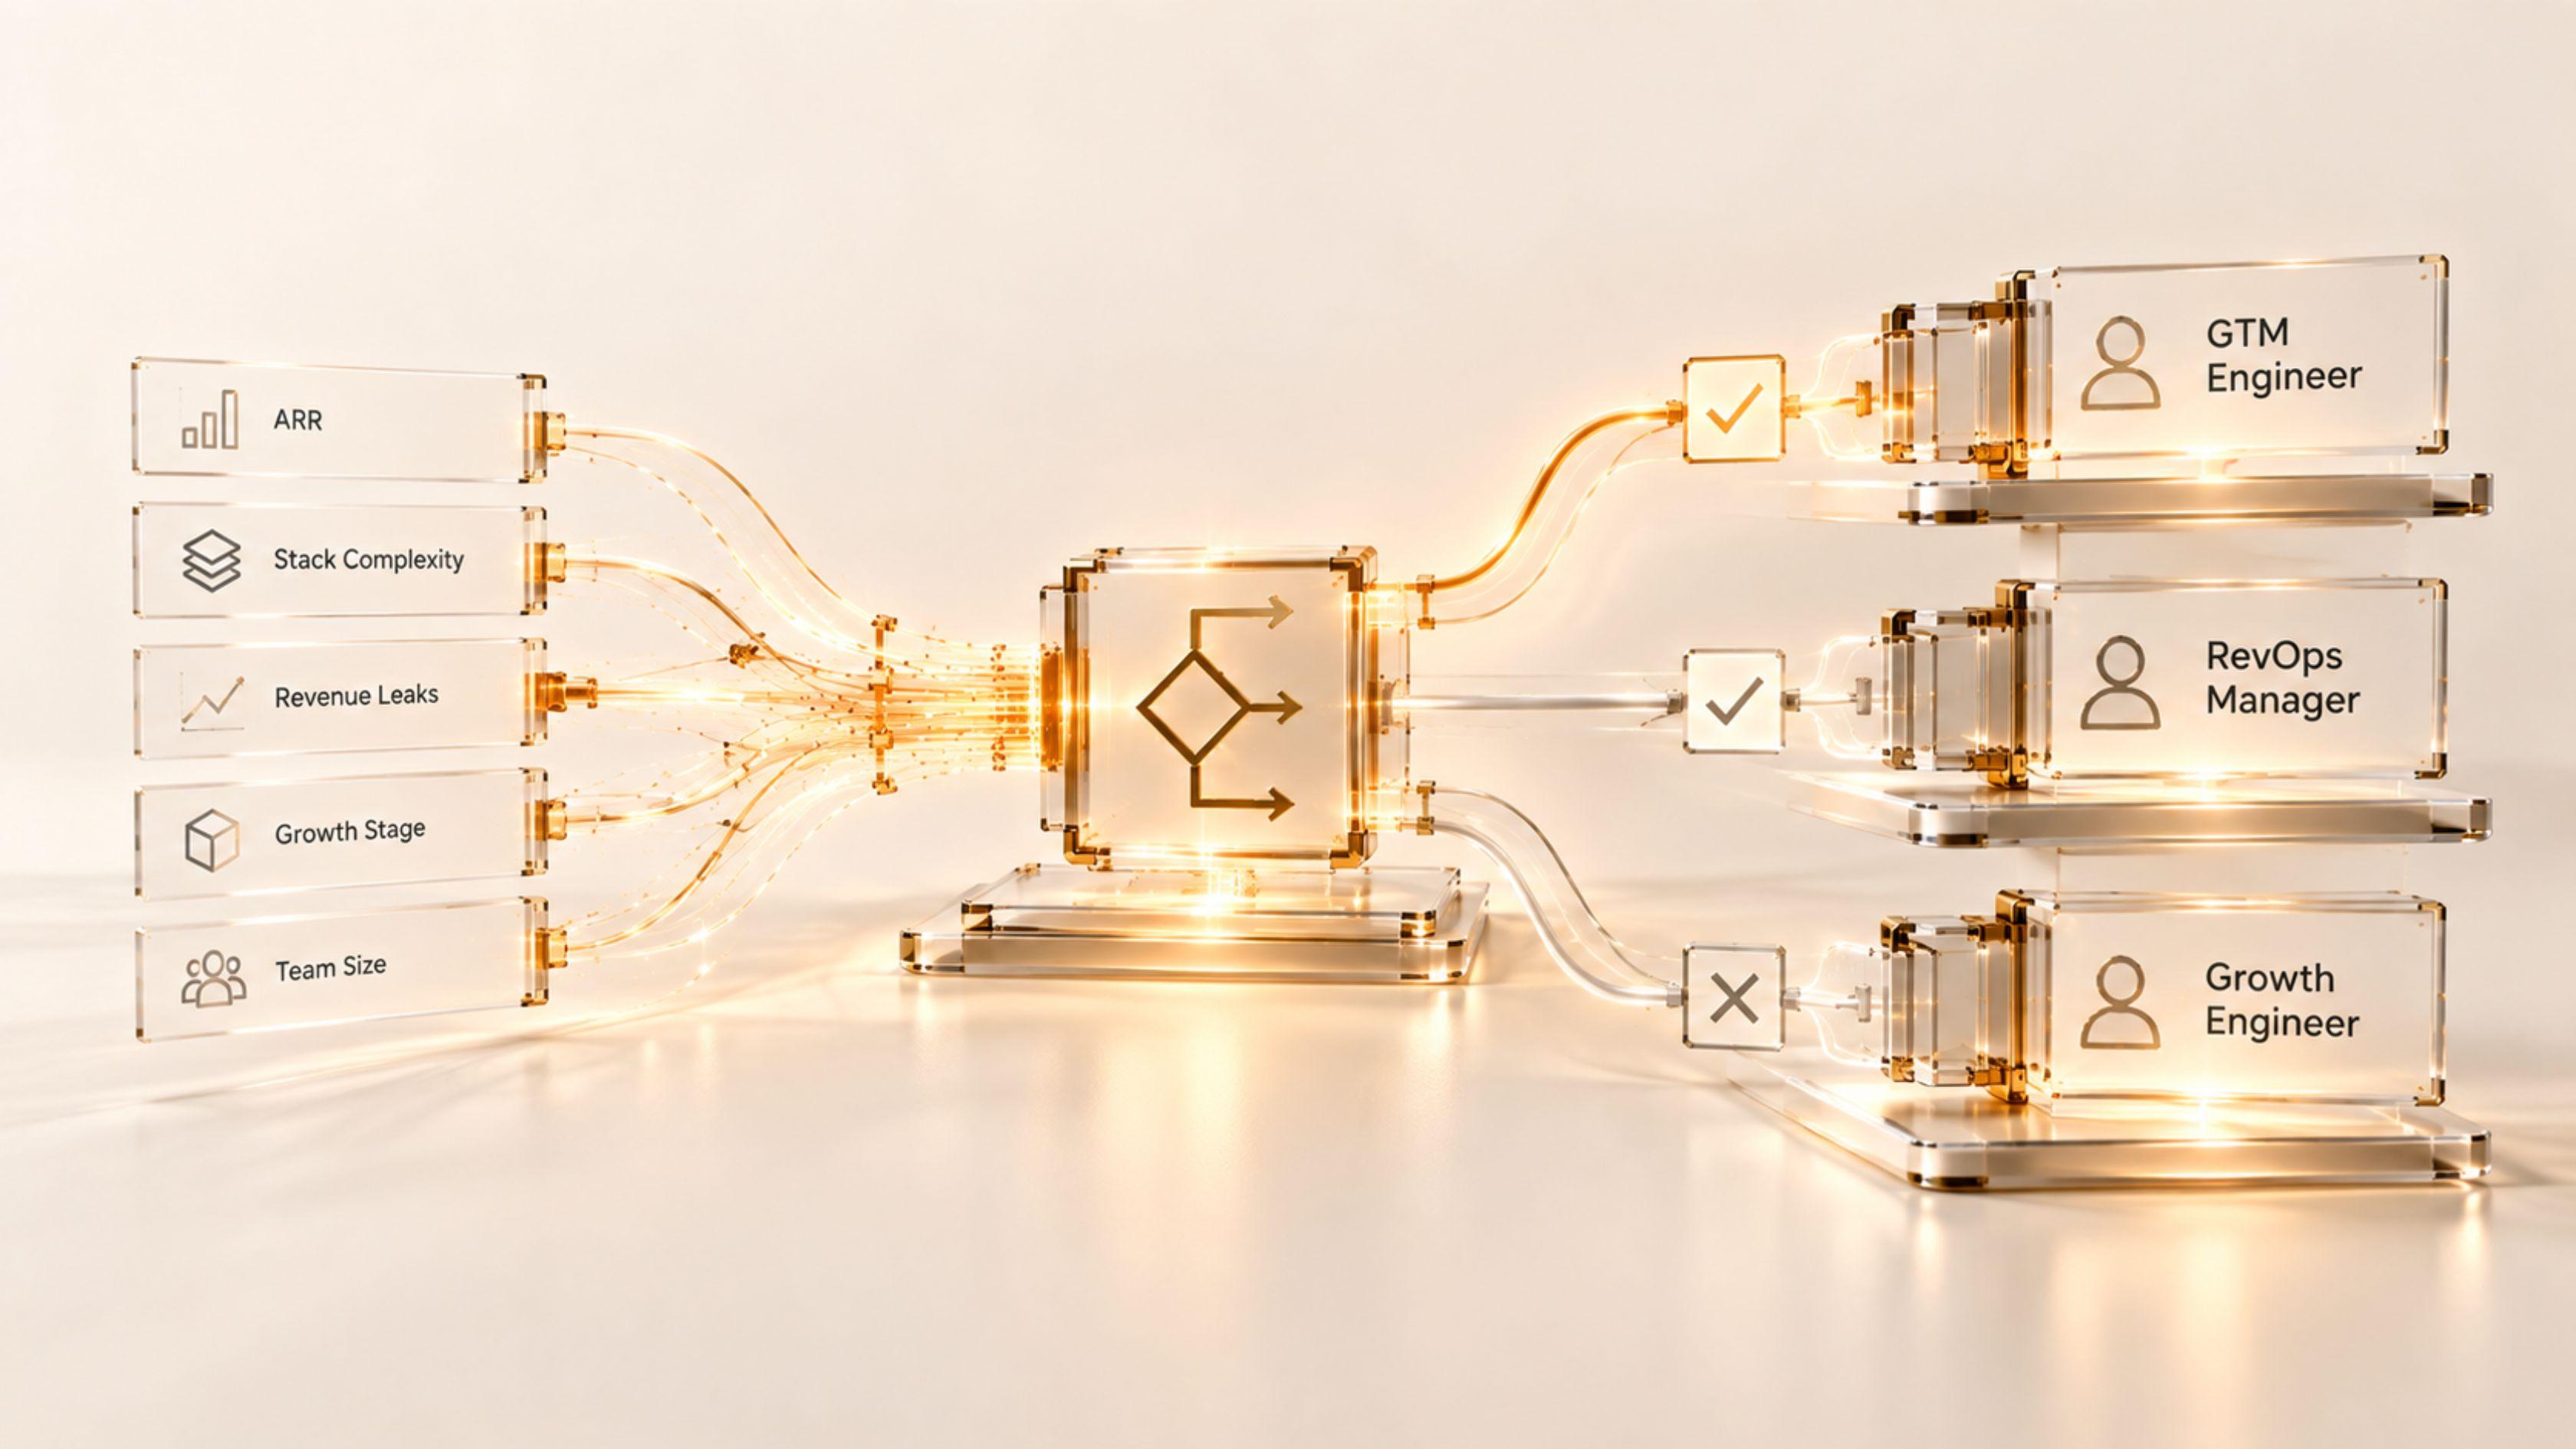
La mayoría de las segundas contrataciones debería empezar con controles nativos y añadir una herramienta solo cuando la tasa de error muestreada siga siendo alta tras cerrar las vías de entrada. Quién debe encargarse de la opción personalizada es una cuestión de diseño organizativo, que analiza el árbol de decisión entre ingeniero GTM y responsable RevOps.
Operación en producción
Revisa semanalmente una lista breve: campos personalizados y automatizaciones nuevos creados fuera del proceso de cambios, escrituras en campos gobernados por actores distintos de su responsable, cuentas Account duplicadas creadas por semana según la vía de entrada, tasa de cumplimentación de campos obligatorios por etapa y tasa de error muestreada en tus tres flujos principales. Un aumento en cualquiera suele apuntar a una integración nueva o a un administrador bienintencionado.
Cuando una regla de validación o una comprobación de responsabilidad bloquea una escritura, el registro va a una cola de excepciones con responsable y tiempo de respuesta, no a un fallo silencioso que un vendedor descubre al final del trimestre. Mantén una anulación de emergencia para la dirección, registrada y revisada cada semana, para que la urgencia no se convierta discretamente en el nuevo proceso.
Presenta la gobernanza en términos de dinero y confianza, no de campos limpiados. Muestra los dólares que pasan por cada flujo gobernado, la tasa de error antes y después y si la cifra de previsión cambia menos entre reuniones semanales. El estudio de Validity de 2025, según informó MediaPost, encontró que el personal dedica unas 13 horas a la semana a buscar datos; el tiempo recuperado es una segunda cifra que la dirección entiende.
Dónde encaja en el sistema
La gobernanza es la condición previa para cualquier sistema que lea el CRM. El Pipeline Hygiene Sentinel es gobernanza en ejecución continua: comprueba los criterios de salida de etapas, las fechas de cierre desactualizadas y los campos ausentes frente a las definiciones que escribiste del día 31 al 60. El Forecast Assistant solo es tan estable como esas definiciones. Speed-to-Lead y el Handoff Orchestrator dependen de un único responsable de OwnerId, Lead Status y Lifecycle Stage, precisamente lo que hace cumplir el mapa de responsabilidad de campos. El mapa completo está en la página de sistemas.
El orden importa más que la lista de tareas. Esa es la razón para recurrir al forward-deployed engineering en una reconstrucción de gobernanza: trabajar dentro de la instancia heredada, cuantificar las fugas con tus propios registros, arreglar un flujo a la vez y demostrar cada cambio con casos reales antes de ponerlo en producción.
Fuentes: Validity, The State of CRM Data Management in 2025 (602 usuarios y administradores de CRM, Estados Unidos, Reino Unido y Australia, julio de 2025); cobertura de MediaPost del estudio de Validity (11 de julio de 2025). Salesforce, investigación State of Sales (5.500 profesionales de ventas, 27 países, 2024). Gartner, investigación sobre calidad de datos (2020).