Abre cualquier cuenta que te importe y búscala por su nombre. En la mayoría de los CRM de SaaS B2B encontrarás al menos tres. Un SDR escribió la primera hace dos años, tal como la oyó en una llamada. La sincronización de automatización de marketing creó la segunda cuando el nombre de empresa de un formulario no coincidía exactamente. Una sincronización de enriquecimiento o de uso del producto escribió la tercera, emparejando solo por su propio identificador. La oportunidad abierta está en el primer registro, los asistentes al último webinar en el segundo y el uso del producto en el tercero.
Probablemente tu equipo ya ha fusionado estos registros antes. Volvieron, porque todos los procesos que los crearon siguieron funcionando. Así que la pregunta no es cómo ejecutar una deduplicación. Es de dónde salen los duplicados y qué arquitectura mínima impide que el stack genere otros nuevos.
Leídas juntas, esas cifras describen un problema estructural. El análisis de Plauti sobre más de 12.000 millones de registros de Salesforce procesados en 2021 encontró que más del 45% de los registros nuevos eran duplicados, y que los creados por integraciones se duplicaban cuatro veces más que los importados. La encuesta de MuleSoft de 2025 a 1.050 responsables de TI encontró que solo el 29% de las 897 aplicaciones de la empresa media está integrado. Los stacks de ingresos de entre $3M y $30M de ARR usan muchas menos herramientas, pero el patrón se mantiene: cada herramienta está conectada al CRM punto a punto, con su propia idea de lo que cuenta como la misma empresa. La baja confianza en los datos, como muestra el State of Sales 2024 de Salesforce, es la consecuencia previsible.
Por eso los duplicados son un problema de sistemas, no de personas ni de herramientas. Formar a los comerciales para que busquen antes de crear corrige la fuente más pequeña. Una herramienta de deduplicación limpia el histórico, y las integraciones lo vuelven a llenar. Lo que falta es un registro canónico: un lugar donde cada empresa y cada persona reales existan una sola vez, una única vía por la que se crean los registros nuevos y una regla que todos los sistemas siguen cuando quieren escribir.
Dónde falla
Si se rastrea su origen, los duplicados salen casi siempre de una de cinco vías de creación, cada una con su propio mecanismo y su propio control.
Formularios web que crean antes de emparejar
Un envío de formulario llega con un email, un nombre de empresa en texto libre y, a veces, un dominio. La plataforma de marketing deduplica a la persona por email, lo cual es razonable, pero la asociación con la empresa suele quedar en manos de la sincronización con el CRM. La sincronización crea un Lead o, en los CRM centrados en contactos, una Company, con el nombre tecleado. "Acme", "Acme Inc." y "ACME Corporation" se convierten en tres valores. Con un email personal no hay dominio corporativo con el que emparejar, así que el registro queda sin vincular. El formulario se configuró para capturar y crear, nunca para resolver primero.
Integraciones y apps de sincronización que esquivan las reglas de duplicados
Es la fuente más grande y la menos visible. La protección nativa contra duplicados se centra en la interfaz de usuario y en las importaciones, mientras que las integraciones escriben a través de la API. La propia documentación de HubSpot indica que las empresas creadas a través de la API no se deduplican por la propiedad Company domain name, y que esto incluye las apps de sincronización de terceros instaladas. En Salesforce, las reglas de duplicados pueden configurarse para permitir o avisar en lugar de bloquear, y un usuario de integración puede configurarse para guardar registros pese a una coincidencia. Cada herramienta de enriquecimiento, agendador, plataforma de inteligencia de conversaciones y conector de facturación con permiso para crear un Account es una puerta distinta y sin vigilancia, y ese es el mecanismo detrás de la cifra del 80% de Plauti.
Creación manual con prisas
Un comercial busca "IBM", el registro se llama "International Business Machines" y se crea una cuenta nueva para poder registrar la llamada. Los duplicados manuales suelen ser la parte más pequeña, y la única fuente que un paso obligatorio de buscar antes de crear resuelve directamente.
Importaciones que usan el nombre en lugar del ID
Las listas de eventos y las referencias de partners se importan por nombre de empresa, porque el archivo no tiene ID del CRM. Plauti encontró que las importaciones se duplicaban en torno al 19%, muy por debajo de las integraciones, pero un solo archivo defectuoso puede crear cientos de registros en una tarde. Si la importación no usa como clave un Record ID o un dominio normalizado, cada discrepancia se convierte en una cuenta nueva.
Personas que cambian de empresa y registros que siguen la clave equivocada
La Oficina de Estadísticas Laborales de EE. UU. informó en septiembre de 2026 de que la antigüedad mediana con el empleador actual era de 4,1 años en enero de 2026, y de 4,9 años en las ocupaciones directivas y profesionales. Cuando un promotor interno se cambia de empresa, su nuevo email corporativo crea un contacto nuevo, a menudo una cuenta nueva, mientras el contacto antiguo se queda en la cuenta antigua con un email antiguo.
Arquitectura de referencia
La arquitectura mínima tiene cinco capas. No requiere una plataforma de datos de clientes ni una suite de gestión de datos maestros. Requiere una sola puerta de creación, una tabla que recuerde el ID de cada sistema y un único conjunto de reglas por escrito. Las herramientas citadas son ejemplos, no recomendaciones.
Componentes: Formularios, automatización de marketing, enriquecimiento, herramientas de agenda y de conversaciones, facturación, eventos del producto e importaciones.
Herramientas de ejemplo: Formularios de HubSpot o Marketo, proveedores de enriquecimiento, Stripe u otro sistema de facturación, un pipeline de analítica de producto.
Contrato con la capa siguiente: Las fuentes envían una solicitud de crear o actualizar con su nombre de fuente, su ID nativo y sus identificadores (email, dominio, nombre de empresa, ID de espacio de trabajo o de cliente). Ninguna fuente puede crear un Account o un Contact directamente.
Componentes: Normalización a la entrada (email en minúsculas, dominio limpio, formas jurídicas eliminadas), una lista de dominios de email gratuitos, una consulta a la tabla de referencias cruzadas, una coincidencia exacta por dominio normalizado y, después, una coincidencia puntuada por nombre y ubicación.
Herramientas de ejemplo: Reglas nativas de emparejamiento, una herramienta dedicada de emparejamiento de lead a cuenta o de deduplicación, o un modelo en el almacén de datos en SQL o dbt. Las reglas de emparejamiento en sí, deterministas y probabilísticas, se explican en resolución de identidades para RevOps B2B.
Contrato con la capa siguiente: Cada solicitud devuelve una de tres respuestas: emparejada con un ID canónico existente, nueva con alta confianza, o ambigua y retenida para revisión. No hay una cuarta respuesta que cree un registro por defecto.
Componentes: La puerta de creación: un único flujo o servicio que hace el upsert, aplica la supervivencia por campo, escribe la fila de referencia cruzada y registra cada creación y cada fusión.
Herramientas de ejemplo: Un flujo del CRM invocado por un usuario de integración, un iPaaS o herramienta de flujos como n8n o Make, o un pequeño servicio a medida detrás de una API.
Contrato con la capa siguiente: Las escrituras son idempotentes. Ejecutar la misma solicitud dos veces produce un registro, no dos, porque el upsert usa como clave el ID canónico y el ID externo de la fuente.
Componentes: Account y Contact como objetos canónicos, un campo de ID externo por sistema integrado, una tabla de referencias cruzadas, jerarquía de matriz y filiales, y un historial de fusiones.
Herramientas de ejemplo: Salesforce o HubSpot, con la tabla de referencias cruzadas como objeto personalizado o como tabla del almacén de datos sincronizada de vuelta.
Contrato con la capa siguiente: Cada empresa real existe una sola vez, y el ID que cada sistema tiene para ella apunta a ese registro canónico.
Componentes: Asignación, secuencias, puntuación, atribución, reporting y cualquier agente de IA que lea o escriba registros.
Herramientas de ejemplo: Herramientas de asignación, plataformas de sales engagement, herramientas de BI, asistentes de IA.
Contrato con la capa siguiente: Las herramientas de activación leen y actualizan registros canónicos. Nunca crean cuentas. Si una herramienta necesita un registro que no existe, llama a la puerta.
El objeto que hace que esto funcione es la tabla de referencias cruzadas. Es lo que permite que un sistema de facturación, una base de datos de producto y una herramienta de enriquecimiento conserven cada uno sus propios ID mientras todos apuntan a una sola cuenta. Al fusionar, las filas del registro retirado se reasignan, no se borran, para que la siguiente sincronización encuentre el registro superviviente en lugar de volver a crear el antiguo.
# Illustrative cross-reference schema (one row per source ID)
xref_id           unique key
canonical_id      Account or Contact ID that survives
object_type       account | contact
source_system     hubspot | enrichment | billing | product | import
source_id         the source's native ID (e.g. workspace_id, customer_id)
match_rule        xref | domain_exact | email_exact | scored_high | manual
match_confidence  1.00 | 0.95 | score
created_at / last_seen_at
status            active | repointed_after_merge (keeps retired_canonical_id)
Secuencia de construcción
El orden importa. Los equipos que empiezan por la fusión puntual ven cómo vuelven los duplicados, porque las vías de creación siguen abiertas. Cierra primero las puertas y después unifica el histórico.
Mapea a cada creador
Enumera cada sistema y cada usuario con permiso de creación sobre Account, Contact y Lead, la clave sobre la que hace upsert y su volumen de registros en los últimos 90 días. El campo CreatedBy y el campo de origen suelen localizar la mayoría de los duplicados en un día. El playbook de diagnosticar antes de construir explica cómo hacerlo en modo solo lectura.
Mide las tres líneas base
Tras normalizar dominios y emails, cuenta las cuentas que comparten un dominio corporativo, los contactos que comparten un email y los contactos cuyo dominio de email coincide con una cuenta a la que no están vinculados. Desglosa cada cifra por fuente de creación. Esas cifras serán tu antes y después, y el desglose por fuente te dice qué puerta cerrar primero.
Cierra las puertas
Retira el permiso de creación sobre Account a los usuarios de integración, un sistema cada vez, y haz pasar esas escrituras por la puerta de creación. Añade un campo de ID externo por sistema y cambia cada sincronización de crear a upsert sobre ese ID. Configura las reglas de duplicados para bloquear en el caso de los usuarios y para informar en el del usuario de integración, de modo que nada pase en silencio.
Escribe las reglas de supervivencia
Antes de cualquier fusión, decide campo por campo qué valor sobrevive: el responsable del registro con la oportunidad abierta, el sector y el número de empleados de la fuente de enriquecimiento, la etapa del ciclo de vida del registro más avanzado, los identificadores de facturación de facturación. Déjalo por escrito. Una fusión sin regla de supervivencia es una migración de datos sin registro.
Unifica el histórico con reglas probadas
Aplica la lógica de fusión a grupos de duplicados que tu equipo ya haya valorado, unos veinte por regla. Nuestro listón para todo lo que lanzamos es un 85 por ciento de coincidencia con lo que habría decidido un operador sénior, o no se pone en marcha, y las fusiones merecen ese listón porque son difíciles de revertir. Después fusiona por lotes, empezando por la mayor confianza y reasignando las filas de referencia cruzada.
Alerta cuando vuelvan a crecer
Repite cada semana las tres líneas base y genera una alerta cuando cualquiera crezca, desglosada por fuente. Tarde o temprano un formulario o un conector nuevo intentará crear registros directamente, y la alerta lo detecta esa misma semana en lugar del trimestre siguiente.
Construir o comprar: ventajas y desventajas
Hay tres formas realistas de construir el registro canónico y su puerta de creación. La mayoría de los stacks de entre $3M y $30M de ARR combinan las dos primeras, y añaden la tercera cuando los datos de producto y de facturación tienen que unirse a la cuenta.
| Enfoque | Encaje | Coste de propiedad | Riesgo de fallo |
|---|---|---|---|
| Reglas nativas de duplicados, propiedades únicas y campos de ID externo del CRM | Un solo CRM, unas pocas integraciones, mayoritariamente dominios de email corporativos | El más bajo. Configuración y tiempo de administración | La protección es más fuerte en la interfaz de usuario y en las importaciones. Las escrituras por API y las apps de sincronización pueden esquivarla salvo que se les retiren los permisos y sus escrituras pasen por un flujo |
| Herramienta dedicada de deduplicación o de emparejamiento de lead a cuenta, o un flujo de iPaaS como puerta de creación | Los duplicados entran sobre todo por formularios e integraciones, y la asignación depende del emparejamiento | Una licencia o plataforma de flujos más alguien que ajuste las reglas y atienda la cola de revisión | Si otros sistemas conservan el permiso de creación, la herramienta se convierte en una opinión más sobre la identidad. Las reglas viven en la configuración del proveedor y deben documentarse fuera de ella |
| Modelo de identidad en el almacén de datos con tabla de referencias cruzadas y reverse ETL | Producto, facturación y varias fuentes deben resolverse en una sola cuenta | El más alto. Necesita un ingeniero de datos o de GTM que se responsabilice de los modelos, las pruebas y las sincronizaciones | Los ID canónicos pueden desviarse del CRM si una sincronización falla en silencio. Necesita monitorización y un contrato de escritura por escrito |
Elijas la vía que elijas, el factor decisivo no es el algoritmo de emparejamiento sino que todos los creadores pasen por la misma puerta. Una herramienta sofisticada con cinco sistemas creando registros a su alrededor pierde frente a un flujo sencillo que es la única forma de entrar. Quién es responsable de esa puerta es en parte una cuestión organizativa, y el árbol de decisión GTM engineer frente a RevOps manager es una forma útil de resolverla.
En producción
Vigila cuatro cifras cada semana, cada una desglosada por fuente de creación: cuentas nuevas que comparten dominio con otra existente, contactos que comparten email, contactos sin vincular a la cuenta de su dominio, y el tamaño y la antigüedad de la cola de revisión. Añade una quinta: registros creados por cualquier usuario que ya no debería tener permiso de creación. Esa debe ser siempre cero.
Si la puerta está caída, las solicitudes esperan en cola en lugar de crear. No fusiones nunca automáticamente por debajo de tu umbral de alta confianza. Registra cada fusión con los ID retirados, el ID superviviente y los valores anteriores de cada campo que cambió, para que una fusión errónea se pueda deshacer en minutos y no haya que reconstruirla de memoria.
La dirección no necesita el esquema. Necesita saber que el pipeline por cuenta, el número de clientes nuevos y la cobertura dan por hecho que una empresa es un registro. La encuesta State of Data and Analytics de Salesforce de 2025 encontró que el 49% de los responsables de datos afirma que su organización saca de vez en cuando o con frecuencia conclusiones erróneas de datos con poco contexto de negocio. Las cuentas duplicadas son una de las formas más directas en que eso ocurre en un equipo de ingresos: una ampliación contada como cliente nuevo, un mismo grupo comprador repartido entre tres responsables.
Dónde encaja en el sistema
Un registro canónico rara vez aparece por sí solo en una hoja de ruta, y por eso se aplaza. Aparece como el motivo por el que otros sistemas rinden por debajo de lo esperado. Speed-to-Lead solo puede asignar en minutos una solicitud entrante al responsable correcto si el lead se vincula a la cuenta correcta al llegar. El Handoff Orchestrator lleva el contexto de marketing al SDR, al AE y a CS, y ese contexto se dispersa cuando cada etapa trabaja con una copia distinta de la cuenta. El Pipeline Hygiene Sentinel es la capa de monitorización de esta arquitectura: señala registros duplicados y huérfanos, y creaciones desde fuentes no aprobadas, antes de que distorsionen el pipeline. En el lado del reporting, el Board Report Engine solo puede contar bien clientes, logos y retención neta de ingresos si cada cliente se cuenta una sola vez. El mapa completo está en la página de sistemas.
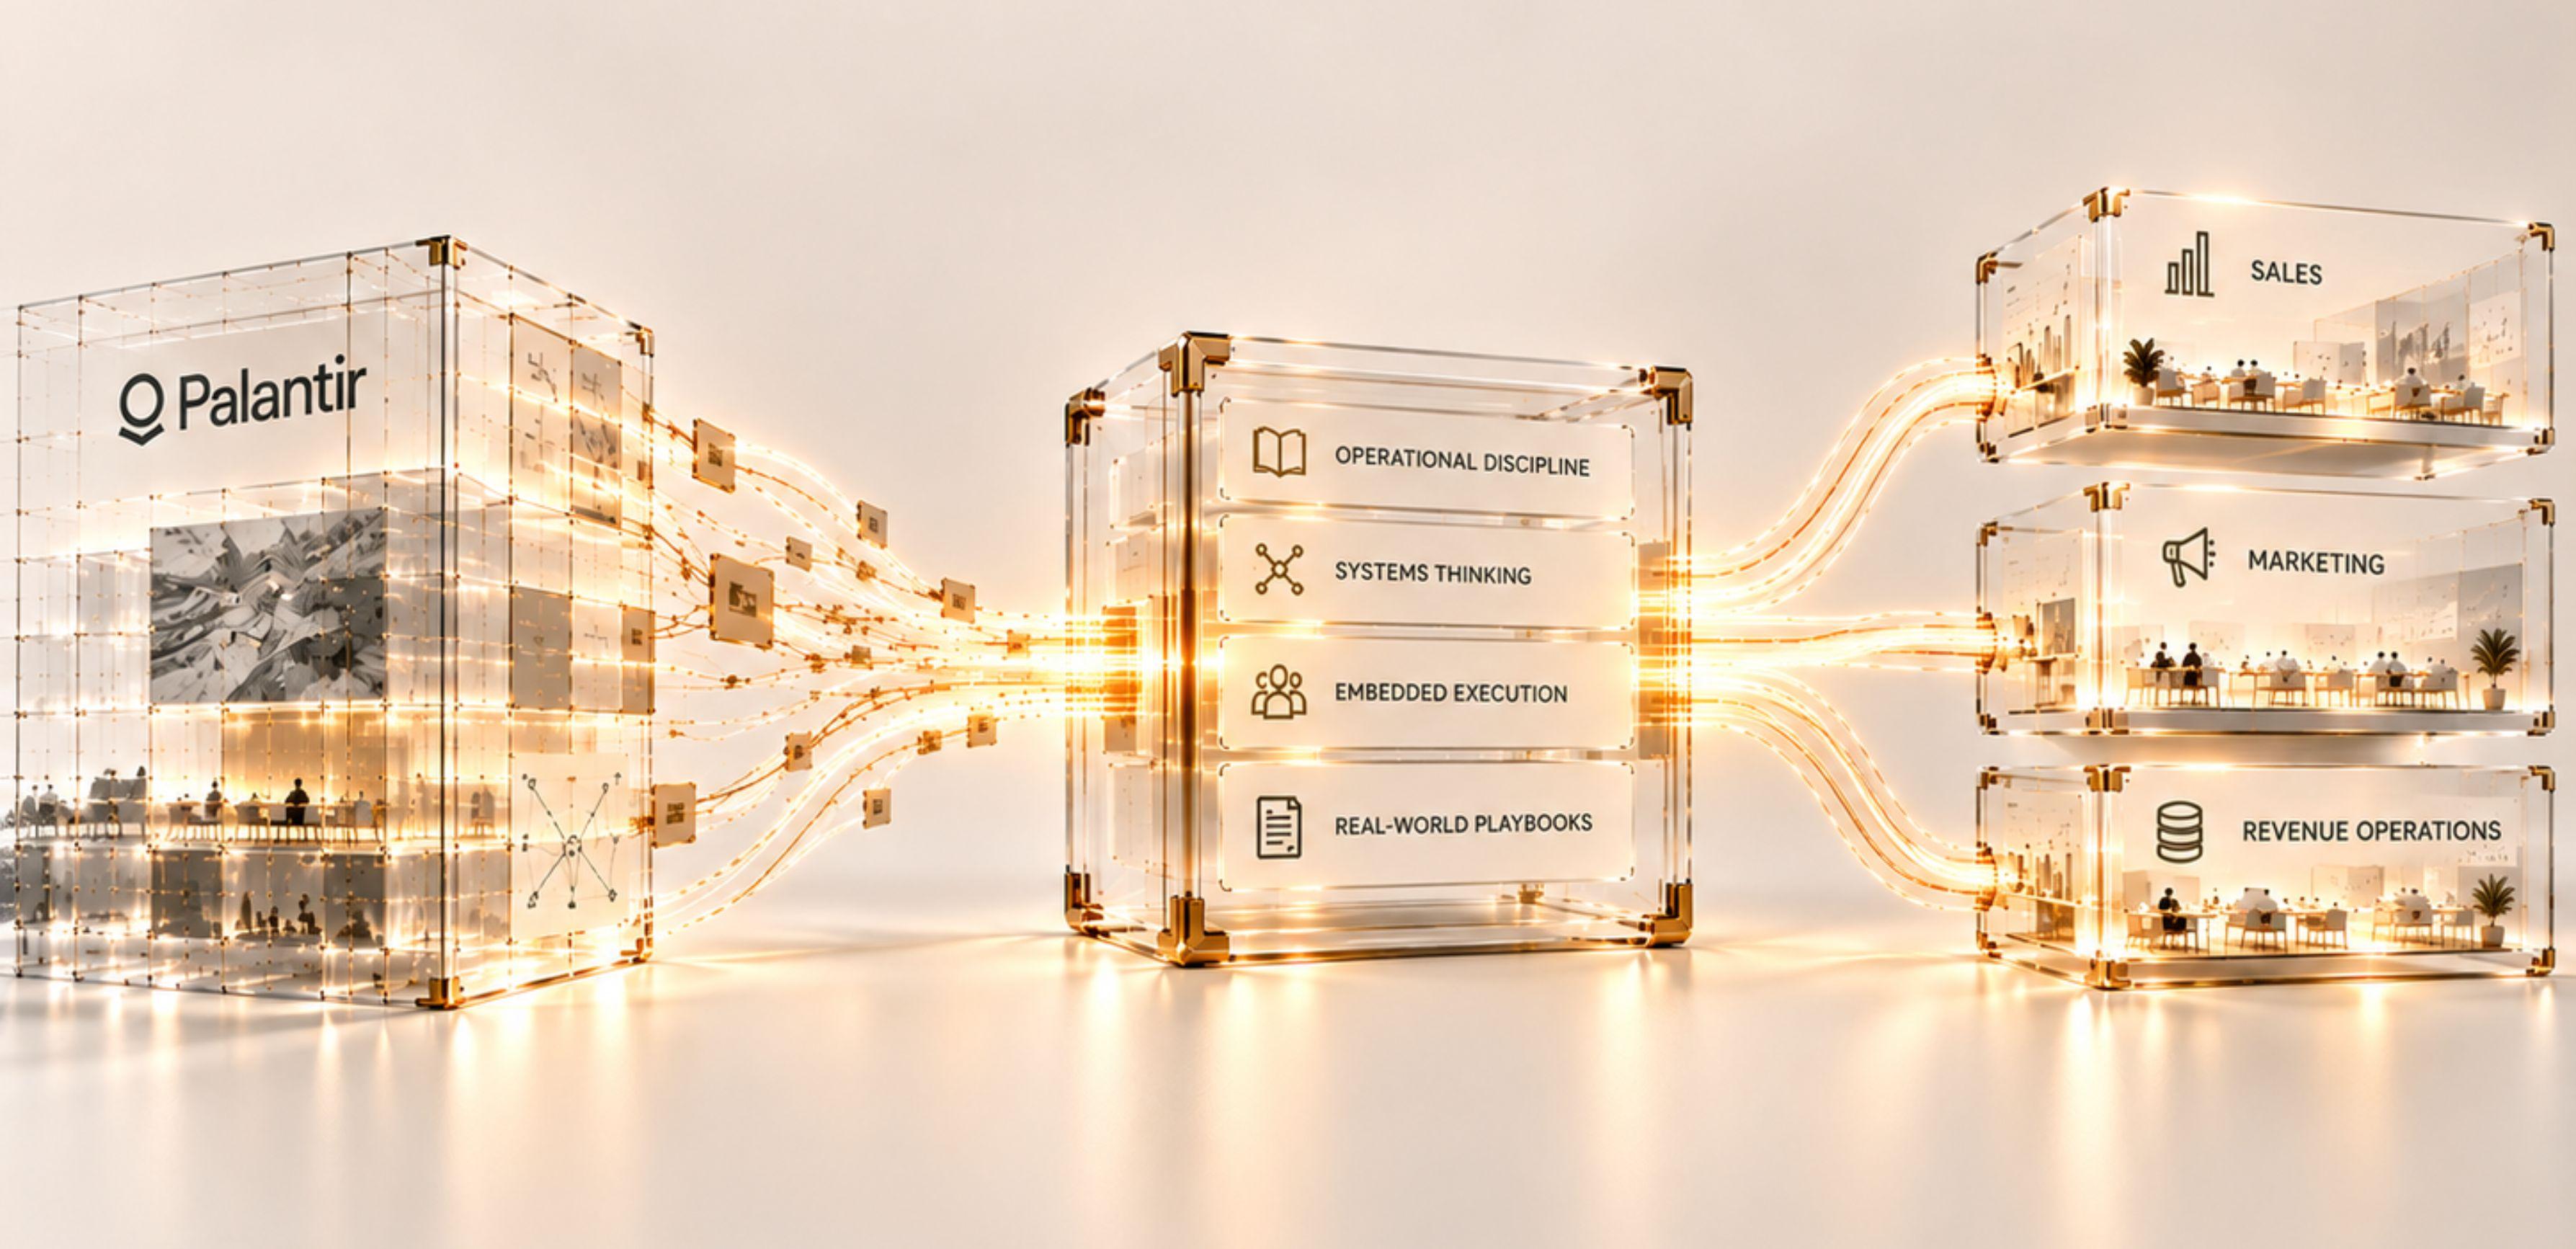
Por eso también la solución tiene que estar dentro de tu stack y no en una diapositiva. La encuesta de Validity de 2025 a 602 usuarios de CRM encontró que el 76% afirma que menos de la mitad de los datos de su CRM son precisos y completos. Solo un cambio en quién puede crear registros, y en qué orden se ejecutan las reglas, impide que eso se repita. Esa es la lógica del forward-deployed engineering: cerrar las puertas en tu propio stack, probar las reglas de fusión con tu propio historial y dejar un sistema que mantenga el registro íntegro cuando los ingenieros se retiran.
Fuentes: Plauti, "80% of all new integration data in CRMs is duplicate" (análisis de más de 12.000 millones de registros de Salesforce en 2021, enero de 2022; copia archivada, la página original se ha retirado). Salesforce, State of Sales (n=5.500, julio de 2024). MuleSoft, 2025 Connectivity Benchmark Report, con Vanson Bourne y Deloitte Digital (n=1.050, enero de 2025). HubSpot Knowledge Base, "Deduplication of records" (consultado en octubre de 2026). Oficina de Estadísticas Laborales de EE. UU., Employee Tenure (datos de enero de 2026, publicados en septiembre de 2026). Salesforce, State of Data and Analytics (n=7.652, noviembre de 2025). Validity, The State of CRM Data Management in 2025 (n=602).