Es probable que lo hayas vivido, quizá con otro nombre. Un proveedor integra a un ingeniero en tu equipo de RevOps. Obtiene acceso de lectura a Salesforce, HubSpot y tu almacén de datos. Empieza a mapear objetos: Lead, Opportunity, Account, la tarea de sincronización entre tu plataforma de automatización de marketing y el CRM, los disparadores que se activan al cambiar de etapa. A los tres meses sigue mapeando. A los seis, tiene acceso de escritura a dos sistemas y una lista creciente de elementos para la "fase dos". A los doce, estás pagando a un ingeniero a tiempo completo que depende del organigrama de un proveedor, y nadie sabe decirte qué se entregó, cuánto cuesta mantenerlo ni qué pasa si esa persona concreta se va. El trabajo nunca tuvo un límite. Solo tuvo una fecha de inicio.
No es un problema de personas ni de herramientas. Es lo que ocurre cuando tomas prestado el modelo de forward-deployed engineering sin tomar prestada la restricción que lo hace funcionar: un diagnóstico de alcance fijo antes de que nadie escriba una sola línea de lógica de orquestación.
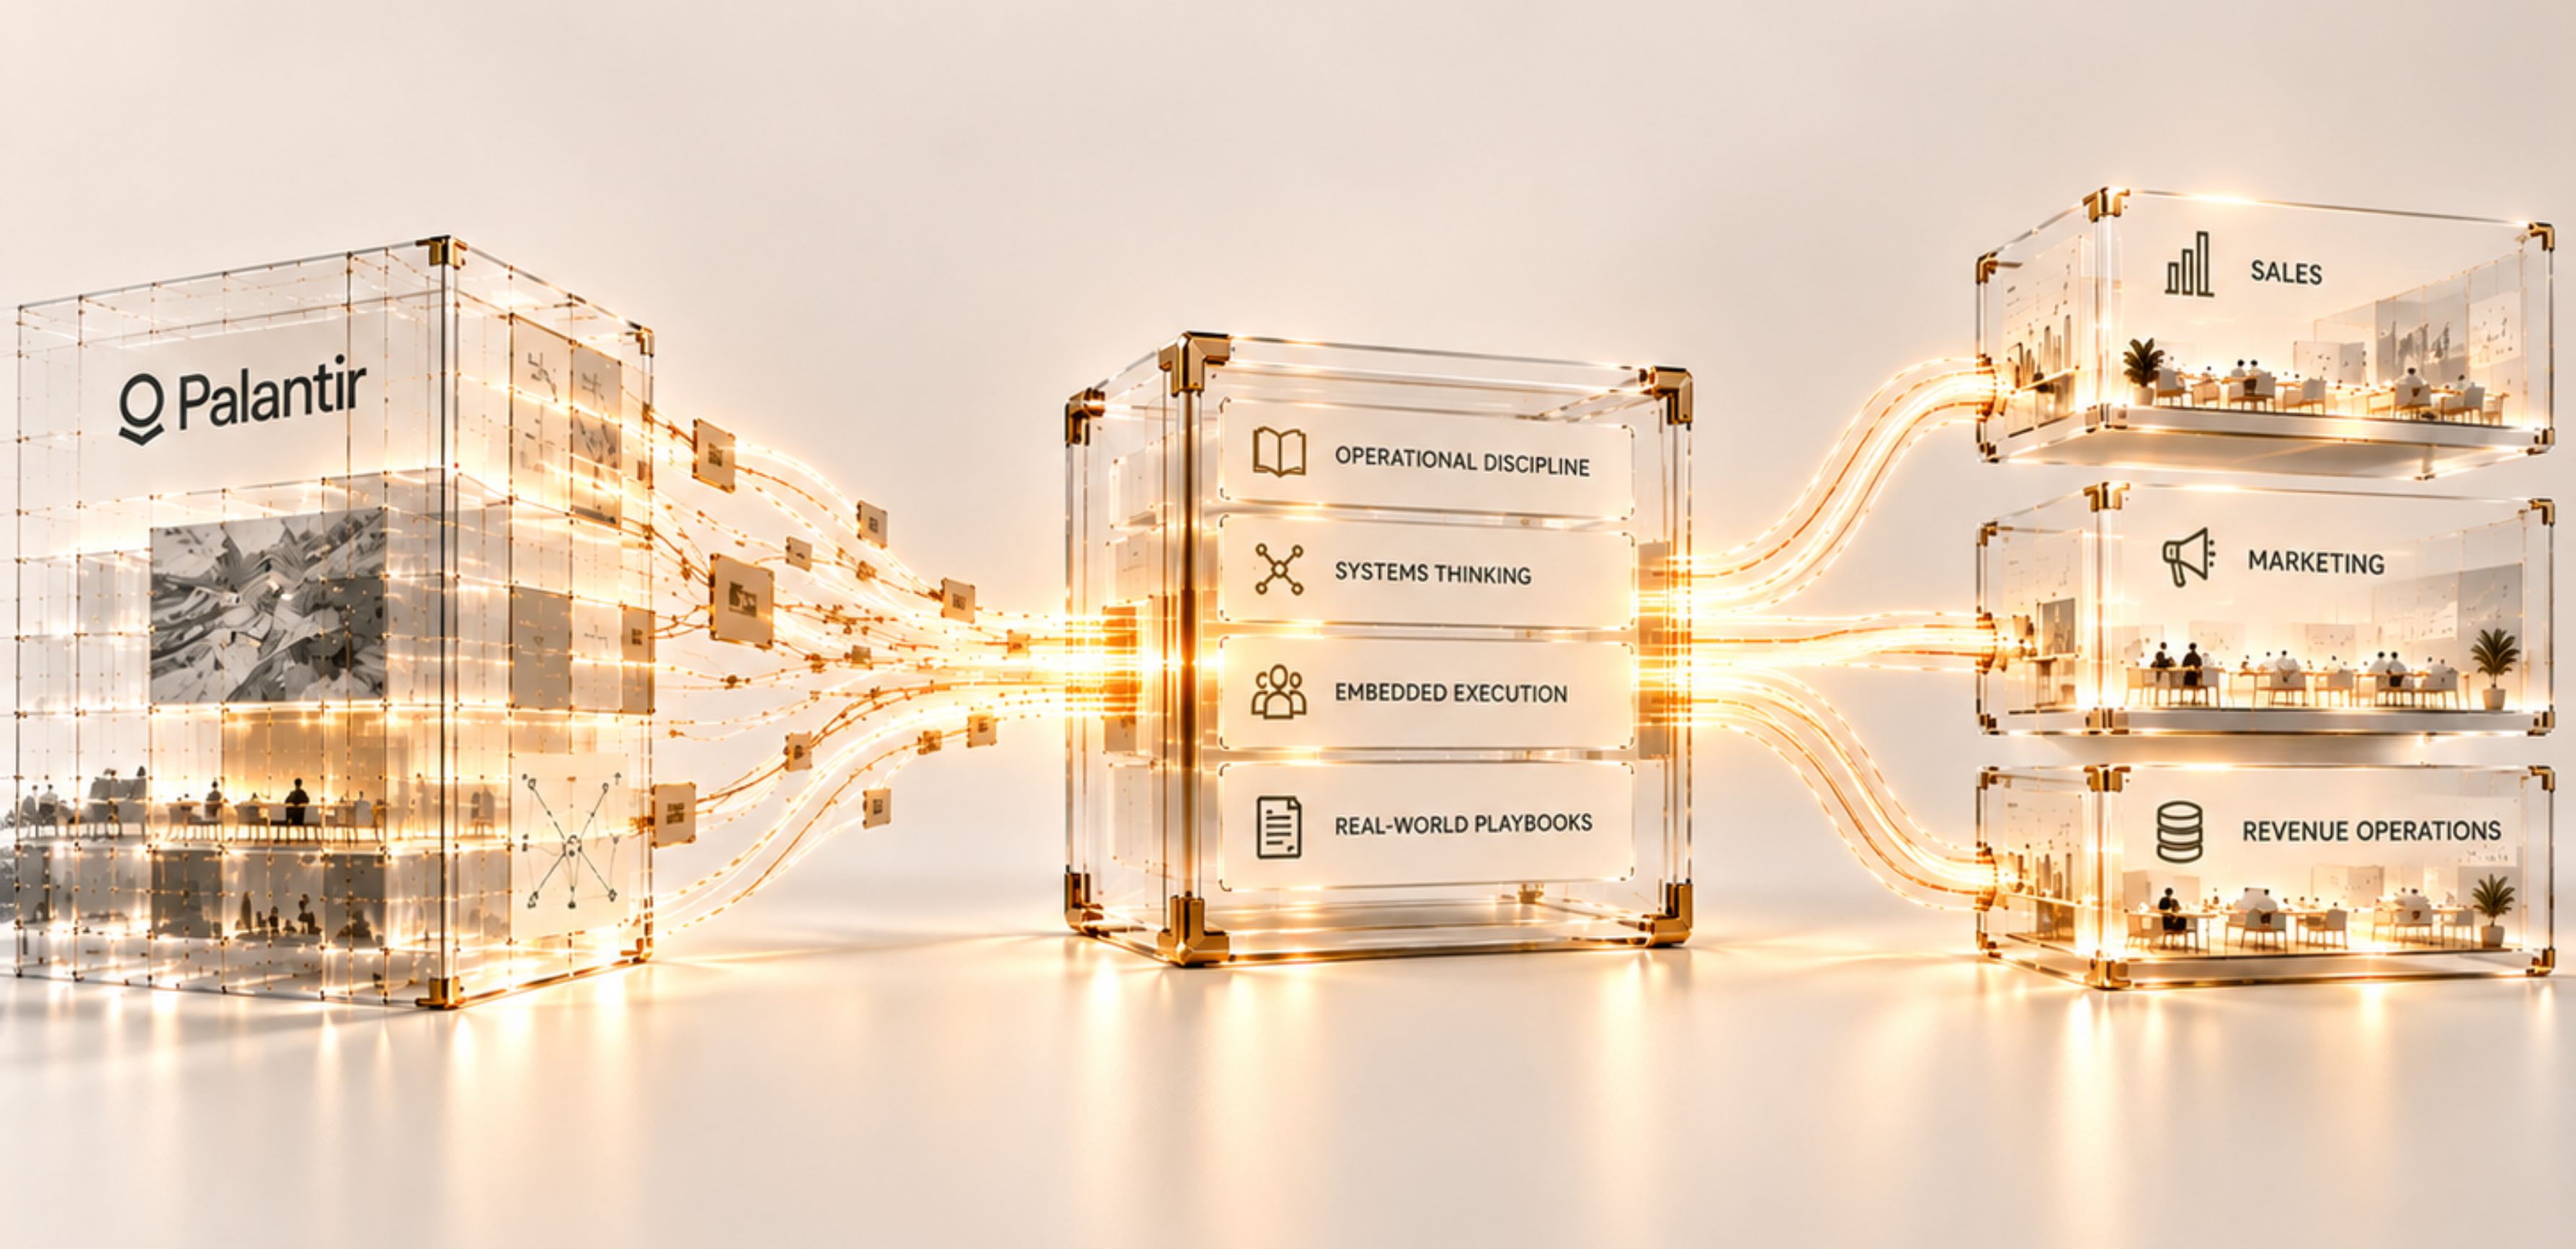
Palantir creó el modelo FDE para resolver un problema concreto: el software que tiene que funcionar dentro de un entorno operativo existente, caótico y de alto riesgo (un campo de batalla, una cadena de suministro, un sistema hospitalario) no puede especificarse a distancia. Alguien tiene que sentarse dentro de ese entorno, ver los datos reales y construir sobre lo que realmente hay, no sobre lo que dice el documento de requisitos. Los equipos de ingresos tienen el mismo problema. Tu lógica de asignación de leads, tus disparadores de traspaso, tu consolidación de la previsión: nada de eso puede diseñarse bien a partir de una reunión de arranque y una presentación de descubrimiento. Alguien tiene que mirar tu instancia real de Salesforce, tus tareas de sincronización reales y tu desorden real a nivel de campo antes de poder construir algo que sobreviva al contacto con producción.
Esa parte del playbook se traslada sin problemas. Lo que no se traslada automáticamente es la disciplina que impide que un ingeniero integrado se convierta en una partida permanente de la que nadie rinde cuentas. El modelo de Palantir funciona porque el ingeniero forward-deployed trabaja contra una misión definida con criterios de éxito definidos, no porque integrarse sea mágico en sí. Quita el alcance fijo y "forward-deployed" no es más que una forma elegante de llamar a la ampliación de plantilla con mejor marca.
Dónde falla
Los modos de fallo que siguen son concretos, no quejas genéricas del tipo "la consultoría sale mal". Cada uno deja una huella concreta en tu stack: un campo que nunca recibió una definición, un disparador del que nadie es responsable, una tarea de sincronización que empezó a perder registros sin avisar.
El ingeniero integrado se convierte en una partida de plantilla sin condición de salida
Es el fallo más común, y es estructural, no personal. Sin un diagnóstico por escrito (objetos concretos, puntos de fallo concretos, sistemas concretos que construir), el trabajo de un ingeniero integrado se expande de forma natural hasta llenar el calendario. Le llegan peticiones sobre la marcha: "¿puedes arreglar también el campo de puntuación de leads?", "¿puedes mirar también por qué no cuadra la consolidación de la previsión?". Todas esas peticiones son legítimas. Ninguna estaba en el alcance. Dieciocho meses después has pagado por una persona, no por un sistema, y el conocimiento de esa persona (qué campos importan, qué disparadores sostienen todo, por qué la tarea de sincronización se ejecuta en ese orden) vive en su cabeza, no en un runbook.
Acceso de lectura para siempre, acceso de escritura nunca
El principio de "primero acceso de lectura" del modelo FDE es correcto: no deberías dejar que nadie escriba en producción antes de entender qué ocurre realmente en las transiciones de Opportunity.StageName o en la lógica de conversión de Contact a Lead. Pero algunos proveedores se quedan ahí. Permanecen en modo observación indefinidamente, produciendo paneles y recomendaciones, porque pasar al acceso de escritura les obliga a comprometerse con un resultado comprobable. Quedarse en solo lectura para siempre no es prudencia. Es una forma de evitar el momento en que un sistema funciona o no funciona.
Software que no se queda porque nunca estuvo pensado para irse con nadie más que el ingeniero
El objetivo declarado de Palantir es que los ingenieros forward-deployed acaben dejando software que el cliente pueda operar por su cuenta. En los trabajos de GTM, aquí es donde la mayoría de los proveedores fallan sin hacer ruido. La lógica de asignación se construye en una cuenta personal de Zapier, en un disparador Apex a medida sin comentarios o en un flujo de una herramienta para la que el cliente no tiene licencia empresarial. No hay ningún contrato de datos que documente qué campos lee la lógica, qué eventos escucha y qué escribe de vuelta. Cuando termina el trabajo, el "sistema" es en realidad el criterio no documentado de una persona, codificado de forma precaria en una herramienta. Se rompe la primera vez que alguien cambia el nombre de un campo.
Ningún diagnóstico de alcance fijo antes de empezar a construir
Esta es la causa raíz de los tres primeros. La consultoría sin límites aparece cuando el descubrimiento y la construcción se funden en una misma fase abierta. No hay ningún momento en que alguien diga: este es el registro de fugas, estos son los sistemas concretos que lo cierran, esto es lo que significa "terminado" para cada uno. Sin ese momento, el alcance no tiene dónde dejar de crecer, porque cada nuevo hallazgo durante el trabajo parece una justificación para más trabajo en lugar de un candidato para un futuro sistema con su propio alcance.
La propiedad del sistema de registro nunca se transfiere
Incluso cuando el software se construye y se queda, la propiedad a menudo no. El proveedor sigue siendo el único que puede modificar con seguridad el disparador o la tarea de sincronización, así que "el software se quedó" es técnicamente cierto y operativamente falso. Sigues dependiendo del proveedor para cada cambio, que es el mismo bloqueo que una partida de plantilla, solo que con otra ropa.
Arquitectura de referencia
Estas son las capas que un trabajo forward-deployed tiene que tocar realmente en un stack de ingresos B2B SaaS, en orden. El principio de diseño que evita que se convierta en consultoría sin límites es que cada capa tiene un contrato de datos explícito con la de arriba y la de abajo, de modo que cualquier ingeniero, incluso uno que nunca estuvo en la sala, puede leer el contrato y saber qué espera y qué produce cada capa.
Eventos de uso del producto, formularios completados, datos de intención, transcripciones de llamadas, tickets de soporte. Herramientas de ejemplo: Segment, un pipeline de analítica de producto, Clearbit u otras fuentes de enriquecimiento similares, datos de llamadas de Gong o Chorus. Contrato con la capa superior: cada evento de origen lleva un identificador estable (dominio de la cuenta, email del contacto o un ID de entidad asignado por el almacén de datos) y una marca de tiempo. Ningún evento debería poder consumirse aguas abajo sin ellos.
Lógica de deduplicación, resolución de entidades entre sistemas, estandarización de campos. Herramientas de ejemplo: una capa de reverse ETL, un almacén de datos (Snowflake, BigQuery) que hace el emparejamiento, o reglas nativas de deduplicación del CRM para los casos sencillos. Contrato: cada sistema aguas abajo recibe un único registro canónico por cuenta y por contacto, con una regla de emparejamiento documentada, no cinco registros de "Account" superpuestos con distintas grafías de la misma empresa.
Las reglas reales de asignación, puntuación y activación: asignación de speed-to-lead, condiciones de traspaso, umbrales de señal para prospección. Herramientas de ejemplo: una capa iPaaS (Workato, Tray), los editores de flujos nativos del CRM o código a medida cuando la lógica es demasiado condicional para herramientas visuales. Contrato: cada regla se activa con un evento con nombre y versión (lead.created, stage.changed, signal.detected) y escribe su resultado en un campo concreto con una definición documentada, no en una nota de texto libre.
Salesforce o HubSpot como modelo de objetos de referencia para el estado de Account, Opportunity y Contact. Contrato: los campos que escribe la lógica de orquestación pertenecen a esa lógica. No se sobrescriben a mano sin el cambio correspondiente en la regla, y cada escritura automática es atribuible a una tarea o disparador concreto, visible en el historial del campo.
Donde el sistema actúa de verdad: un SDR recibe una alerta en minutos, un comercial ve un aviso de higiene del pipeline, un CSM recibe una señal de abandono, un informe para el consejo se genera solo. Herramientas de ejemplo: alertas de Slack, tareas dentro del CRM, un agente de IA que redacta mensajes de prospección. Contrato: cada activación remite a la regla y al registro concretos que la provocaron, para que un comercial o un directivo pueda rastrear "por qué recibí esto" hasta un evento concreto, no una caja negra.
// example data contract, Layer 3 -> Layer 4
event: lead.speed_to_lead_breach
fires_when: Lead.CreatedDate + 5min elapsed AND Lead.Status = 'New' AND Lead.OwnerAssignedAt IS NULL
writes_to: Lead.SLA_Breach_Flag__c (boolean), Lead.SLA_Breach_Timestamp__c
owned_by: orchestration layer, job "speed-to-lead-monitor"
downstream_consumer: Layer 5 Slack alert to Lead.Owner + RevOps channel
Secuencia de construcción
Construir o comprar: ventajas y desventajas
| Enfoque | Encaje | Coste de propiedad | Riesgo de fallo |
|---|---|---|---|
| Automatización nativa del CRM (flows, workflows) | Adecuada para lógica sencilla de un solo objeto: un disparador, una actualización de campo | Bajo al inicio, crece rápido a medida que la lógica condicional se multiplica entre objetos | Fallos silenciosos cuando se renombran campos o el orden de los flujos choca con otras automatizaciones |
| iPaaS o herramienta de flujos (Workato, Tray, tipo Zapier) | Adecuada para orquestar varios sistemas cuando la lógica es moderadamente compleja pero no requiere puntuación a medida ni NLP | Moderado: licencias más una persona que entienda el grafo completo de flujos, no solo un paso | Frágil ante cambios de API en las herramientas conectadas; los fallos suelen pasar desapercibidos sin monitorización explícita |
| Código a medida o ingeniería integrada (forward-deployed) | El mejor encaje cuando la lógica tiene que razonar sobre datos reales, condicionales y desordenados: puntuación, respuestas de agentes, criterio entre objetos | Más alto al inicio, pero más bajo a largo plazo si la propiedad y la documentación se transfieren de verdad | El riesgo más alto cuando el alcance no tiene límites; el más bajo cuando está acotado, probado con datos reales y entregado con un runbook |
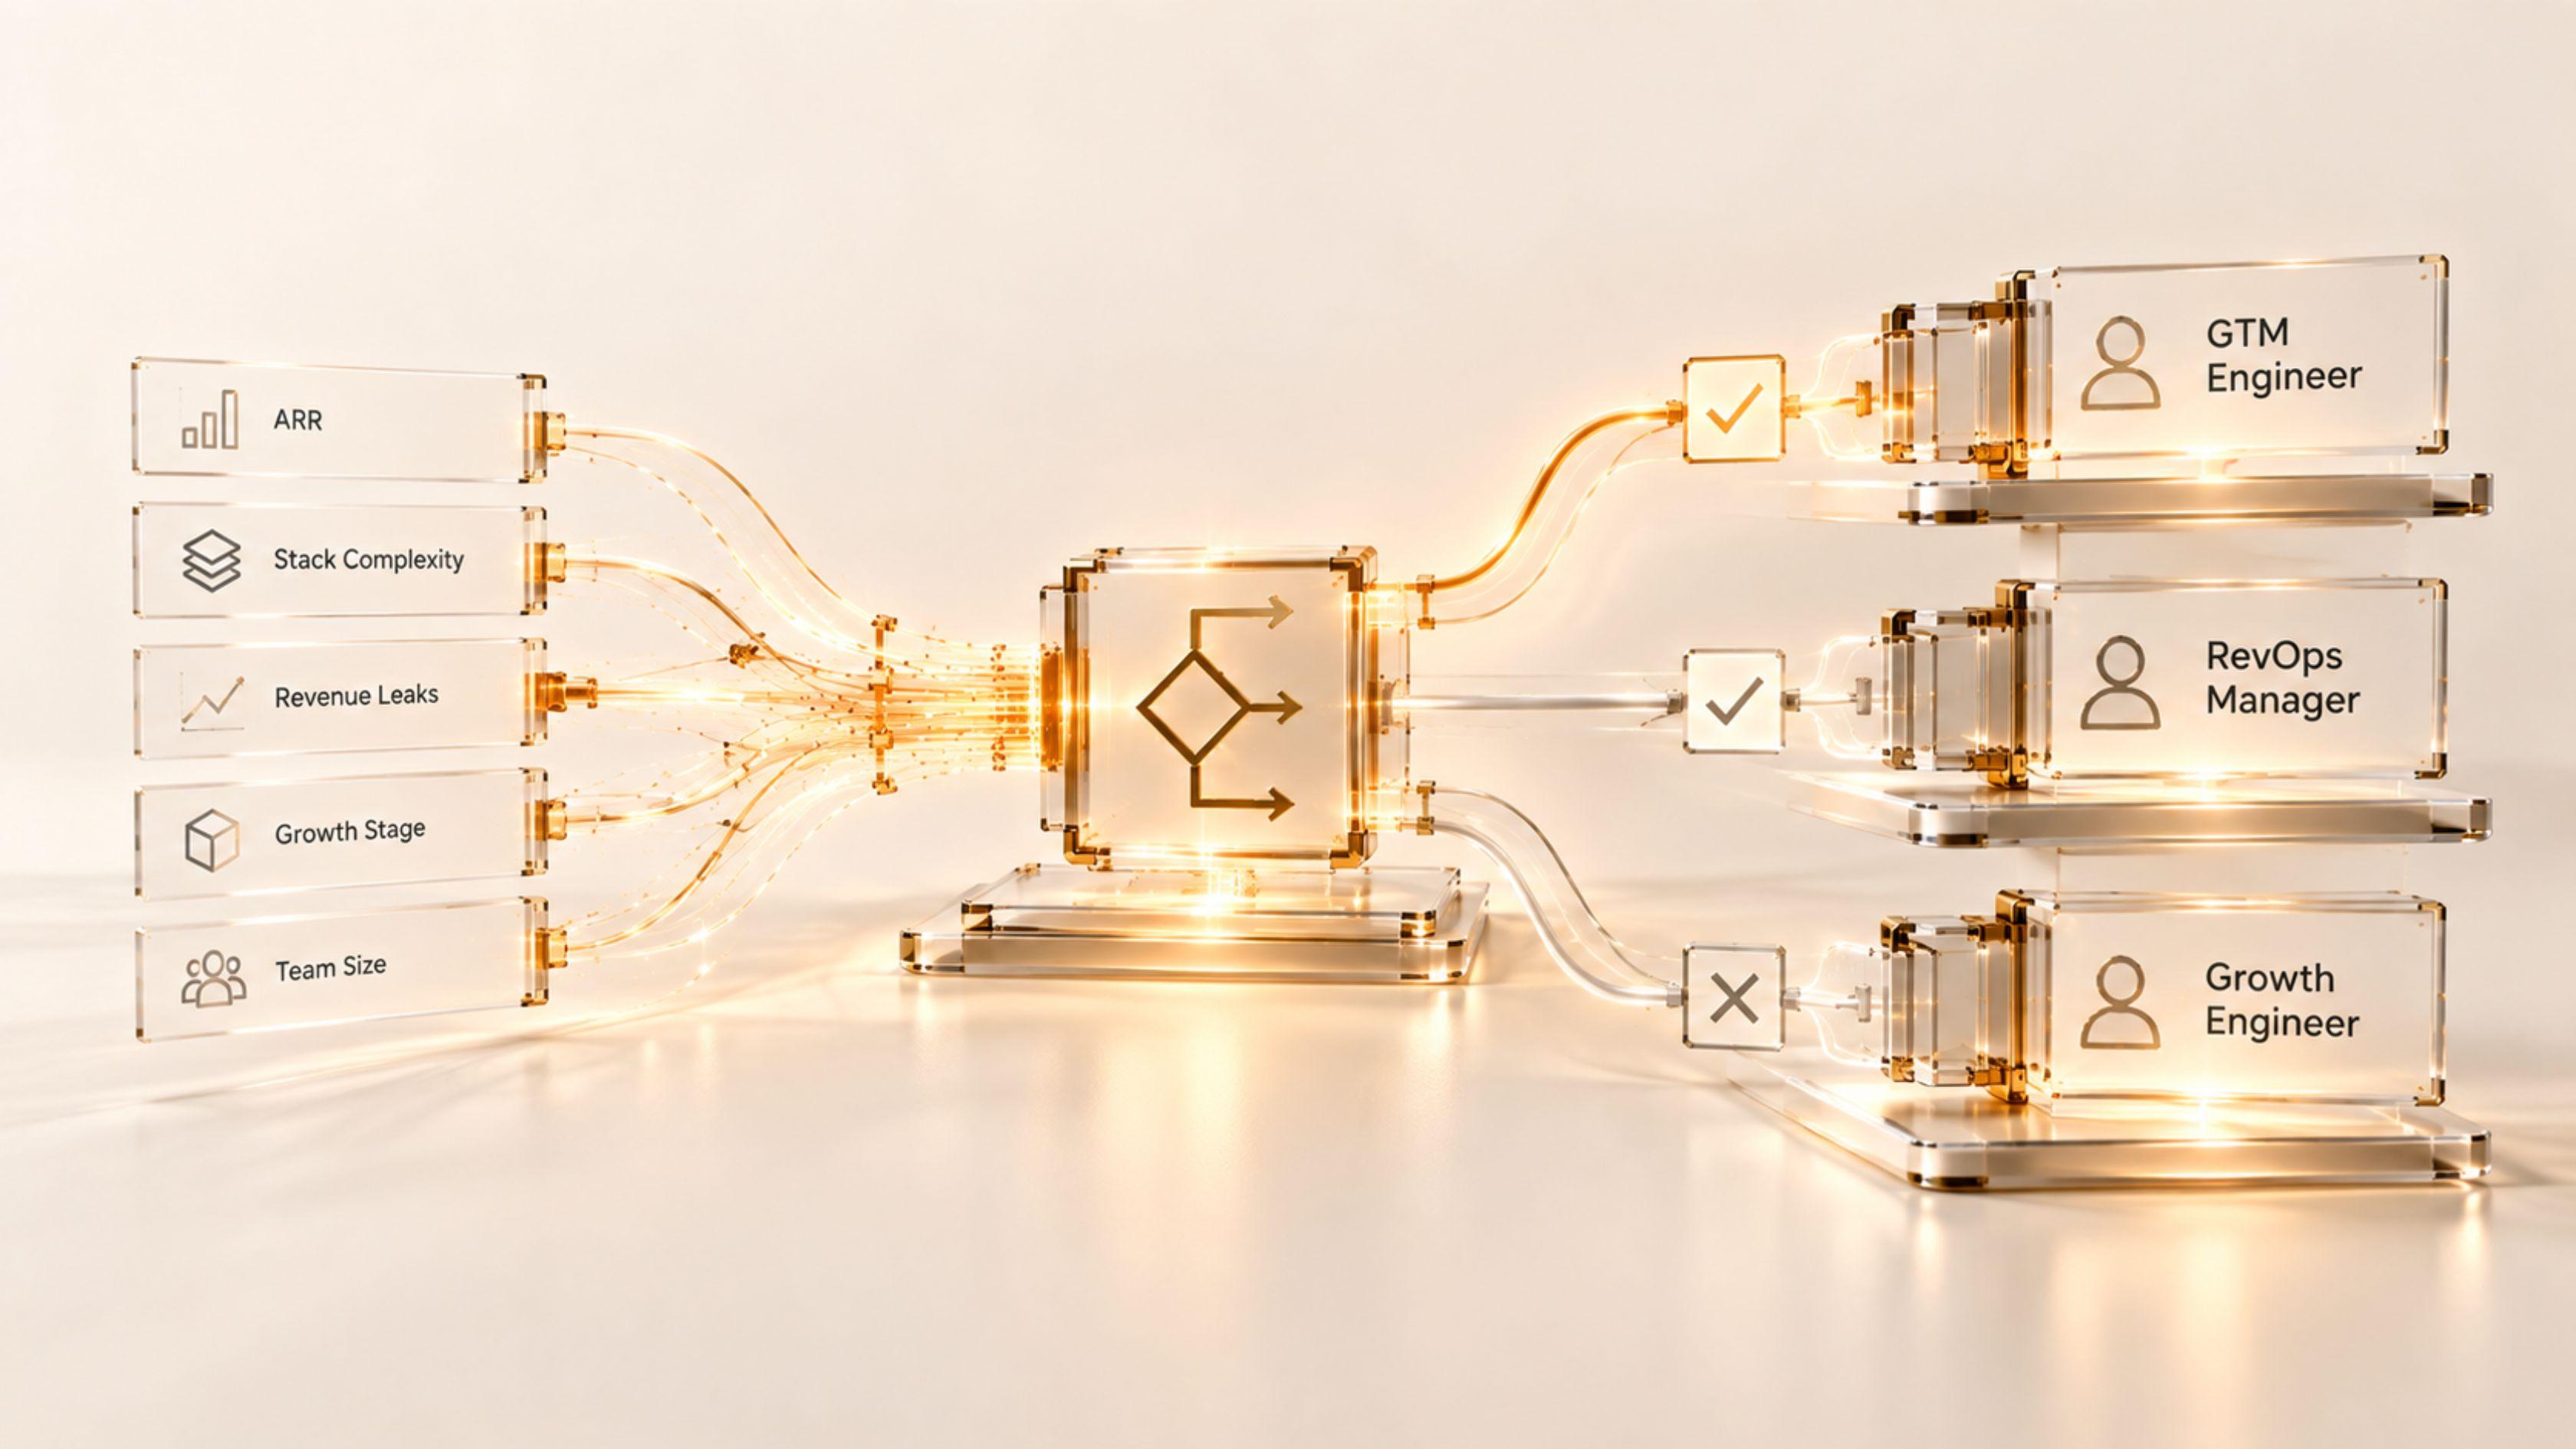
La respuesta honesta para la mayoría de los equipos de ingresos es una combinación: automatización nativa para los casos triviales, una capa iPaaS para orquestar dos o tres sistemas, e ingeniería integrada solo para los sistemas en los que el criterio en condiciones desordenadas importa de verdad: asignación de speed-to-lead con carga real, detección de señales de abandono en datos de uso ruidosos, lógica de previsión que tiene que conciliar lo que dicen los comerciales y los managers.
En producción
Cada regla de orquestación necesita una señal de fallo visible, no silenciosa. Si la tarea de speed-to-lead deja de activarse porque se renombró un campo en una actualización del CRM, la primera persona en darse cuenta no debería ser un comercial tres semanas después preguntándose por qué se secó el pipeline. Crea una comprobación diaria del volumen de eventos: si los eventos lead.speed_to_lead_breach caen a cero o se disparan de forma inesperada, esa es la alerta, antes de que nadie mire las cifras de conversión.
Diseña pensando en que la tarea de sincronización se caiga, no solo en que funcione. Si la capa de resolución de identidades no puede emparejar un lead nuevo con una cuenta existente, el sistema debería enviarlo a una cola de revisión humana, no crear en silencio un duplicado ni descartar el registro sin avisar. Cada capa automatizada necesita un camino explícito de "no lo sé", una alternativa que se degrade con elegancia en lugar de fallar de forma invisible.
Un CRO no necesita ver la lógica del disparador. Necesita una frase: "los leads se asignan en menos de 5 minutos según territorio y puntuación, y esta es la tasa semanal de asignación a tiempo". Cada sistema necesita un resumen para la dirección que remita directamente al contrato de datos subyacente, para que la explicación no se aleje de lo que el sistema hace realmente. Es la misma disciplina que exige un relato de pruebas creíble: tiene que remitir al mecanismo real, no a una historia sobre él.
Dónde encaja en el sistema
La disciplina forward-deployed descrita aquí (primero acceso de lectura, diagnóstico de alcance fijo, construir con datos reales, lanzar con un umbral de funcionamiento, transferir la propiedad) es el modelo operativo detrás de cada uno de los nueve sistemas de VANDFORT, no una metodología aparte añadida encima. Se ve sobre todo en los dos sistemas de GTM Operations más expuestos a los modos de fallo anteriores: el sistema Speed-to-Lead, donde una regla de asignación sin documentar y sin responsable es exactamente el tipo de software que "se queda" solo de nombre, y el Handoff Orchestrator, que existe precisamente porque la lógica de traspaso entre marketing, SDR y AE es la capa que más a menudo queda como conocimiento tribal en lugar de como un contrato de datos documentado. Ambos se construyen tal como este artículo defiende que debería funcionar la ingeniería integrada: con alcance acotado, probados con los datos del propio cliente y lanzados con un umbral definido (el listón declarado de VANDFORT es el 85 por ciento) en lugar de quedar abiertos. Los cofundadores Alejandro Lugo y Mauricio Varela construyeron el modelo de trabajo en torno a esta misma restricción, porque la alternativa es el modo de fallo con el que empezó este artículo: un ingeniero integrado sin límite en su misión.